Search

Results for “Test-Time Training”

Total 3 articles

斯坦福英伟达推出测试时强化学习:微调开源模型胜过顶级闭源模型,仅需几百美元

斯坦福英伟达推出测试时强化学习:微调开源模型胜过顶级闭源模型,仅需几百美元 (opens in a new tab)

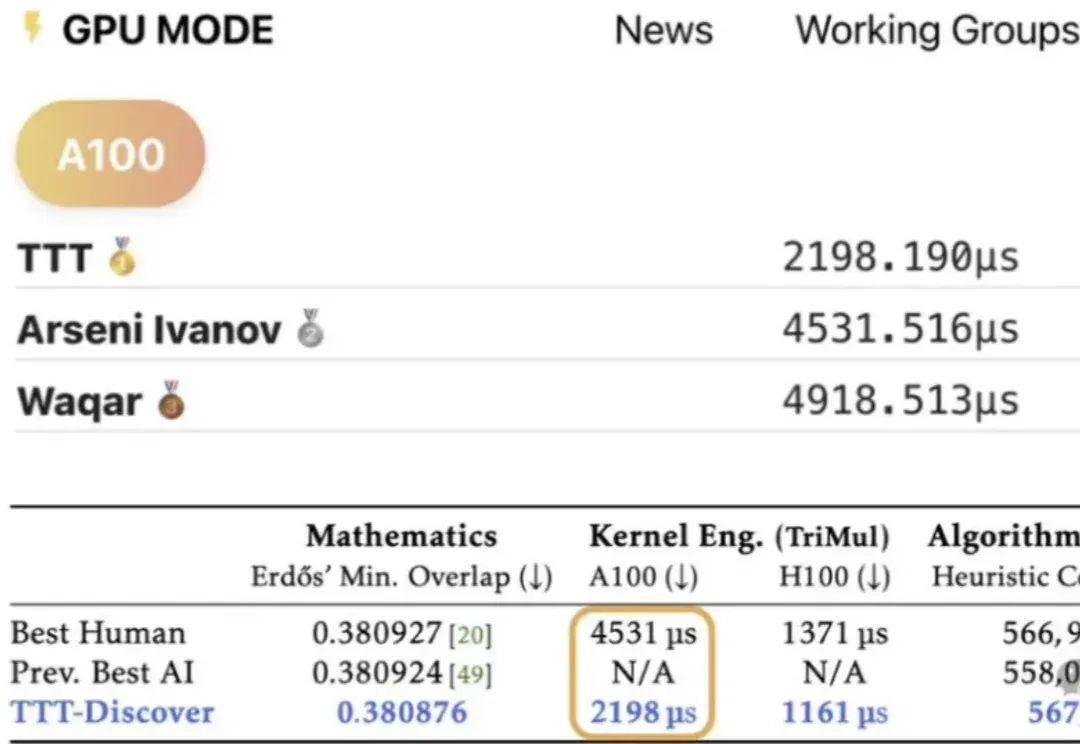
大模型持续学习,又有新进展! 来自斯坦福、英伟达等研究机构的最新研究,针对解决开放的科学问题,提出全新思路—— Test-Time Training to Discover (TTT-Discover)。 其基于开源模型gpt-oss-120b,在多个领域达到SOTA,优于人类专家与闭源前沿模型。 该方法不再沿用“测试时缩放”(Test-time Scaling)只通过Prompt调度冻结模型的做法。 而是在测试阶段,针对单个具体问题,引入强化学习(RL)对模型权重进行更新。 这种“测试时训练”使模型能够从该问题的失败尝试中实时获取经验,更新参数,实现模型能力的定向进化。 数学:给出了Erdő
AI guides
0
全球首个!银河通用新框架仅需人类视频即可部署,特斯拉蚌埠住了

全球首个!银河通用新框架仅需人类视频即可部署,特斯拉蚌埠住了 (opens in a new tab)

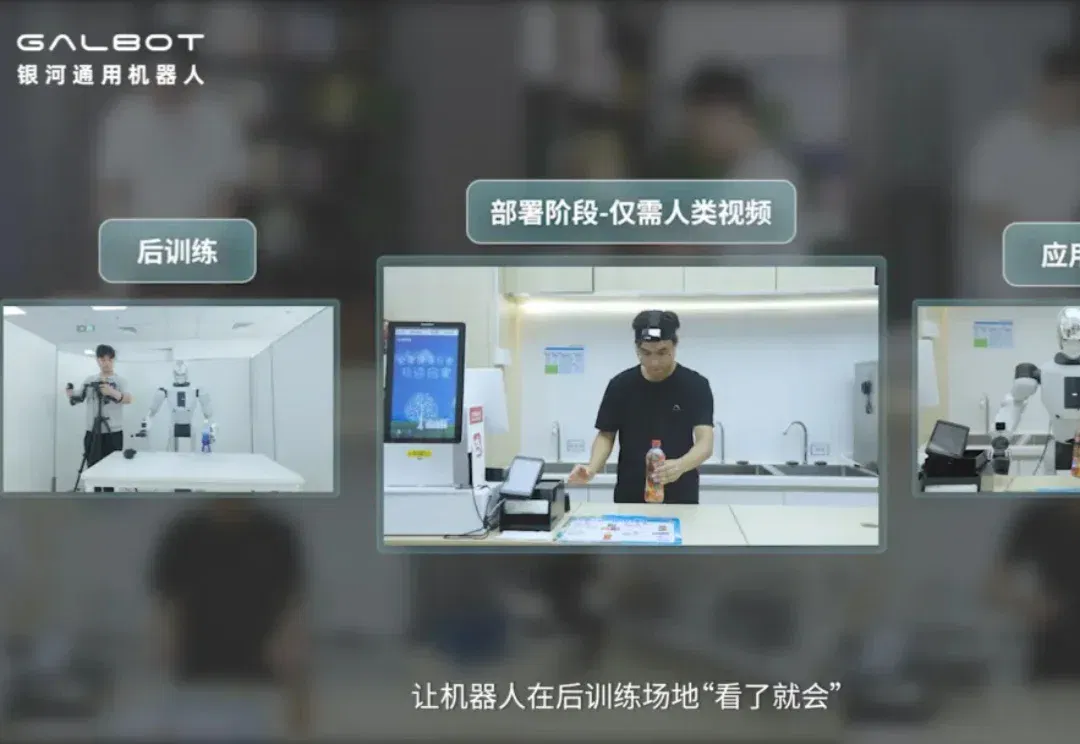
终于,现学现用的风也是吹到了具身智能。 要说这两年,大模型最重要的变化之一,就是越来越不依赖预训练一锤定音,部分能力开始留到推理时刻再兑现。 OpenAI o1如此,DeepSeek-R1也是如此。模型推理能力提升,靠的是在应用过程中的持续自我提升。 但机器人不一样,它面对的是比文本更复杂的物理世界,任意一次误判都有可能损坏抓取对象。想让机器人像大模型一样在部署时进化,行业内一直没有人做到。 直到今天,这条路线第一次被银河通用走通了。  刚刚,银河通用正式发布全球首个面向具身智能大模型的测试时后训练框架WAM‑TTT(World-Action Model Test-Time Training

AI guides
0
刚刚!Ilya首个模型曝光了

刚刚!Ilya首个模型曝光了 (opens in a new tab)

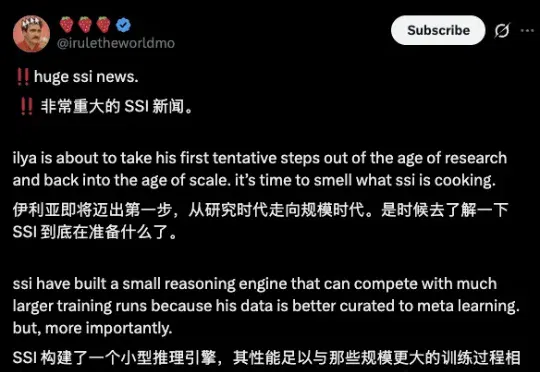
就在刚刚,X上网友「三只草莓」爆料,SSI正在探索一种基于TTT(Test-Time Training,测试时训练)的小型推理引擎。 据其描述,这个模型会用专门整理的数据学习「如何学习」,再在解决问题的过程中更新部分权重。

AI news
0