Agent为什么都在疯狂外挂“Skills”?首个SkillsBench来了,讲透性能暴涨的底层逻辑 (opens in a new tab)
在2026当下的智能体(Agent)开发体系中,“为LLM加Skills”已经成为事实上的行业标准。您的Agent表现不好,是因为底层的LLM参数量不够,还是因为您喂给它的“Skills”写得一塌糊涂?无论是日常使用的各类CLI工具,还是最近的Openclaw,其底层能力的跃升很大程度上都依赖于这些特定领域的Agent Skills。
Total 4 articles
在2026当下的智能体(Agent)开发体系中,“为LLM加Skills”已经成为事实上的行业标准。您的Agent表现不好,是因为底层的LLM参数量不够,还是因为您喂给它的“Skills”写得一塌糊涂?无论是日常使用的各类CLI工具,还是最近的Openclaw,其底层能力的跃升很大程度上都依赖于这些特定领域的Agent Skills。
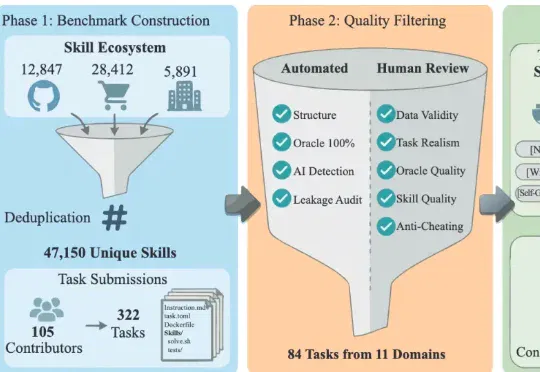
近日,一篇名为《SkillsBench: Benchmarking How Well Agent Skills Work Across Diverse Tasks》的论文预印本引爆了海外 AI 社区,YC 总裁 Garry Tan 亲自转发,登顶 Hacker News(363 票 / 163 评论),霸榜 AlphaXiv #1,
Qwen3.6系列全员集结完毕。 智东西4月23日报道,昨晚,阿里通义千问团队宣布开源Qwen3.6-27B——一款270亿参数的稠密多模态模型,支持思考与非思考模式。 与阿里上一代开源模型Qwen3.5-397B-A17B相比,Qwen3.6-27B以1/15的参数规模,在SWE-bench Verified、SWE-bench Pro、Terminal-Bench 2.0以及 SkillsBench上实现了反超,其编程能力提升明显,同时还具备较强的文本和多模态推理能力。 与相似尺寸的Gemma 4-31B模型对比,Qwen3.6-27B在大部分维度上,展现出较大领先优势。 随着Qwen3.
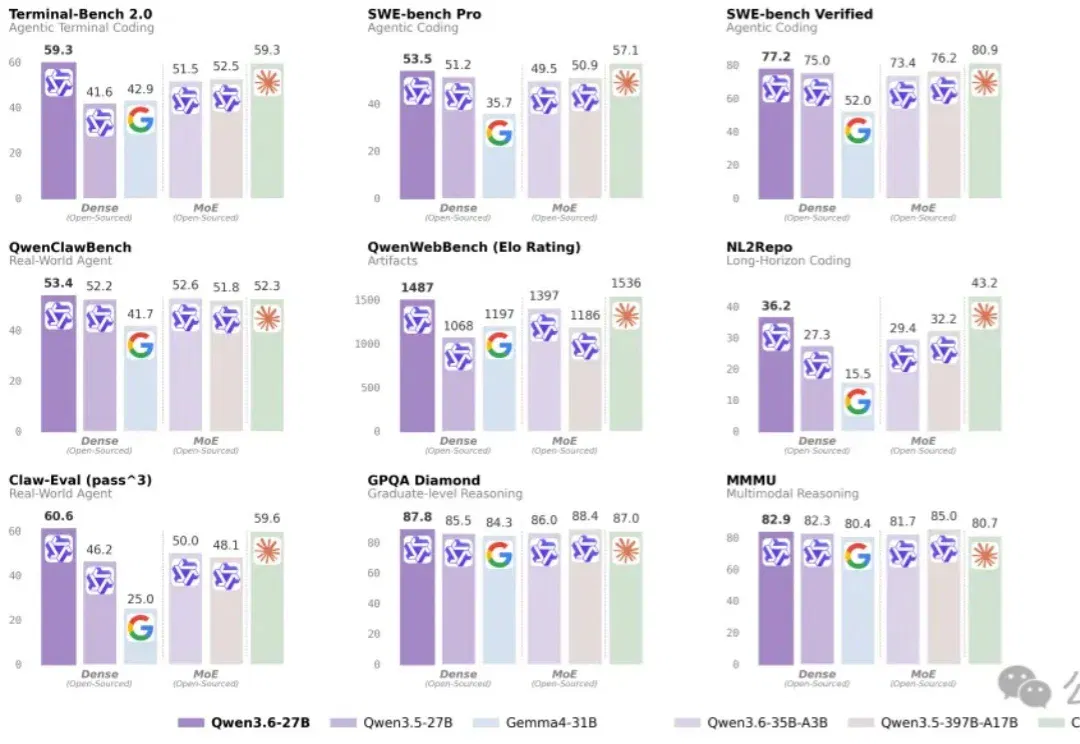
我秒了我自己?? 阿里Qwen团队刚开源的Qwen3.6-27B,直接把自家前代旗舰Qwen3.5-397B给卷没了。 在四大智能体编程基准上全面超越,只用了前代大概1/15的参数量。 从成绩单来看,除了智能体编程基准的集体领先,单项差距也比较明显,SkillsBench从老旗舰的30.0直接干到48.2,差距拉开超60%。 而且,和Qwen3.5-397B的MoE不同,Qwen3.6-27B采用的是纯密集架构。 架构简洁、部署简单、推理稳定,普通开发者拿过来就能跑,不用折腾一堆配置。 27B也不虚 Qwen3.6-27B专门对智能体编程做了一波狠优化。 模型在训练中强化了代码库理解、跨文件编