EMNLP 2026 Main|浙大&北大团队提出SPADER:用step-wise GRPO与多样性感知奖励驱动多答案问答长尾探索 (opens in a new tab)
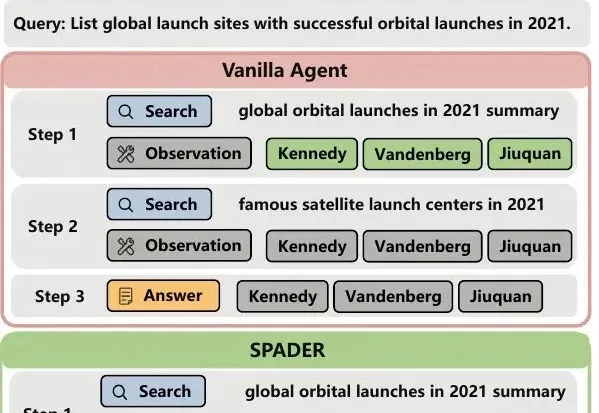
一句话概括:多答案问答要求智能体找全整个答案集合,而不是只搜到一个就停止。现有 RL 方法在此场景下存在两处错位:优势计算停留在轨迹级,信用分配粗糙;F1 奖励对头部与长尾实体一视同仁,智能体缺乏探索长尾的动力。
Total 1 articles
一句话概括:多答案问答要求智能体找全整个答案集合,而不是只搜到一个就停止。现有 RL 方法在此场景下存在两处错位:优势计算停留在轨迹级,信用分配粗糙;F1 奖励对头部与长尾实体一视同仁,智能体缺乏探索长尾的动力。