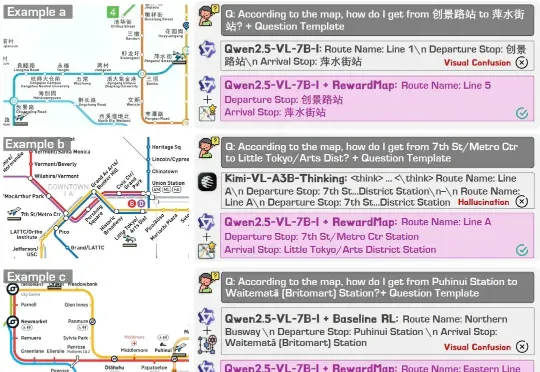
RewardMap: 通过多阶段强化学习解决细粒度视觉推理的Sparse Reward (opens in a new tab)近年来,大语言模型(LLMs)以及多模态大模型(MLLMs)在多种场景理解和复杂推理任务中取得突破性进展。