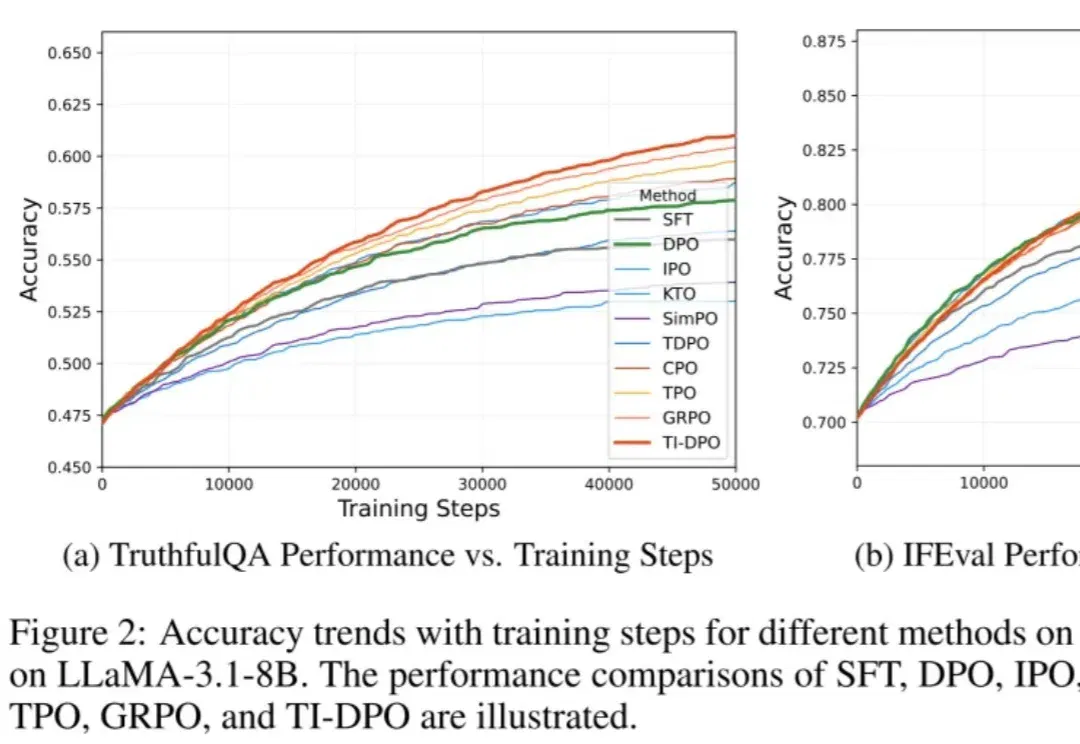
ICLR 2026 Oral | DPO「只看总分不看细节」?TI-DPO用Token重要性重塑大模型对齐 (opens in a new tab)
在当今的大模型后训练(Post-training)阶段,DPO(直接偏好优化) 凭借其无需训练独立 Reward Model 的优雅设计和高效性,成功取代 PPO 成为业界的 「版本之子」,被广泛应用于 Llama-3、Mistral 等顶流开源模型的对齐中。
Total 16 articles
在当今的大模型后训练(Post-training)阶段,DPO(直接偏好优化) 凭借其无需训练独立 Reward Model 的优雅设计和高效性,成功取代 PPO 成为业界的 「版本之子」,被广泛应用于 Llama-3、Mistral 等顶流开源模型的对齐中。
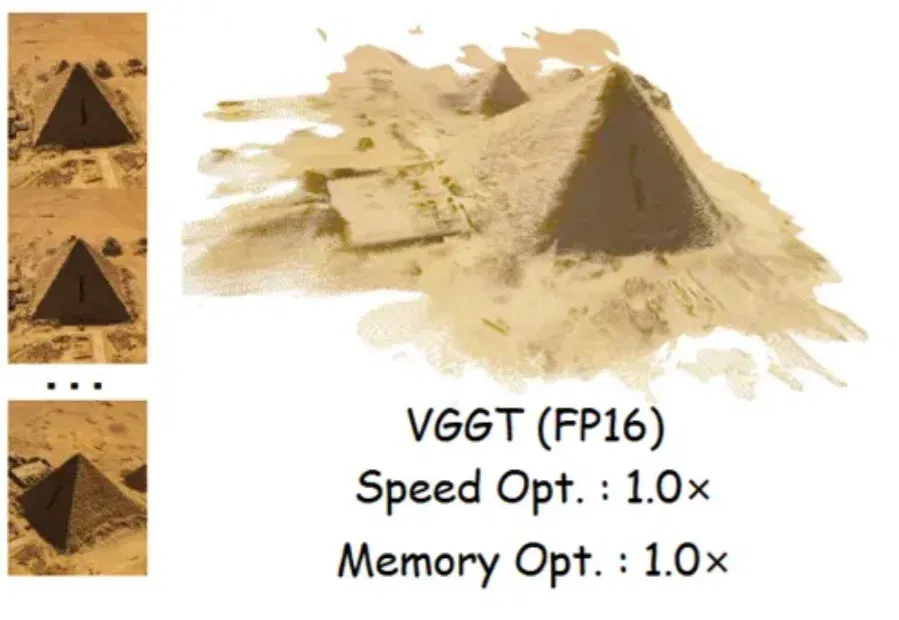
十亿参数的三维重建模型,能塞进手机吗? 以前想都不敢想——VGGT这样的庞然大物,单次前向传播就能完成深度估计、点云回归、相机预测多个任务,但部署成本高得吓人。 现在,一个名为QuantVGGT的量化框架给出了答案:4比特量化,速度提升2.5倍,内存减少3.7倍,精度保住98%。 近年来,以视觉几何基础Transformer(Visual Geometry Grounded Transformers, VGGT)为代表的基于学习的三维重建模型,借助大规模Transformer取得了显著进展。 然而,其极高的计算和内存成本严重阻碍了在实际场景中的部署。训练后量化(Post-Training Qu
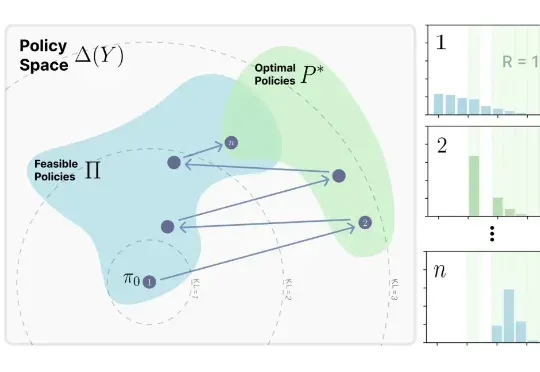
来自MIT Improbable AI Lab的研究者们最近发表了一篇题为《RL's Razor: Why Online Reinforcement Learning Forgets Less》的论文,系统性地回答了这个问题,他们不仅通过大量实验证实了这一现象,更进一步提出了一个简洁而深刻的解释,并将其命名为 “RL's Razor”(RL的剃刀)。
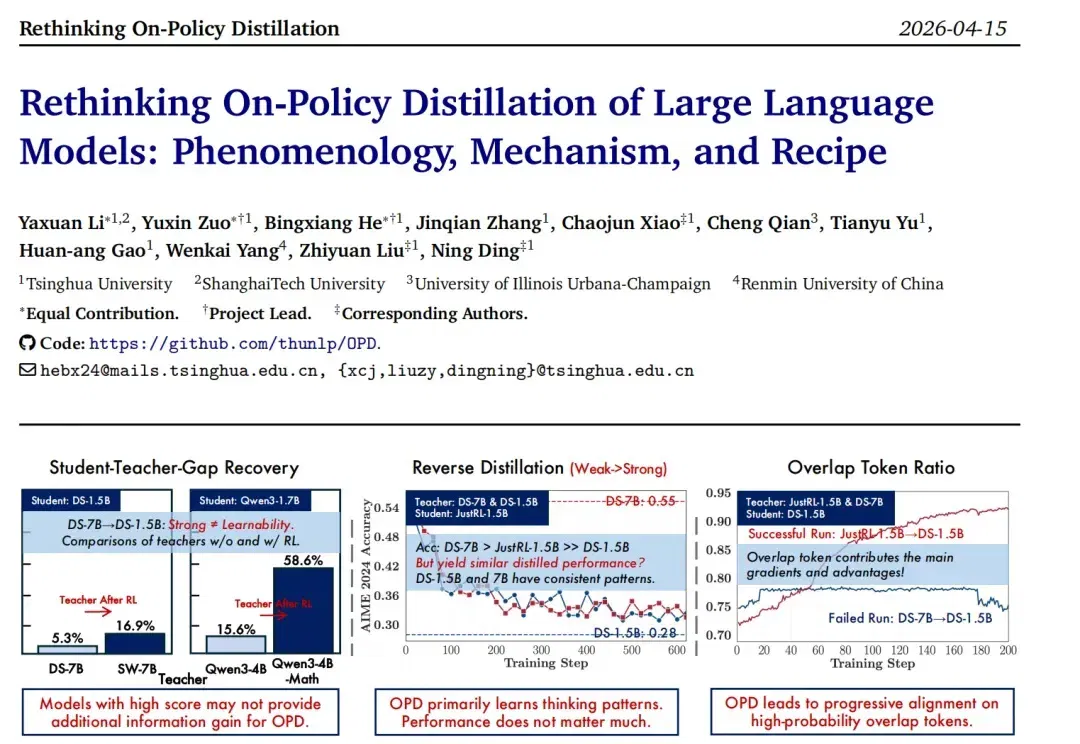
当下的大模型后训练(Post-training)pipeline 中,On-Policy Distillation(OPD)已经成为了明星技术。从 Qwen3、MiMo 到 GLM-5,业界纷纷采用 OPD 并报告了巨大的性能提升。相比于强化学习(RL)稀疏的结果奖励,OPD 提供了密集的 Token 级别监督信号,看起来就像是一顿「免费的午餐」。
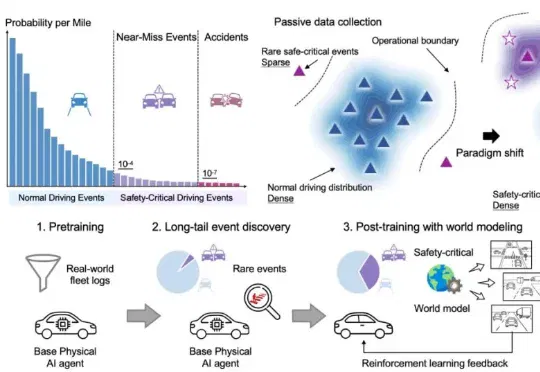
香港大学李弘扬团队联合华为、上海创智学院及清华大学李升波教授团队,发表的最新论文World Engine: Towards the Era of Post-Training for Autonomous Driving给出了系统回答。
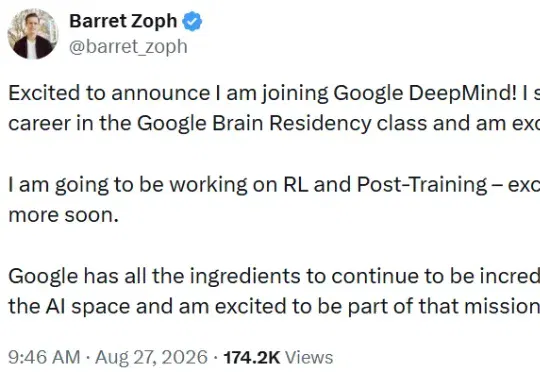
几个小时前,Barret Zoph 在 𝕏 上发了一条推文,他说自己将加入谷歌 DeepMind,而他的 AI 生涯正是从谷歌 Brain 的 Residency 项目起步的,这次算是重返旧地;他将专注于强化学习(RL)与后训练(Post-Training)方向,更多消息稍后公布;他还补了一句,谷歌拥有在 AI 领域持续成功所需要的全部要素,他很高兴能成为这个使命的一部分。
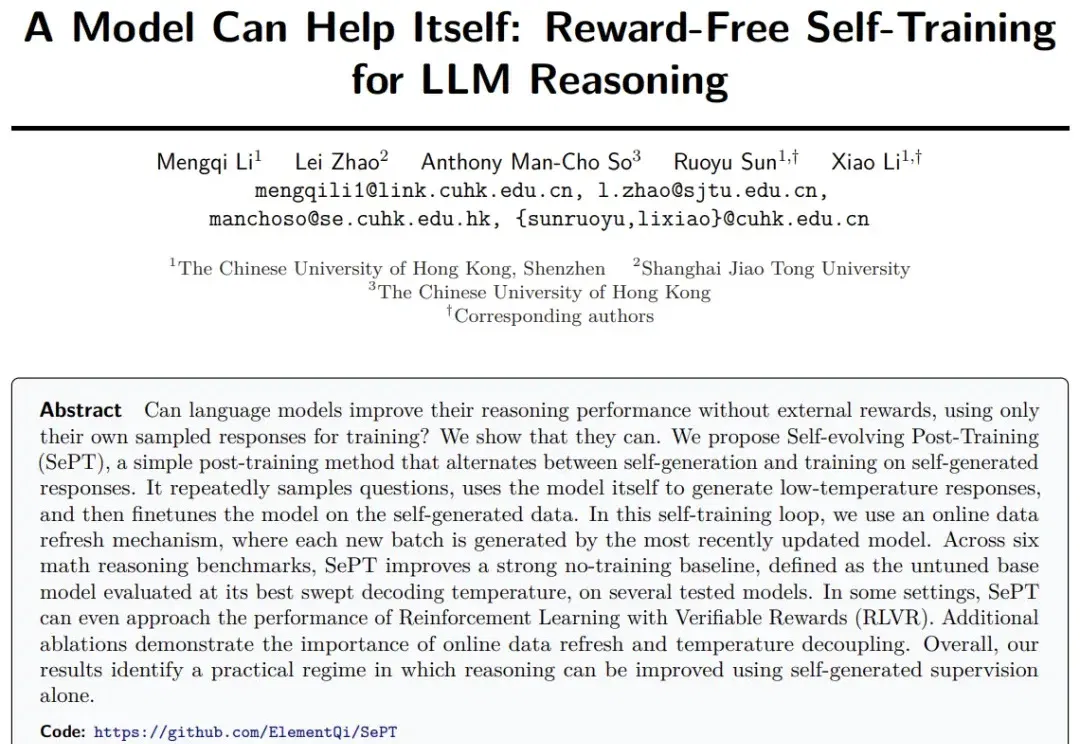
在推理后训练里,多数方法仍依赖奖励模型、验证器或额外教师信号。如果不依赖这些外部信号,只使用模型自身生成的答案进行自训练,是否仍然能够提升推理能力?是的!SePT(Self-evolving Post-Training)给出肯定答案,简洁的自训练方法,可在数学推理任务准确率直升10个点!
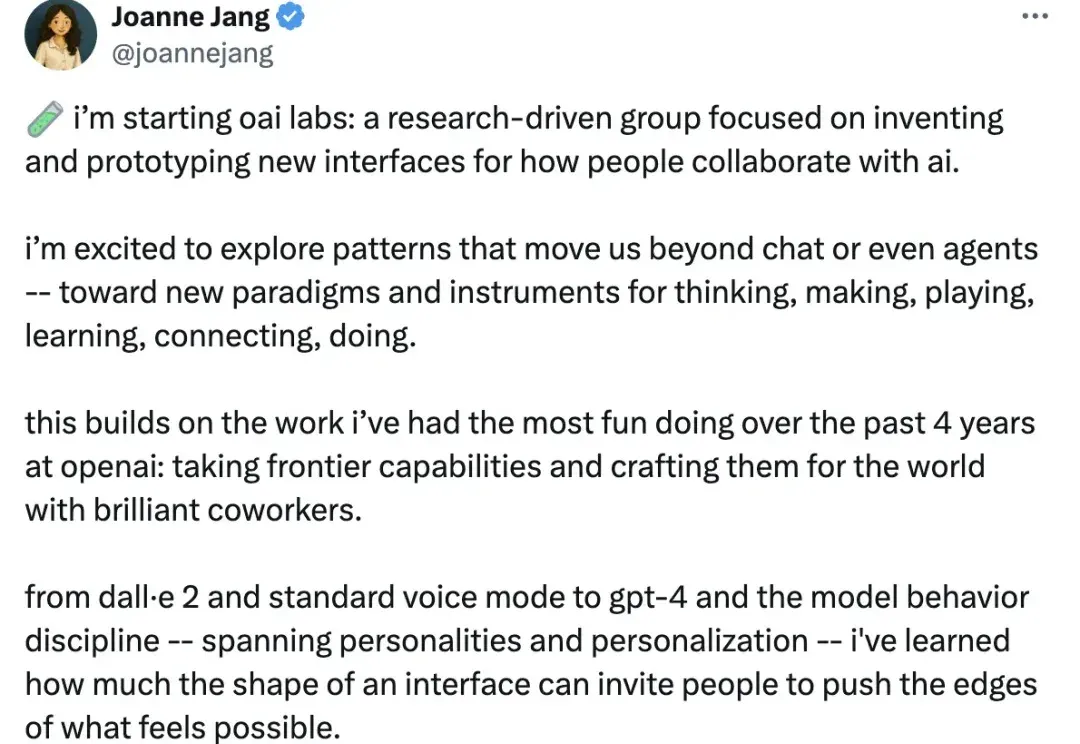
OpenAI又要成立新团队了! TechCrunch消息,OpenAI正在对其模型行为(Model behavior)团队进行重组。 模型行为团队,就是OpenAI内部专门塑造模型“个性”的核心研究小组。迄今已参与GPT-4、GPT-4o、GPT-4.5与GPT-5等版本的后训练工作。 随着重组的进行,其创始负责人Joanne Jang,也正在组建一个名为OAI Labs的新研究团队。 Joanne介绍,OAI Labs的职责是探索人与AI协作的新范式。 这是一个以研究为导向的团队,专注于发明和设计人们与人工智能协作的新接口。 OpenAI成立OAI Labs 作为模型行为团队改组行动的一部分
OpenAI重磅结构调整:ChatGPT「模型行为」团队并入Post-Training,前负责人Joanne Jang负责新成立的OAI Labs。而背后原因,可能是他们最近的新发现:评测在奖励模型「幻觉」,模型被逼成「应试选手」。一次组织重组+评测范式重构,也许正在改写AI的能力边界与产品形态。
上海交通大学卢策吾、汶川团队联合穹彻提出LIFT(Late Reactive Injection of Force for VLA Post-Training),被CoRL 2026高分收录,该方法在保留预训练知识的前提下,仅通过20至30条在线带力数据后训练即可让VLA学会力反馈,显著提升叠毛巾、插书、汉诺塔圆环放置等接触密集型任务表现。