LLM首次达到人类语言专家水平!OpenAI o1拿下拆解句法、识别歧义、推理音律 (opens in a new tab)
这说明o1不仅能够使用语言,还能够思考语言,具备元语言能力(metalinguistic capacity )。由于语言模型只是在预测句子中的下一个单词,人对语言的深层理解在质上有所不同。因此,一些语言学家表示,大模型实际上并没有在处理语言。
Total 5 articles
这说明o1不仅能够使用语言,还能够思考语言,具备元语言能力(metalinguistic capacity )。由于语言模型只是在预测句子中的下一个单词,人对语言的深层理解在质上有所不同。因此,一些语言学家表示,大模型实际上并没有在处理语言。
哈佛研究登上Science:在76名真实急诊患者的双盲对决中,OpenAI o1诊断准确率67%碾压人类医生的50%,治疗方案得分89%对34%更是断崖式领先——但AI还看不见患者的脸色和痛苦,真正的变革不是「AI赢了」,而是急诊室正在走向「医生×患者×AI」三方共治的新范式。
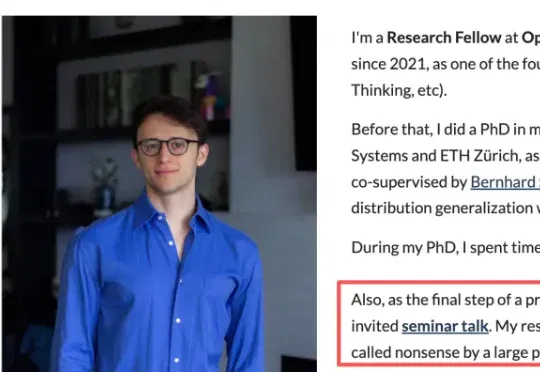
2020 年,他去 MIT 面试教授岗位,做了一场关于用 GPT 做推理的报告。结果,面试委员会大部分教授把这个方向斥为「无稽之谈」(nonsense)。这哥们直接贴脸开大,将这段经历写进了个人主页,并附上了当年的报告介绍和幻灯片链接。
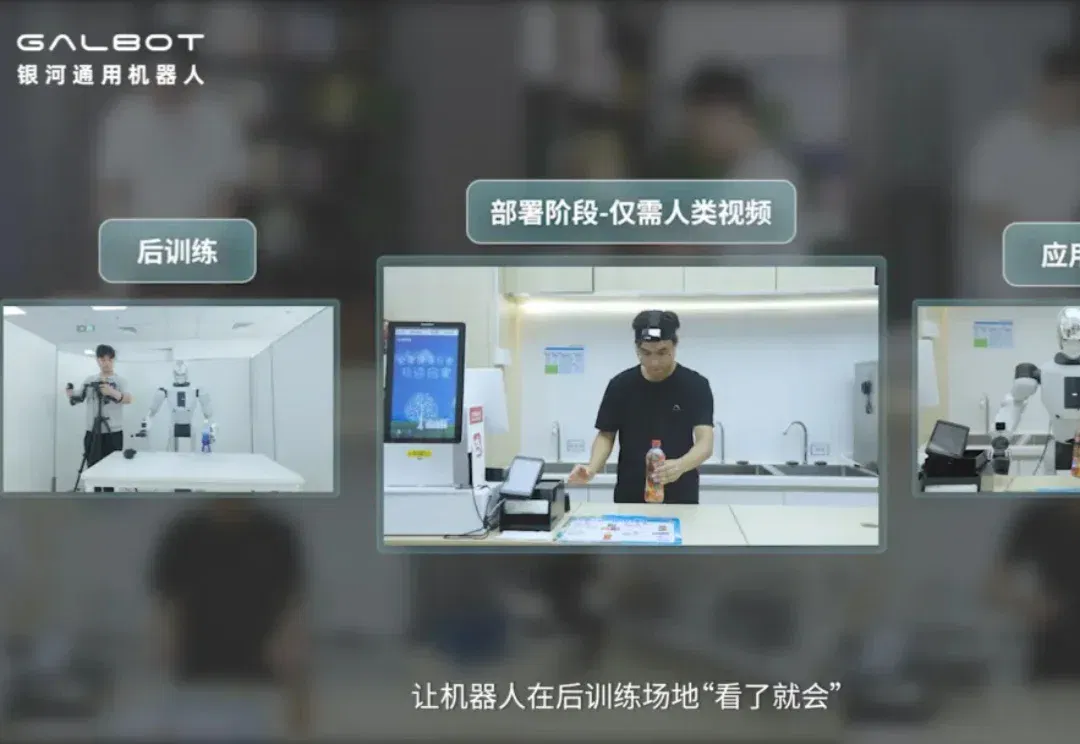
终于,现学现用的风也是吹到了具身智能。 要说这两年,大模型最重要的变化之一,就是越来越不依赖预训练一锤定音,部分能力开始留到推理时刻再兑现。 OpenAI o1如此,DeepSeek-R1也是如此。模型推理能力提升,靠的是在应用过程中的持续自我提升。 但机器人不一样,它面对的是比文本更复杂的物理世界,任意一次误判都有可能损坏抓取对象。想让机器人像大模型一样在部署时进化,行业内一直没有人做到。 直到今天,这条路线第一次被银河通用走通了。 刚刚,银河通用正式发布全球首个面向具身智能大模型的测试时后训练框架WAM‑TTT(World-Action Model Test-Time Training
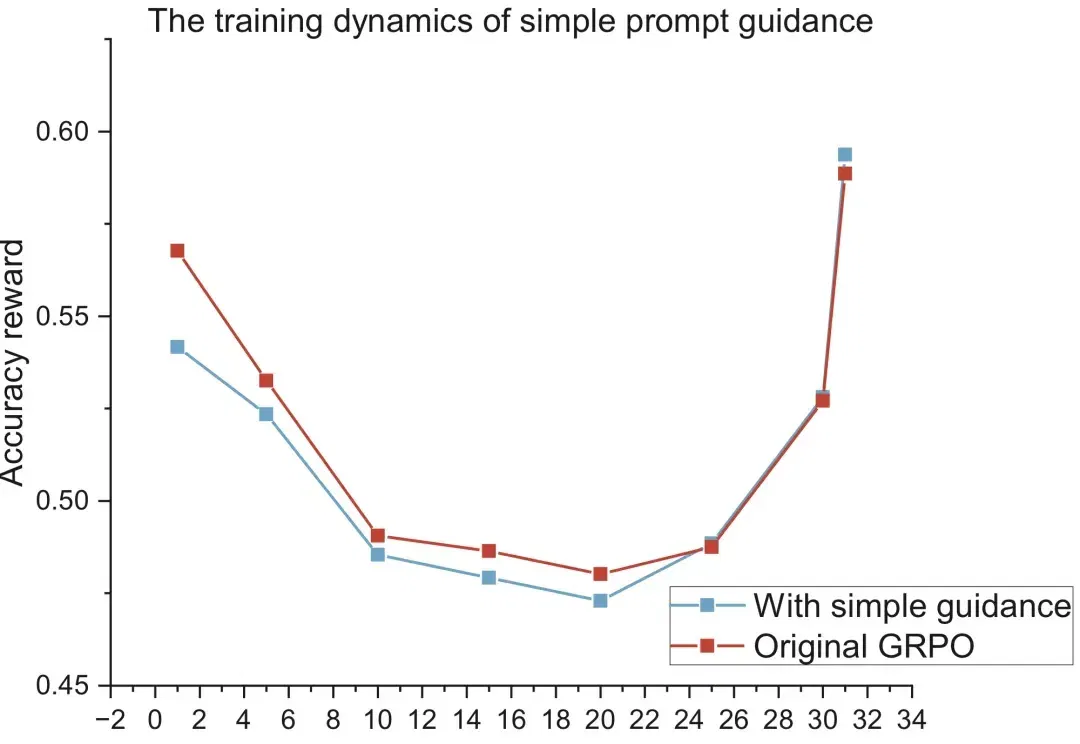
大模型时代的「炼金术师」们,或许都曾面临一个共同的困扰:当我们试图将 DeepSeek-R1、OpenAI-o1 那种惊艳的推理能力迁移到小规模语言模型(SLMs)时,效果却总是差强人意。现有的强化学习方法如 GRPO 在 7B+ 的大模型上效果显著,但一旦应用到 1.7B 甚至更小参数的模型上,性能提升就微乎其微。