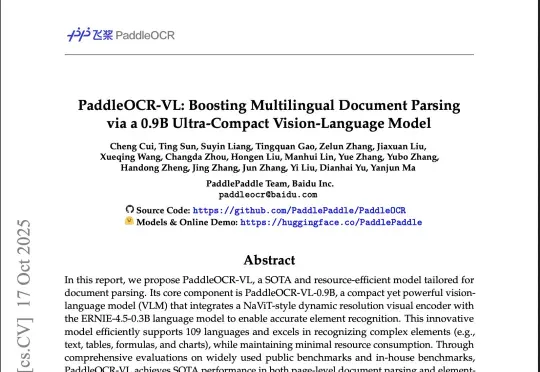
只有0.9B的PaddleOCR-VL,却是现在最强的OCR模型。 (opens in a new tab)
整个Hugging Face的趋势版里,前4有3个OCR,甚至Qwen3-VL-8B也能干OCR的活,说一句全员OCR真的不过分。然后在我上一篇讲DeepSeek-OCR文章的评论区里,有很多朋友都在把DeepSeek-OCR跟PaddleOCR-VL做对比,也有很多人都在问,能不能再解读一下百度那个OCR模型(也就是PaddleOCR-VL)。
Total 5 articles
整个Hugging Face的趋势版里,前4有3个OCR,甚至Qwen3-VL-8B也能干OCR的活,说一句全员OCR真的不过分。然后在我上一篇讲DeepSeek-OCR文章的评论区里,有很多朋友都在把DeepSeek-OCR跟PaddleOCR-VL做对比,也有很多人都在问,能不能再解读一下百度那个OCR模型(也就是PaddleOCR-VL)。
前不久我写了一篇百度最新的OCR模型(PaddleOCR-VL)的文章反响还不错。
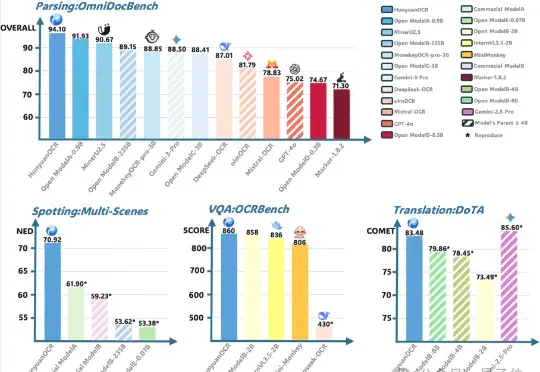
腾讯混元大模型团队正式发布并开源HunyuanOCR模型!这是一款商业级、开源且轻量(1B参数)的OCR专用视觉语言模型,模型采用原生ViT和轻量LLM结合的架构。目前,该模型在抱抱脸(Hugging Face)趋势榜排名前四,GitHub标星超过700,并在Day 0被vllm官方团队接入。
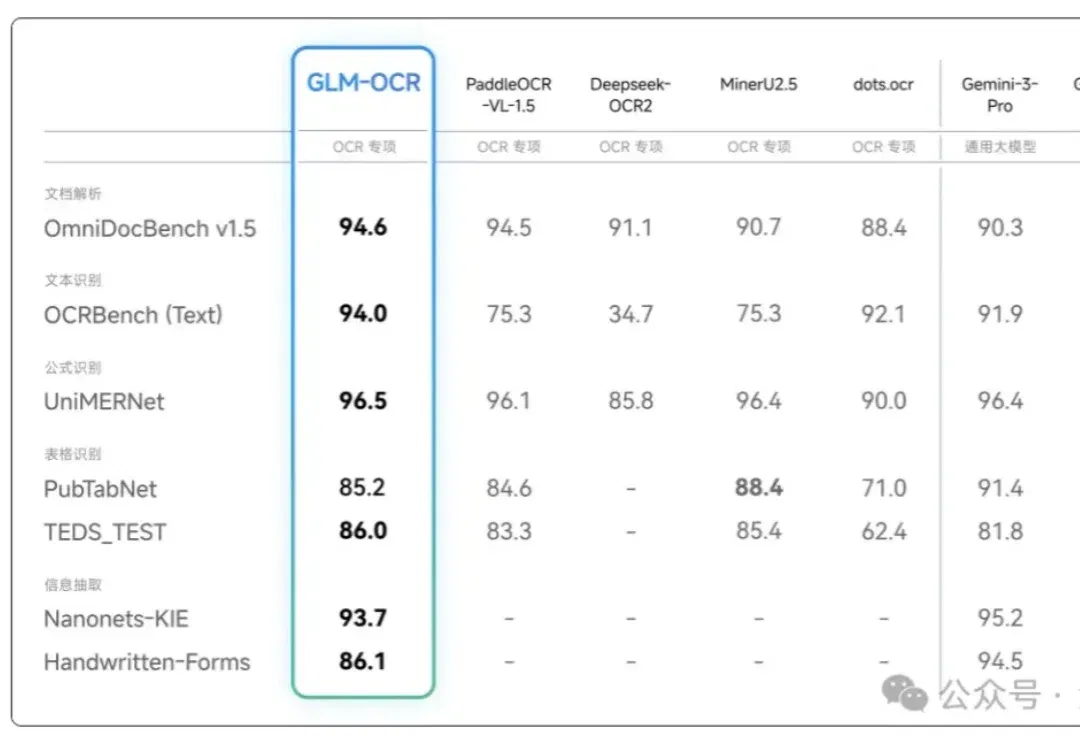
OCR模型究竟能干什么?干得怎么样? 2025年末2026年年初,科技圈最卷的技术无疑就是——O!C!R! 这不,就在前两天,智谱也下场整活儿了,发布了自家的「GLM-OCR」开源模型~ 别看参数就0.9B,在OmniDocBench V1.5榜单上可是一通乱杀。 拳打Gemini-3-Pro!脚踢GPT5.2!(开玩笑 在手写体、代码文档、印章识别、跨单元格等场景的性能表现直通SOTA: 这两天处于工作的原因,我也深度上手使用了GLM-OCR一番,这波用下来的感受是: 在日常基础文档解析场景里用起来确实爽爽爽! but,涉及到字迹不清晰或复杂排版的信息时,翻车现象还是有的…… 顺带,帮友友们
前DeepSeek核心研究员魏浩然近日带队加入百度基础模型研发部,出任文心大模型多模态算法负责人,负责端到端OCR等方向,其此前主导的Unlimited OCR模型曾在OmniDocBench评测中取得全球第一。