英伟达成美国大模型开源标杆:Nemotron 3连训练配方都公开,10万亿token数据全放出 (opens in a new tab)
英伟达在开源模型上玩的很激进: “最高效的开放模型家族”Nemotron 3,混合Mamba-Transformer MoE架构、NVFP4低精度训练全用上。而且开放得很彻底:
Total 9 articles
英伟达在开源模型上玩的很激进: “最高效的开放模型家族”Nemotron 3,混合Mamba-Transformer MoE架构、NVFP4低精度训练全用上。而且开放得很彻底:
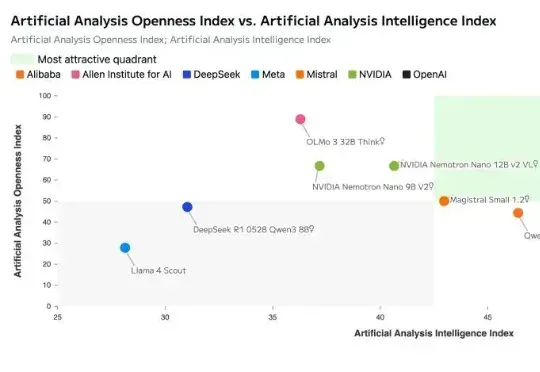
就在刚刚,英伟达正式开源发布了其新一代AI模型:NVIDIA Nemotron 3。Nemotron 3 系列由三种型号组成:Nano、Super 和 Ultra。官方介绍其具备强大的智能体、推理和对话能力。
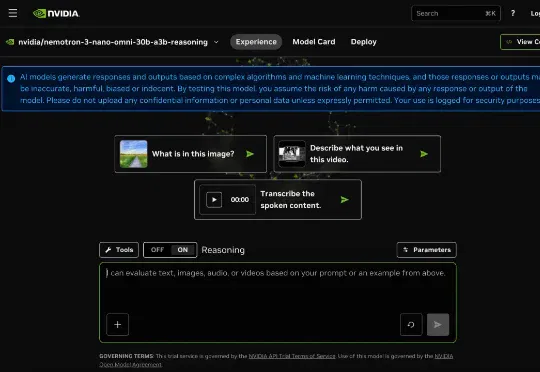
英伟达于昨日正式推出全新多模态推理模型Nemotron 3 Nano Omni,将文本、视觉、语音三大模态能力深度融合至单一模型体系,目前可免费使用。
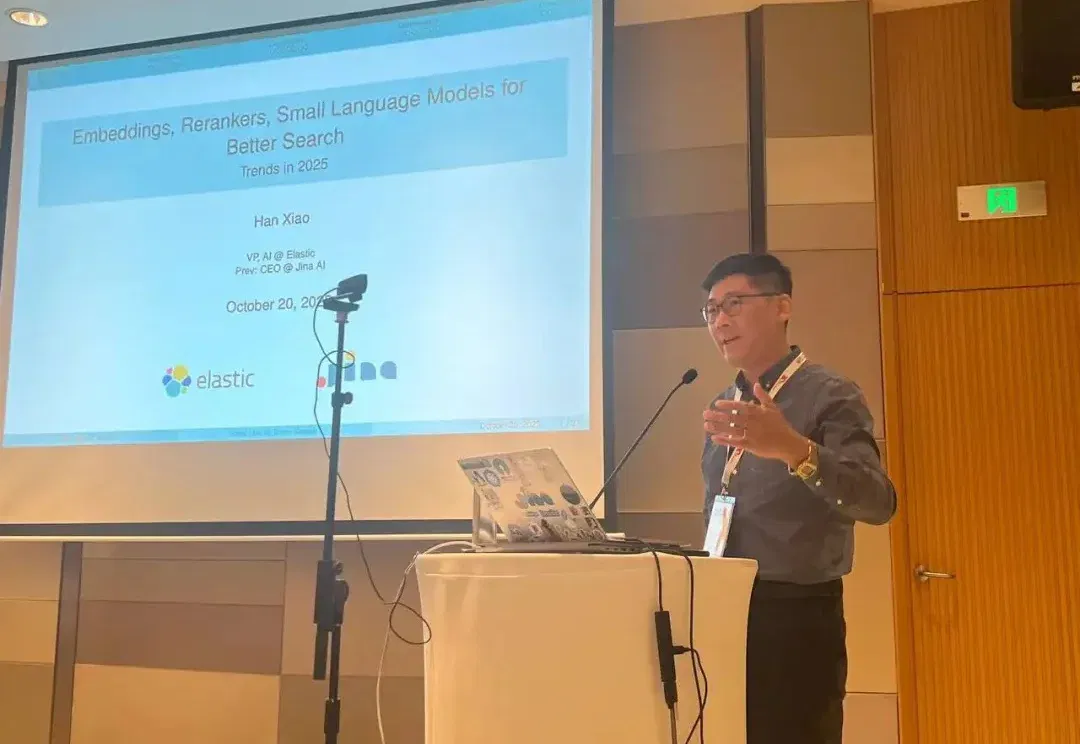
Google 最近发了 Gemini Embedding 2,他们第一个原生多模态向量模型。文本、图像、视频、音频、文档,全部映射到同一个 3072 维向量空间。这是 Omni Embedding(全模态向量模型)的大趋势:一个架构吃下所有模态,从 jina-embeddings-v4 到 Omni-Embed-Nemotron 再到 Omni-5,大家都在往这个方向收敛。
由两名00后大学生创办的美国AI训练数据公司AfterQuery五个月内估值从3亿美元升至32亿美元,其数据已用于英伟达Nemotron 3 Ultra模型训练,并与Thinking Machines Lab、Legora及部分中国AI实验室合作。
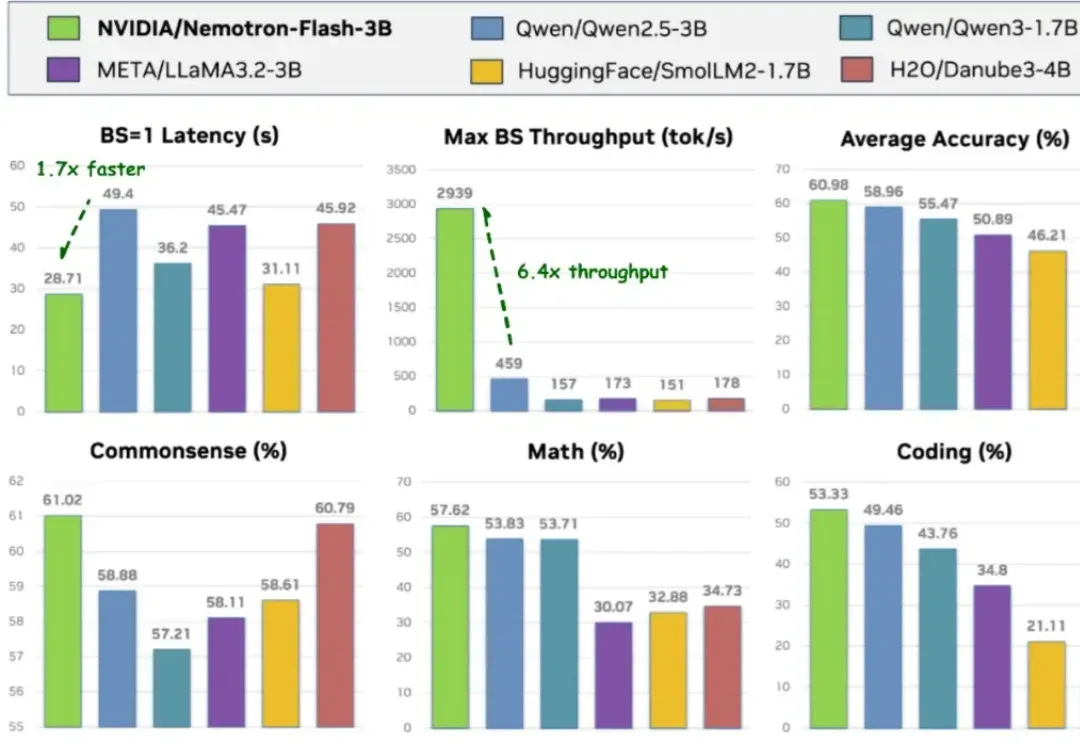
导读 过去两年,小语言模型(SLM)在业界备受关注:参数更少、结构更轻,理应在真实部署中 “更快”。但只要真正把它们跑在 GPU 上,结论往往令人意外 —— 小模型其实没有想象中那么快。
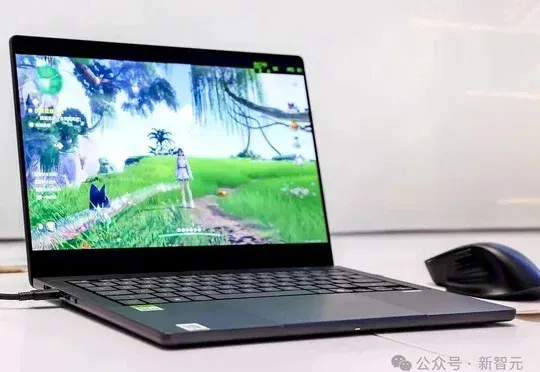
英伟达开放Nemotron 3.5 Bolt模型权重,将740亿参数版本从约148GB压缩至22.1GB以支持笔记本本地Agent任务,搭载RTX Spark的联想、微软等笔记本也于10月16日全球发售。
老黄,真的不甘心只做卖铲人了! 就在今天,多家外媒爆料,英伟达计划斥资60亿美元(约合430亿人民币),打造全球地表最强的开源权重AI模型! 英伟达,果然不装了,现在,他们开始自己下场包揽金矿。 为了实现这个野心,老黄祭出一整套连环招。 首先,他砸下60亿美元,买下AI初创公司Poolside的「模型工厂」技术。 接着,他狂挖核心团队,直接邀请Poolside的109名核心工程师入职,全员并入英伟达Nemotron项目。 最后,他豪掷10亿美元,以高达120亿美元的投前估值,向Poolside追加一笔巨额投资! 这一套行云流水的组合拳下来,直接三下五除二完成了一场「软收购」。 圈内震撼了:AI
OpenClaw又迎重磅玩家!英伟达深夜带着Nemotron 3 Super炸场,1200亿参数专为Agent打造,性能直逼Claude Opus 4.6。推理狂飙3倍,吞吐量猛涨5倍,「龙虾」这是要上天了。