NeRF之父斩获「青年图灵奖」!重写3D世界的人赢了 (opens in a new tab)
计算机界「青年图灵奖」出炉了!今天,2025 ACM Grace Hopper大奖正式揭晓,一锤砸中了两位灵魂人物——获奖理由只有一个词:NeRF(神经辐射场)。
Total 8 articles
计算机界「青年图灵奖」出炉了!今天,2025 ACM Grace Hopper大奖正式揭晓,一锤砸中了两位灵魂人物——获奖理由只有一个词:NeRF(神经辐射场)。
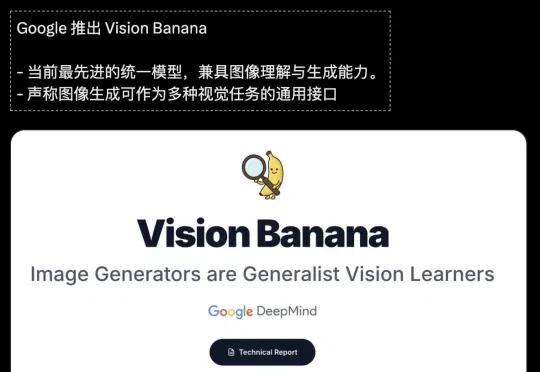
最近,谷歌联合ResNet作者何恺明、谢赛宁、NeRF先驱Jonathan T. Barron、 3D图形学名家Thomas Funkhouser,正式发布了Vision Banana。它向世界宣告:视觉AI终于不再需要那些臃肿的任务头了,理解,本质上只是生成过程中的一次「对齐」。
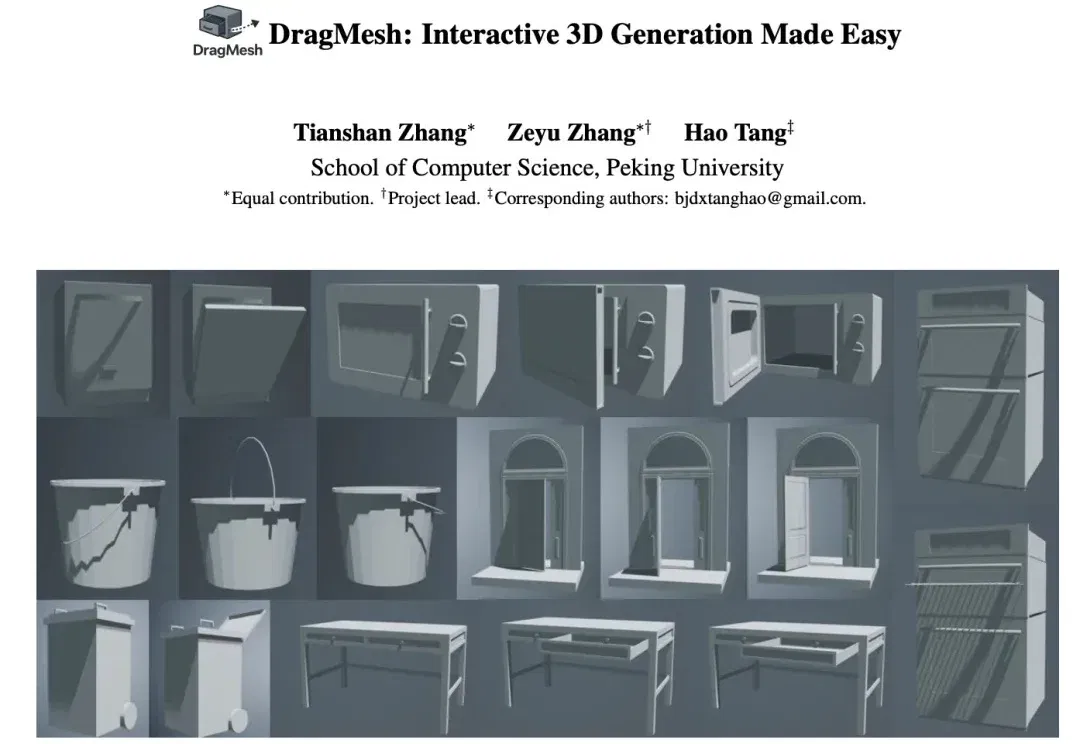
近年来,3D 生成模型在几何质量和渲染效果上进步很快。从 Mesh 到 NeRF、3D Gaussian Splatting,生成一个外观完整的三维物体已经不再困难。现有不少 articulated 3D generation 工作,更多关注的是从输入中生成一整套可动 3D 资产,包括物体几何、部件划分以及关节结构。
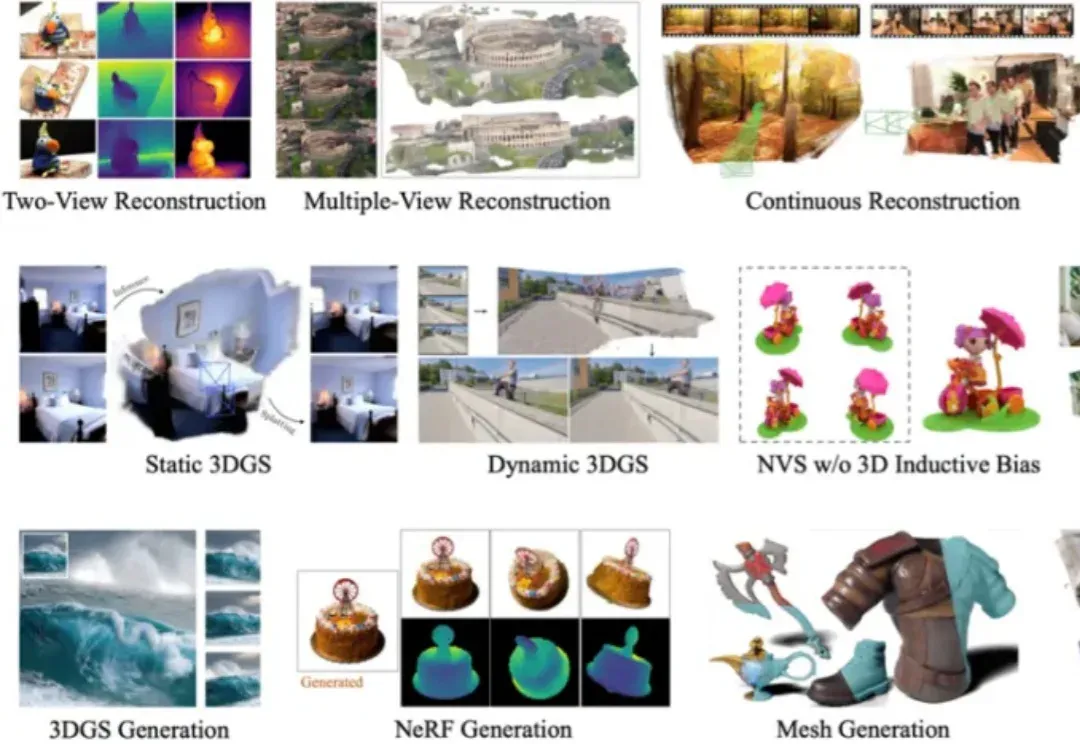
在 3D 视觉领域,如何从二维图像快速、精准地恢复三维世界,一直是计算机视觉与计算机图形学最核心的问题之一。从早期的 Structure-from-Motion (SfM) 到 Neural Radiance Fields (NeRF),再到 3D Gaussian Splatting (3DGS),技术的演进让我们离实时、通用的 3D 理解越来越近。
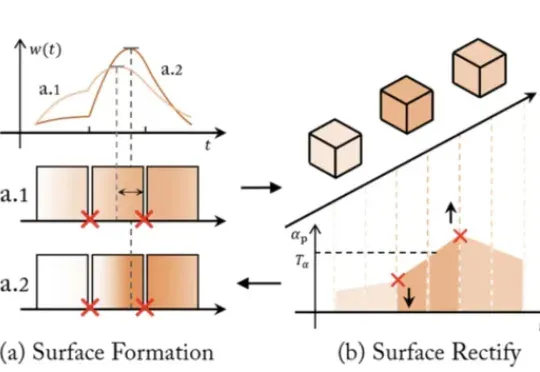
近年来,NeRF、SDF 与 3D Gaussian Splatting 等方法大放异彩,让 AI 能从图像中恢复出三维世界。但随着相关技术路线的发展与完善,瓶颈问题也随之浮现:
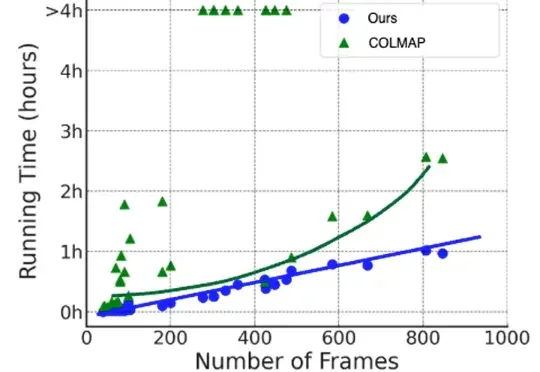
在三维重建、NeRF 训练、视频生成等任务中,相机参数是不可或缺的先验信息。传统的 SfM/SLAM 方法(如 COLMAP)在静态场景下表现优异,但在存在人车运动、物体遮挡的动态场景中往往力不从心,并且依赖额外的运动掩码、深度或点云信息,使用门槛较高,而且效率低下。
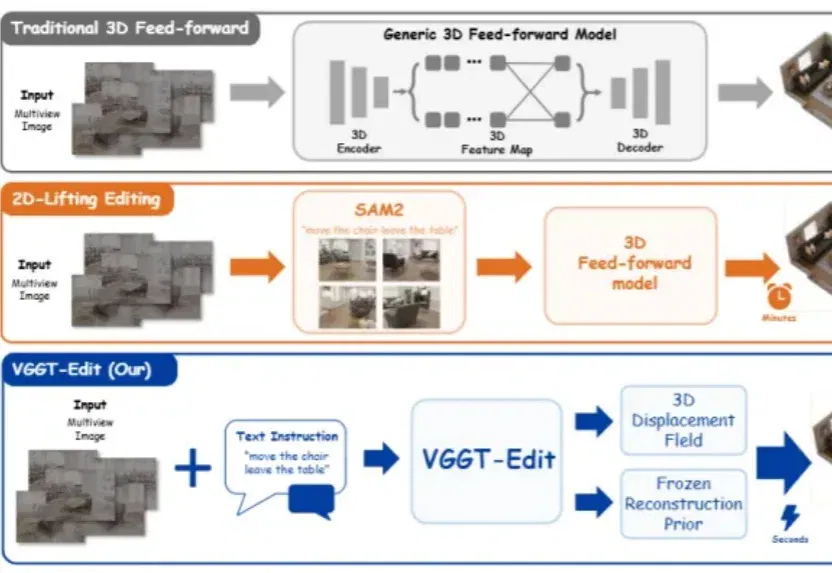
3D世界“会看”了,但还不会“改”。 从NeRF到83D Gaussian Splatting,再到VGGT、π³这类前馈式3D重建模型,整个行业的进展速度明显加快——只需几张图片,就能在几秒内重建完整3D场景。 但问题也恰恰出在这里。这些模型虽然已经能理解三维世界,却还不会修改三维世界。你可以让它重建一个房间,却很难真正告诉它: 把椅子移到窗边,删除中间那张椅子,把灰色皮沙发改成白色长毛沙发。 更麻烦的是,一旦涉及复杂编辑,现有方法往往迌速崩採——某些角度里椅子消失了,换个视角椅子又重新出现;明明没改的背景,却跟着一起变形。 为应对这一挑战,来自北京大学、香港中文大学、上海AI Lab、NT
生成式 AI 正在重写 3D 内容的生产流程:从“DCC 工具 + 外包”的线性供给,演进到“资产规模化生成 + 管线可用”的指数供给模式。过去五年,技术范式经历了从实时体积渲染,NeRF,到Score Distillation,3D扩散的快速迭代;需求侧则由游戏与影视,向3D 打印、电商样机、数字人、教育培训、以及AR/VR等长尾场景外溢。