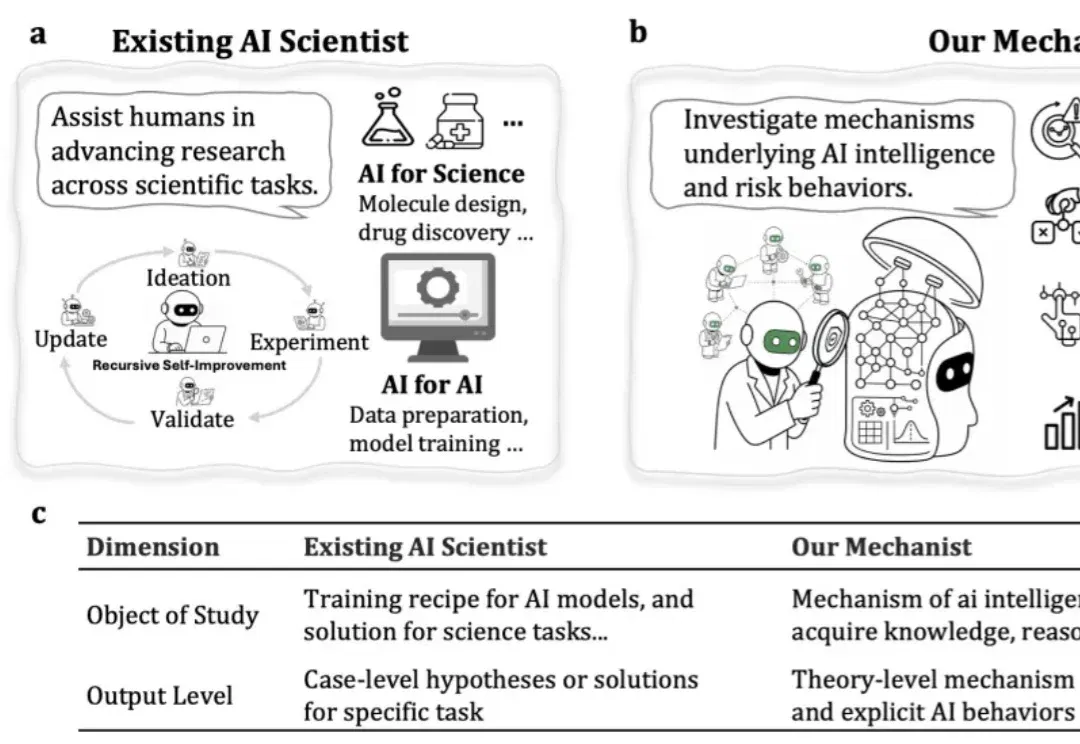
AI开始「研究自己」:Mechanist开启机器智能机制科学 (opens in a new tab)
近期发表于 Nature Machine Intelligence 的论文 Towards principled knowledge editing methods for large language model reasoning [1],从知识编辑切入,进一步探索大模型如何使用知识进行推理以及如何通过主动干预观察模型内部变化。
Total 4 articles
近期发表于 Nature Machine Intelligence 的论文 Towards principled knowledge editing methods for large language model reasoning [1],从知识编辑切入,进一步探索大模型如何使用知识进行推理以及如何通过主动干预观察模型内部变化。
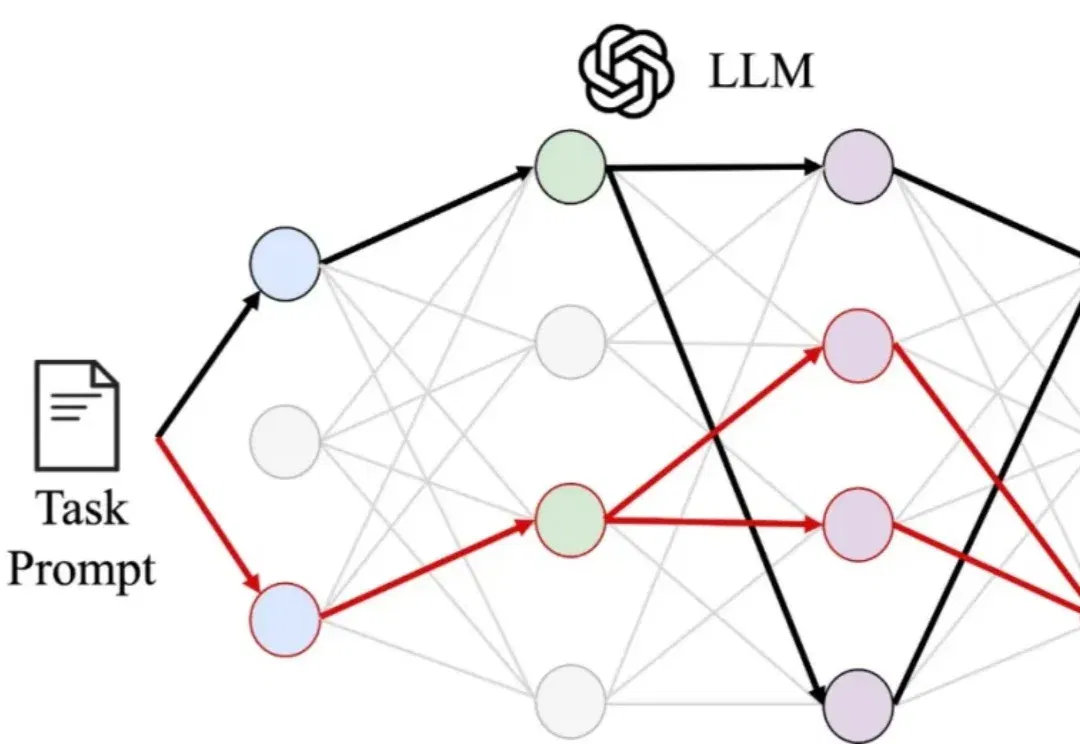
长期以来,机制可解释性(mechanistic interpretability)领域有一个几乎从未被明说、却被视为理所当然的前提:模型对于同一种任务的能力或表现,背后对应着一条唯一的、或近乎唯一的内部「电路」(circuit)。该领域的研究者们之所以要做「电路发现」(circuit discovery),是为了要把这些「特定的」电路找出来。
过去几年,机制可解释性(Mechanistic Interpretability)让研究者得以在 Transformer 这一 “黑盒” 里追踪信息如何流动、表征如何形成:从单个神经元到注意力头,再到跨层电路。但在很多场景里,研究者真正关心的不只是 “模型为什么这么答”,还包括 “能不能更稳、更准、更省,更安全”。
在大模型研究领域,做混合专家模型(MoE)的团队很多,但专注机制可解释性(Mechanistic Interpretability)的却寥寥无几 —— 而将二者深度结合,从底层机制理解复杂推理过程的工作,更是凤毛麟角。