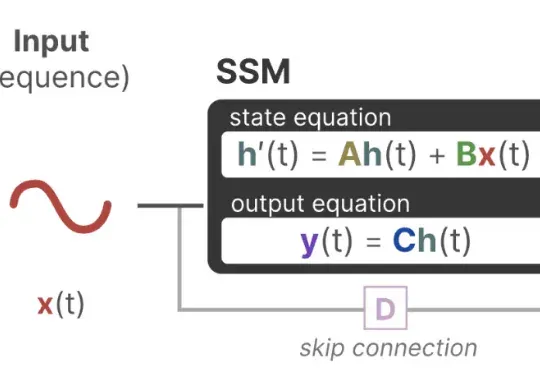
Mamba-3惊现AI顶会ICLR 2026!CMU知名华人教授一作首代工作AI圈爆红 (opens in a new tab)
曼巴回来了!Transformer框架最有力挑战者之一Mamba的最新进化版本Mamba-3来了,已进入ICLR 2026盲审环节,超长文本处理和低延时是其相对Transformer的显著优势。另一个挑战者是FBAM,从不同的角度探索Transformer的下一代框架。
Total 7 articles
曼巴回来了!Transformer框架最有力挑战者之一Mamba的最新进化版本Mamba-3来了,已进入ICLR 2026盲审环节,超长文本处理和低延时是其相对Transformer的显著优势。另一个挑战者是FBAM,从不同的角度探索Transformer的下一代框架。
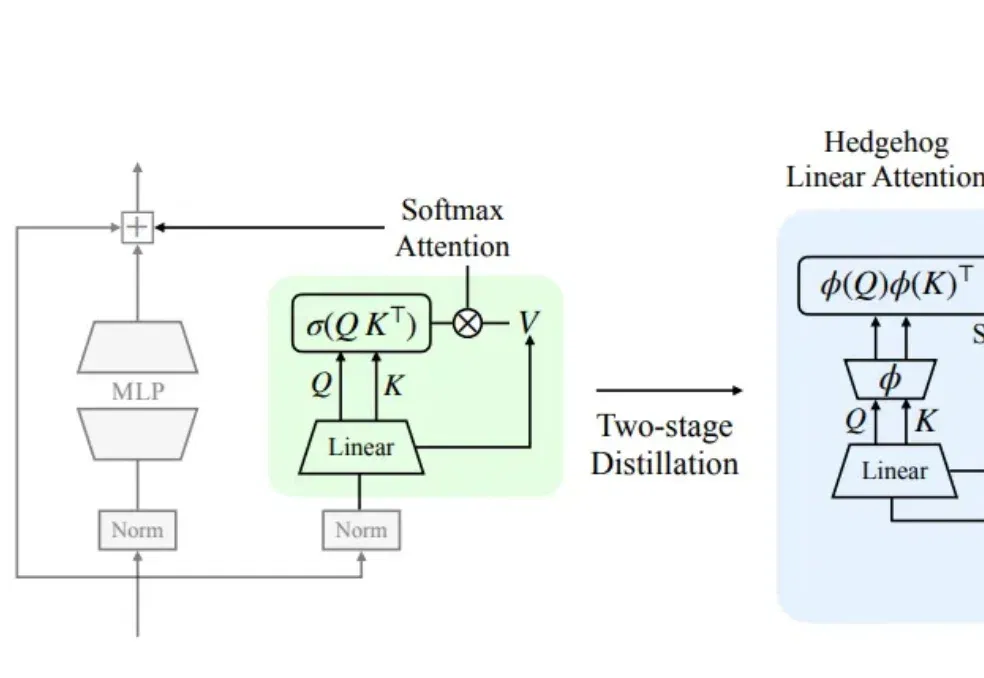
最近,苹果又整了个活儿,很工程、也挺关键: 把又贵又强的 Transformer,改造成又便宜又差不多强的 Mamba。而且,性能基本没怎么掉。
Transformer不保?今天,CMU普林斯顿原班人马杀回,新一代开源架构Mamba-3震撼降临。15亿参数战力爆表,性能比Transformer飙升4%。
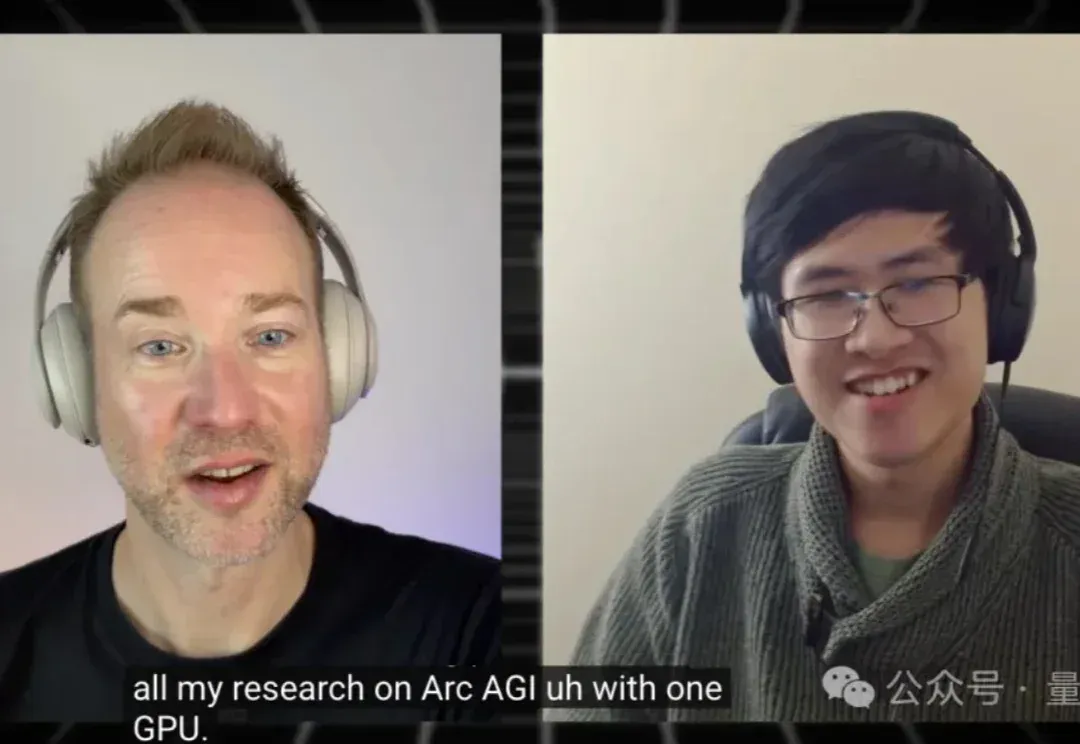
压缩即智能,又有新进展! 在最新研究CompressARC中,Mamba作者Albert Gu团队给出了一个不同于大规模预训练的智能配方—— 最小描述长度(MDL)。 研究显示,仅通过在推理阶段最小化目标谜题的描述长度,一个76K参数,完全没有经过预训练的模型,就能在ARC-AGI-1基准上解决20%的问题。 值得一提的是,CompressARC不仅没使用ARC-AGI的训练集,还是目前唯一一个只在单个样本上运行的深度学习方法。 凭借这一突破,CompressARC获得了ARC Prize 2025的第三名,并且据论文一作Isaac Liao透露,这项研究仅使用了一张GPU就得以完成。 这是怎
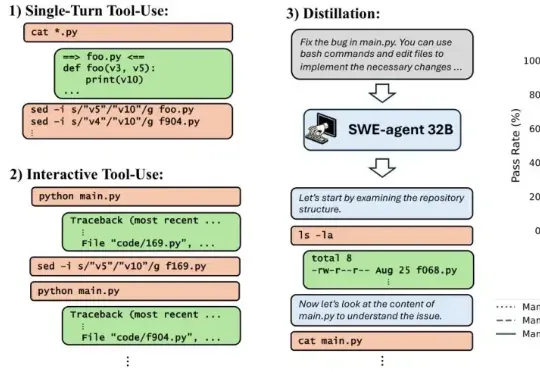
都说苹果AI慢半拍,没想到新研究直接在Transformer头上动土。(doge) 「Mamba+工具」,在Agent场景更能打!
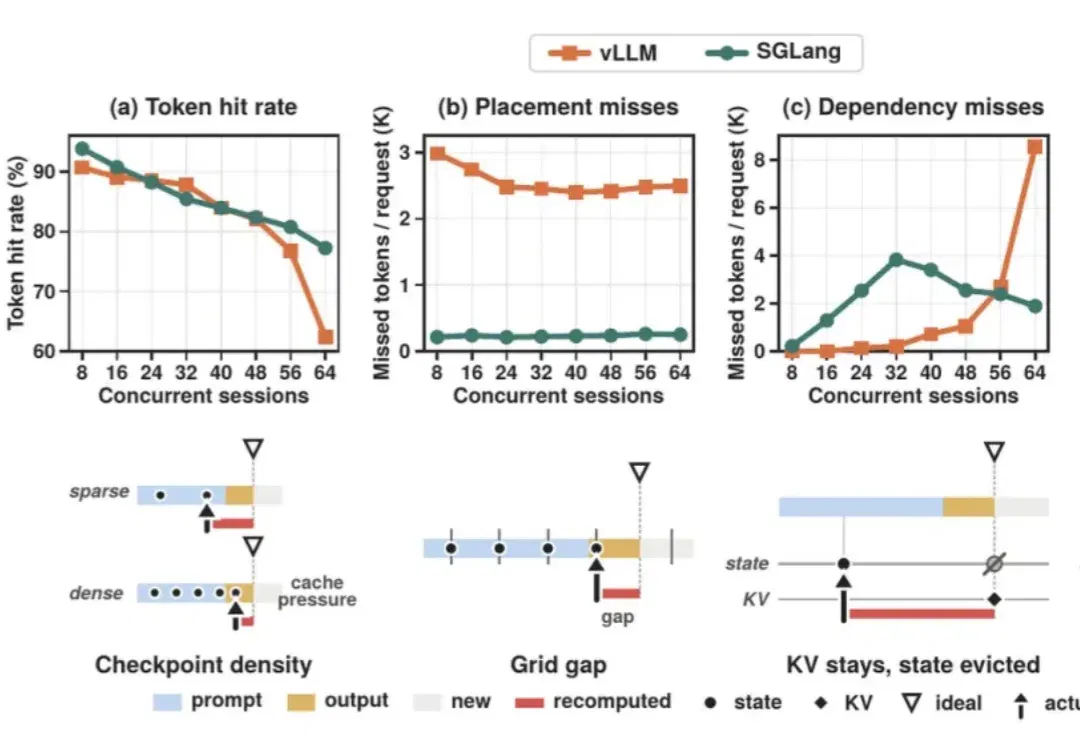
FlashStates manages recurrent state and KV caches together for hybrids using KDA, GDN and Mamba-style layers. The team tests prefix reuse, prefill speed and tiered-cache benefits on B200 GPUs with long-context workloads.
英伟达在开源模型上玩的很激进: “最高效的开放模型家族”Nemotron 3,混合Mamba-Transformer MoE架构、NVFP4低精度训练全用上。而且开放得很彻底: