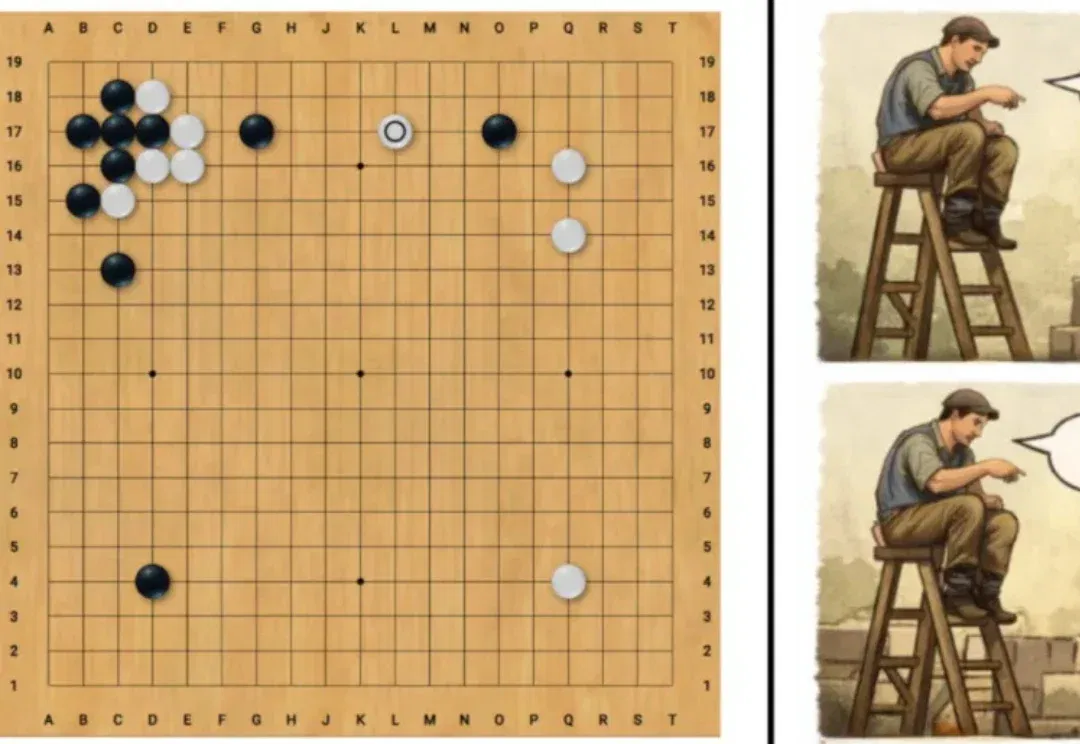
LaPha:你的Agent轨迹其实嵌入在一个Poincaré球? (opens in a new tab)在经典强化学习问题中,动作空间通常是离散且有限的。例如在围棋中,一步棋就是一次行动;在机器人控制或视觉 - 语言 - 行动(VLA)模型中,动作往往来自一个有限的控制指令集合。