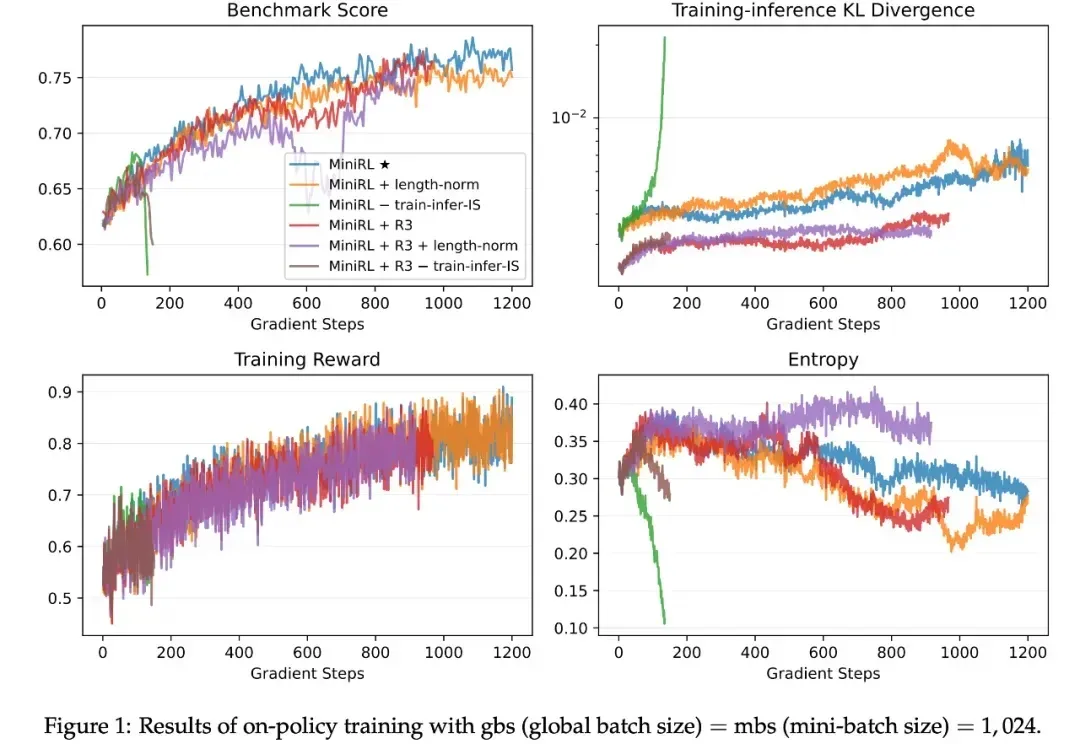
LLM强化学习不稳定之谜,被Qwen团队从「一阶近似」视角解开 (opens in a new tab)
如今,强化学习(RL)已成为提升大语言模型(LLM)复杂推理与解题能力的关键技术范式,而稳定的训练过程对于成功扩展 RL 至关重要。由于语言具有强烈的上下文属性,LLM 的 RL 通常依赖序列级奖励 —— 即根据完整生成序列给一个标量分数。
Total 3 articles
如今,强化学习(RL)已成为提升大语言模型(LLM)复杂推理与解题能力的关键技术范式,而稳定的训练过程对于成功扩展 RL 至关重要。由于语言具有强烈的上下文属性,LLM 的 RL 通常依赖序列级奖励 —— 即根据完整生成序列给一个标量分数。
在过去的几年里,LLM RL 系统的工作负载发生了巨大的变化。早期的 RLHF 围绕同步训练展开:模型按固定顺序进行生成、打分和训练,每个阶段之间有着明确的同步边界。如今,系统还需要处理异步生成、持续训练、多轮 Agent 以及与外部环境的交互 —— 那些在同步执行中原本隐含的状态、版本和故障边界,现在都必须显式地进行管理。
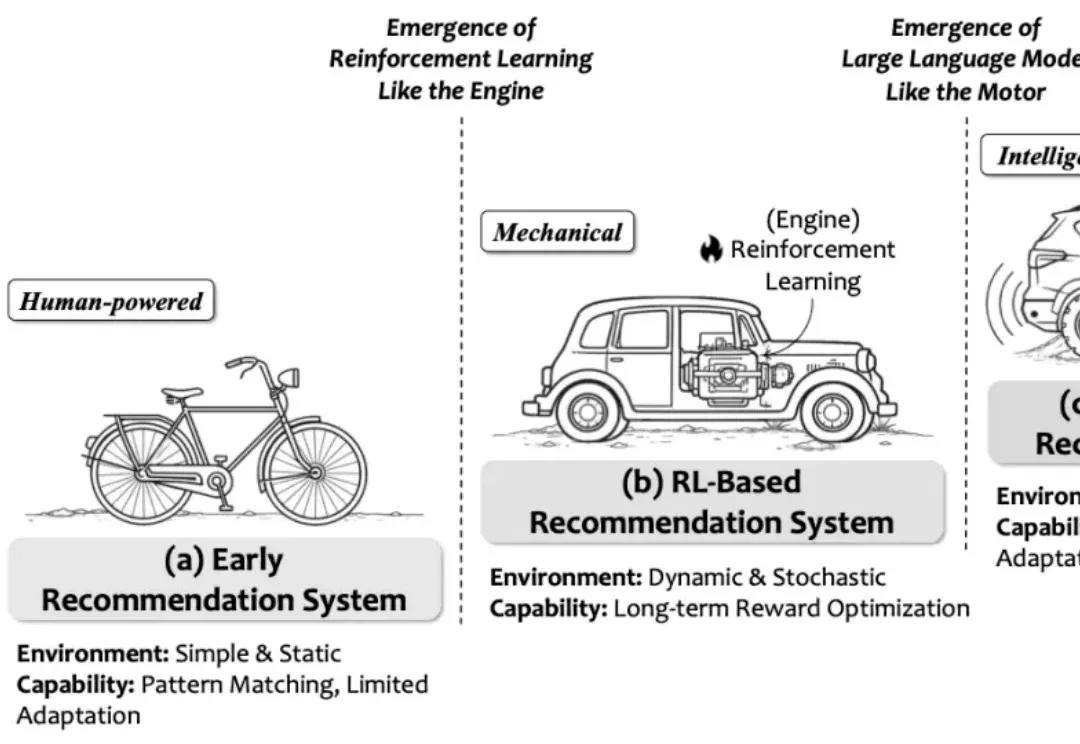
强化学习(RL)将推荐系统建模为序列决策过程,支持长期效益和非连续指标的优化,是推荐系统领域的主流建模范式之一。然而,传统 RL 推荐系统受困于状态建模难、动作空间大、奖励设计复杂、反馈稀疏延迟及模拟环境失真等瓶颈。