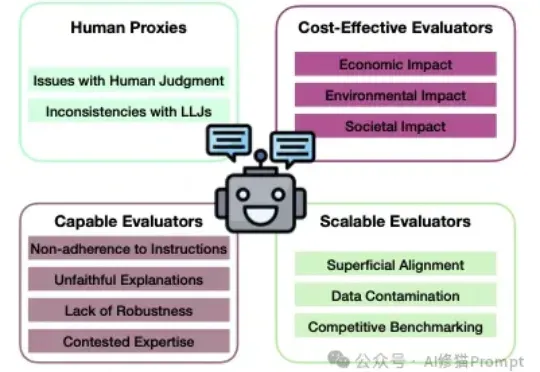
你的怀疑是对的!LLM作为Judge,既无效又不可靠,终于有论文向LLJ开炮了 (opens in a new tab)
让LMM作为Judge,从对模型的性能评估到数据标注再到模型的训练和对齐流程,让AI来评判AI,这种模式几乎已经是当前学术界和工业界的常态。
Total 4 articles
让LMM作为Judge,从对模型的性能评估到数据标注再到模型的训练和对齐流程,让AI来评判AI,这种模式几乎已经是当前学术界和工业界的常态。
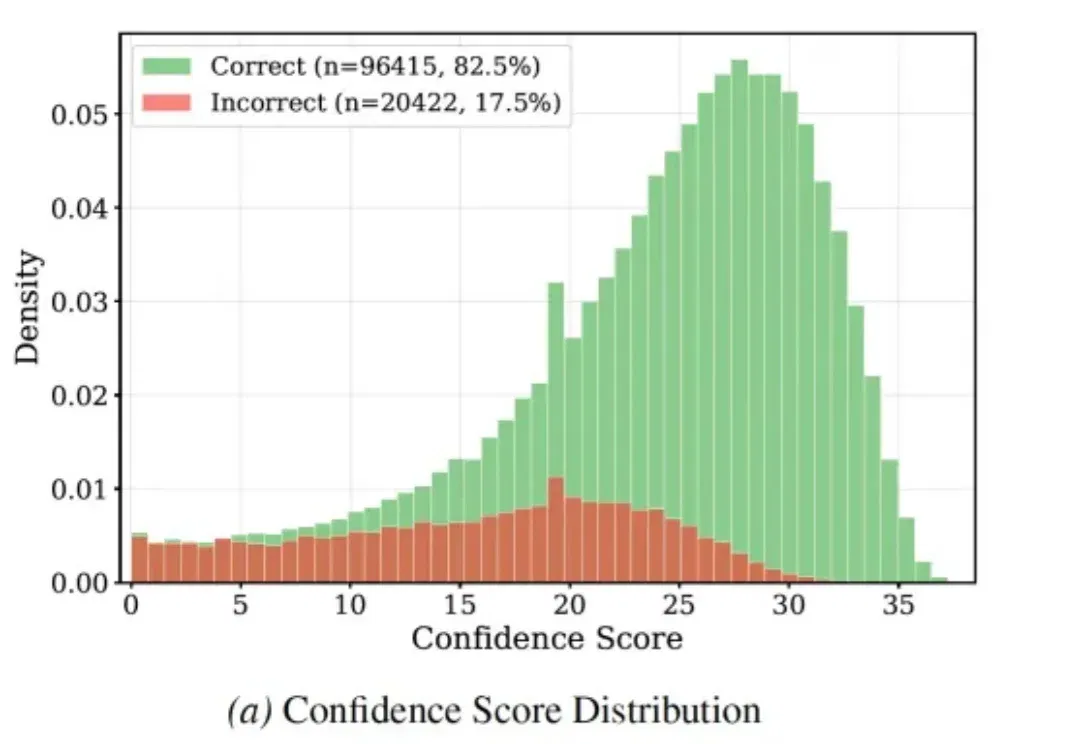
奖励模型(Reward Model, RM)是大语言模型对齐的核心组件,负责为模型输出提供符合人类偏好的评价信号。现有方法各有短板:标量判别式 RM 高效稳定但可解释性有限;生成式 judge 能给出判断理由,却需为每个样本生成长 reasoning,token 与延迟开销显著。
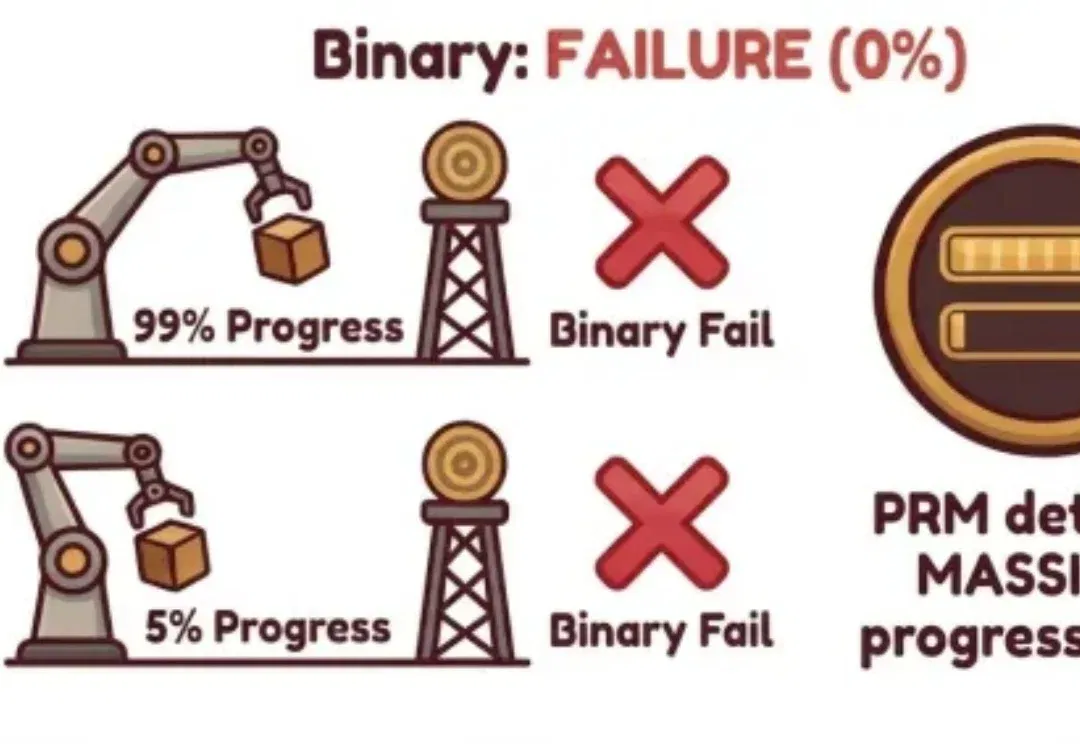
随着机器人操作从短程、单步技能逐步走向长程、富接触、需要持续协调与恢复能力的复杂任务,传统以二元成功率为核心的评测方式开始暴露出明显局限。它能够回答 “任务是否完成”,却难以回答 “策略推进到了哪里”“执行过程是否高效稳定”“失败究竟发生在什么阶段”。
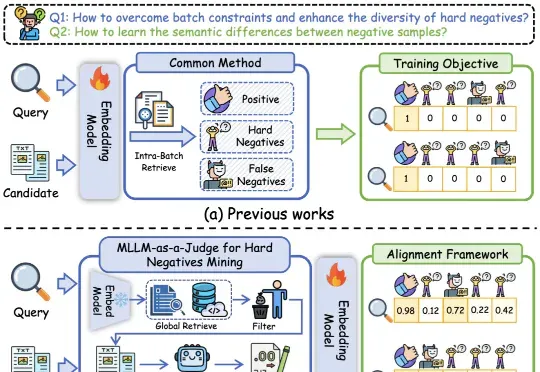
基于多模态大模型语义理解能力的统一多模态嵌入模型UniME-V2。该方法首先通过全局检索构建潜在困难负例集,随后创新性地引入“MLLM-as-a-Judge”机制:利用MLLM对查询-候选对进行语义对齐评估,生成软语义匹配分数。