LeCun的JEPA已进化为视觉-语言模型,1.6B参数比肩72B Qwen-VL (opens in a new tab)
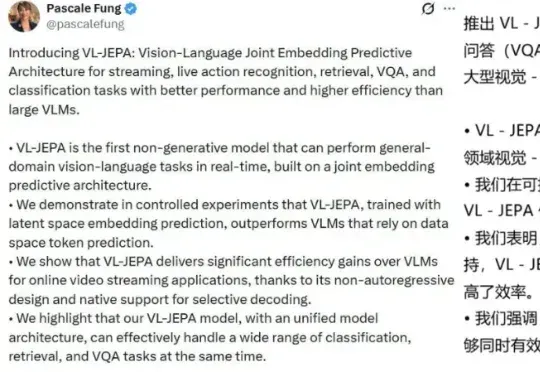
近日,来自 Meta、香港科技大学、索邦大学、纽约大学的一个联合团队基于 JEPA 打造了一个视觉-语言模型:VL-JEPA。据作者 Pascale Fung 介绍,VL-JEPA 是第一个基于联合嵌入预测架构,能够实时执行通用领域视觉-语言任务的非生成模型。
Total 23 articles
近日,来自 Meta、香港科技大学、索邦大学、纽约大学的一个联合团队基于 JEPA 打造了一个视觉-语言模型:VL-JEPA。据作者 Pascale Fung 介绍,VL-JEPA 是第一个基于联合嵌入预测架构,能够实时执行通用领域视觉-语言任务的非生成模型。
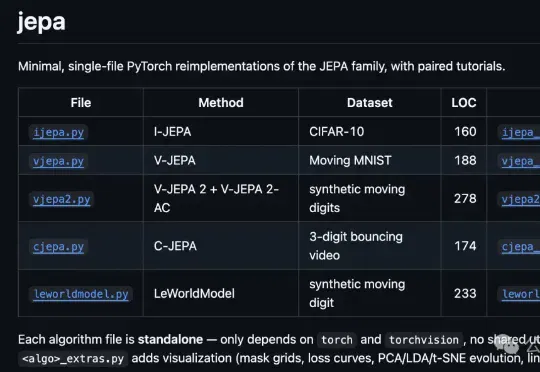
LeCun念叨了好几年的JEPA,被160行代码给复刻了。GitHub上有个开发者,用极简单文件形式,用PyTorch把JEPA核心系列全部实现了一遍,从I-JEPA到LeWorldModel,五个变体一个没落,就为了——
刚刚,纽约大学联合LeCun初创AMI带来JEPA系列的最新成果——AdaJEPA。与过去在预训练结束后就冻结参数的世界模型不同,AdaJEPA能够在与环境交互中,基于测试时自适应(Test-Time Adaptation, TTA),实时调整世界模型的编码器和预测器参数,从而实现持续学习。
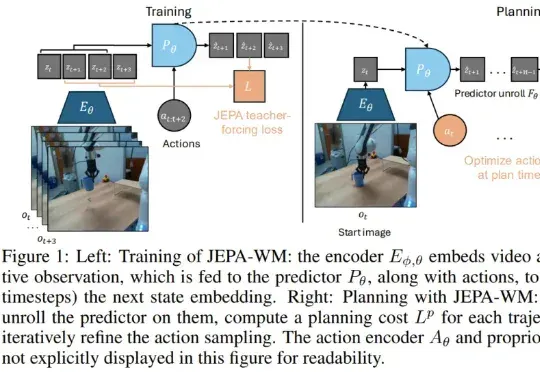
真正的挑战在于,如何在错综复杂的原始视觉输入中提取抽象精髓。这便引出了本研究的主角:JEPA-WM(联合嵌入预测世界模型)。从名字也能看出来,这个模型与 Yann LeCun 的 JEPA(联合嵌入预测架构)紧密相关。事实上也确实如此,并且 Yann LeCun 本人也是该论文的作者之一。
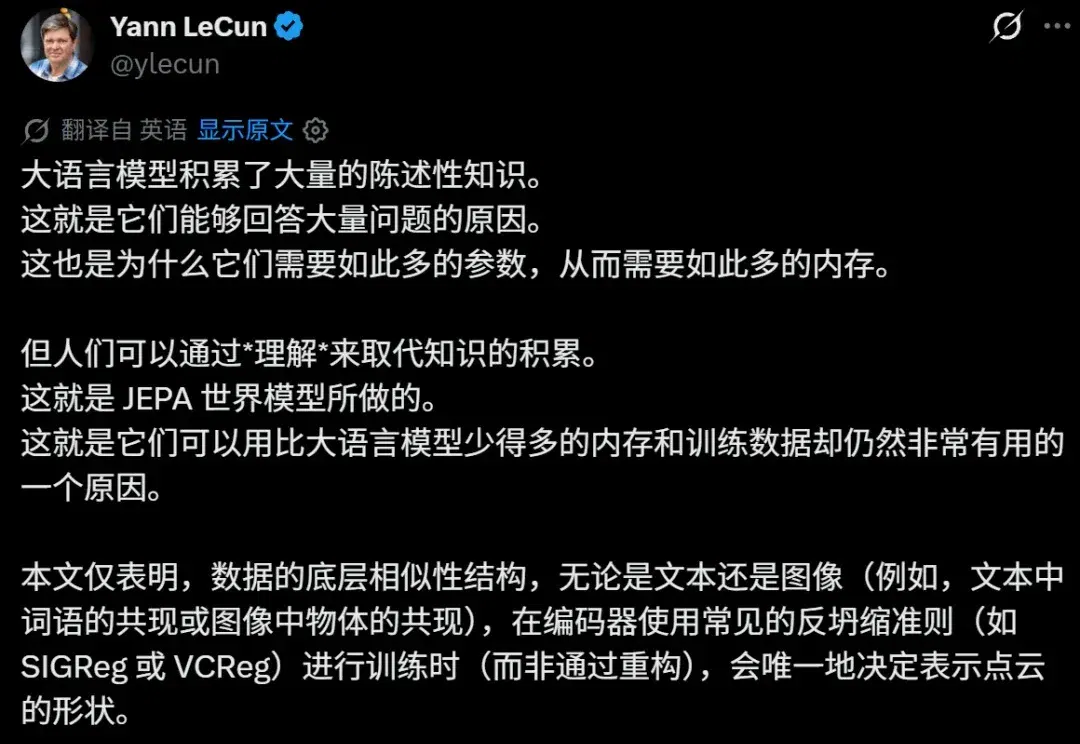
论文在理想化条件下推导 JEPA 表征对齐的充分条件,并比较不同训练视图。特定评测中,109M文本模型的对齐分数超过72B基线,同规模样本效率也有改善;这些结果不意味着模型规模从未有效,或小模型已全面超过大模型。
LeCun 与合作者研究 Good-View JEPA 如何学习不同模态的共同表征。在特定对齐评测中,109M文本编码器超过Qwen2.5-72B;同规模比较也显示样本效率提升。理论证明依赖理想化条件,结果不能推及通用推理或编程能力。
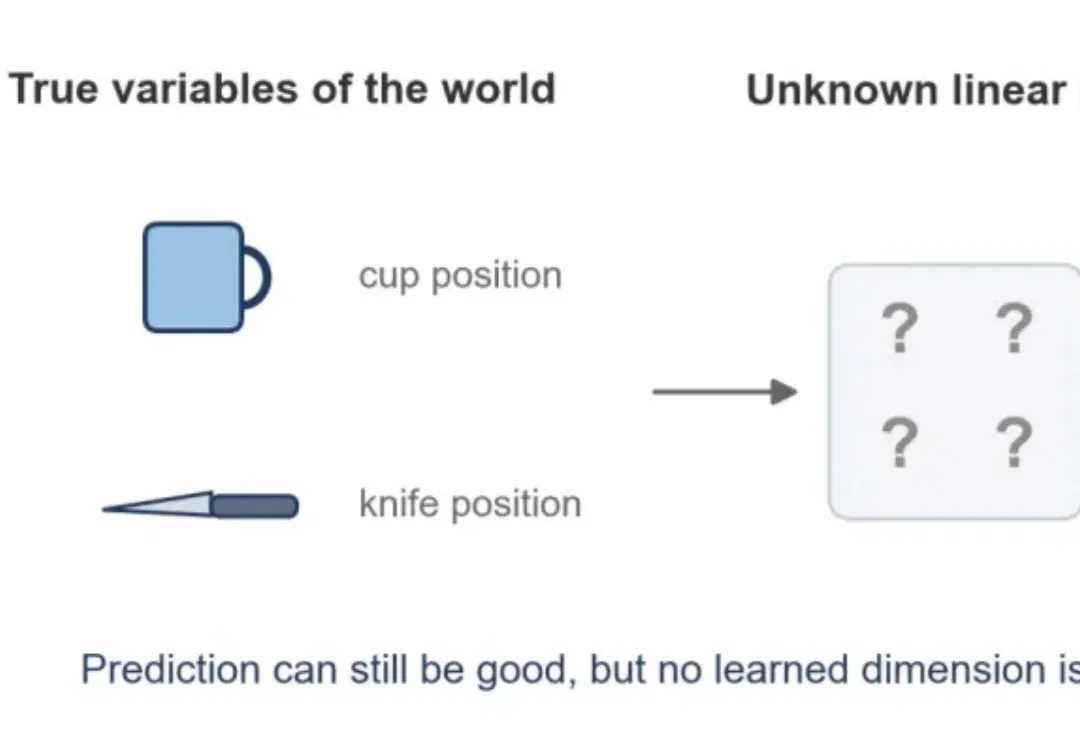
JEPA 能不能真正理解观测背后的生成机制?
LeCun创办的AMI联合纽约大学、巴黎INRIA和布朗大学推出分层世界模型H-JEPA并开源代码及预训练权重,其在Visual AntMaze任务中以更少规划计算取得更高成功率。
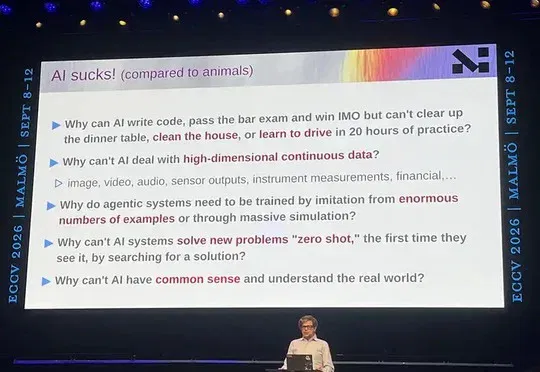
图灵奖得主Yann LeCun在ECCV 2026发表Keynote演讲,论证"预测像素"是伪命题,阐述JEPA在抽象表征空间预测世界的机制,并建议研究者放弃生成式模型与大语言模型,转向联合嵌入架构与世界模型以实现人类水平智能。
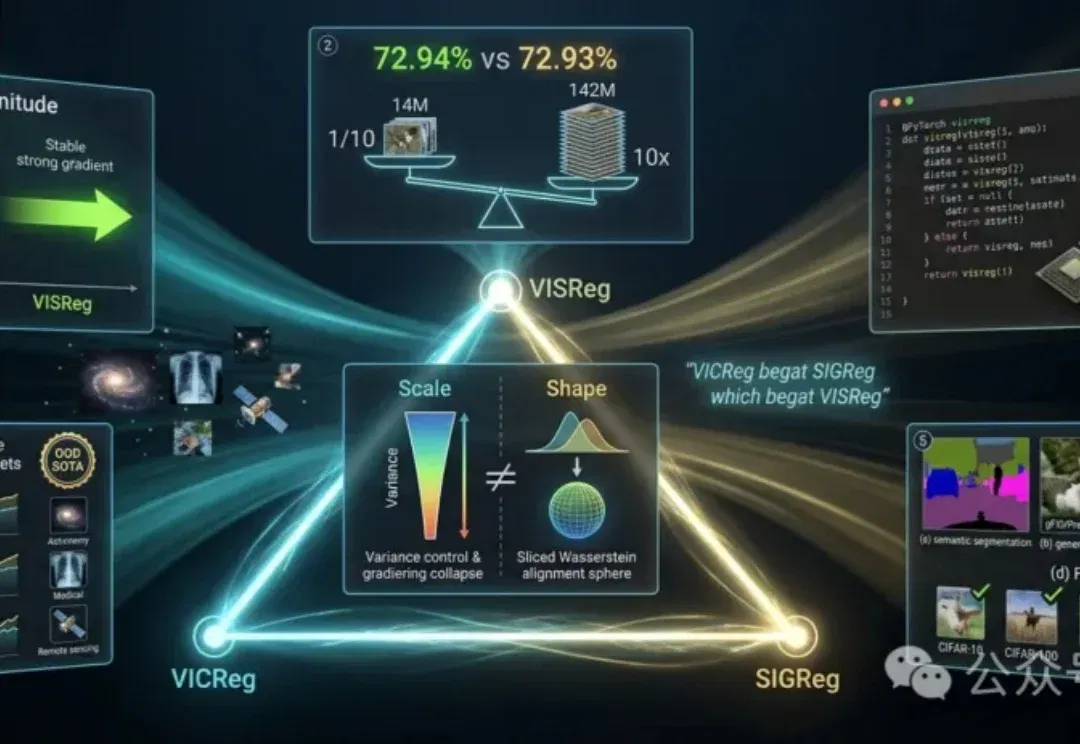
JEPA世界模型的底层是Yann LeCun自2017年起持续倡导的自监督学习(Self-Supervised Learning, SSL)。