Thinking Machines Lab拿出了一个「最人性」的 AI —— 「交互模型」Interaction Model (opens in a new tab)
Mira Murati 用一年半时间证明了「人机协作」不是一句口号。 5 月 11 日,Thinking Machines Lab 发布了一段研究预览视频,展示了他们所谓的「交互模型」(Interaction Model)。
Total 6 articles
Mira Murati 用一年半时间证明了「人机协作」不是一句口号。 5 月 11 日,Thinking Machines Lab 发布了一段研究预览视频,展示了他们所谓的「交互模型」(Interaction Model)。
OpenAI 前 CTO Mira Murati 和前应用研究负责人翁荔(Lilian Weng)创立的 Thinking Machines Lab,也就是 TML,刚刚发布了一个叫「Interaction Models」的研究
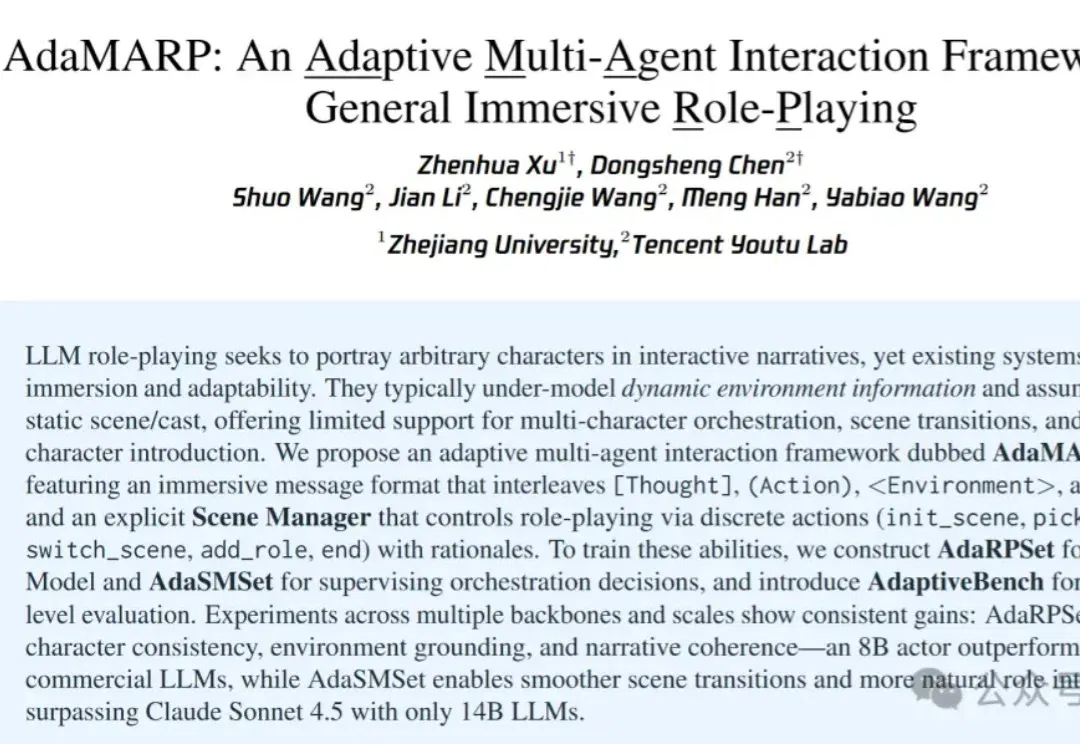
AI能实现真正的沉浸式扮演了。 大语言模型在角色扮演任务上进展迅速,但现有系统往往缺乏沉浸感和适应性: 环境信息未被充分建模,场景与角色也多为静态,难以支撑多角色调度、场景切换、动态引入新人等复杂叙事需求。 现在,浙江大学联合腾讯优图实验室提出AdaMARP(Adaptive Multi-Agent Interaction Framework for General Immersive Role-Playing)—— 一种面向通用沉浸式角色扮演的自适应多智能体交互框架。 该框架通过四通道消息格式和场景管理器,让AI不仅会「说」,还会「想」、会「动」、会「感知环境」,并在复杂叙事中灵活切换场景、
今日凌晨,比OpenAI早一个小时,谷歌甩出了3个Agent大招:Deep Research Agent功能更新,并首次向开发者开放;开源新网络研究Agent基准DeepSearchQA,旨在测试Agent在网络研究任务中的全面性;推出新交互API(Interactions API)。

「麻烦你,帮我看一下。」 一副 AI 眼镜的价值,可能就藏在少说一次这样的话里。 到了陌生的地方,视障用户最需要的不是一个什么都能聊的 AI,而是一个能告诉他周围有什么、该注意什么的帮手。该提醒时及时提醒,没必要时就安静,别在耳边说个不停。 京东在本次 JDD 上展示的 AI 眼镜,瞄准的正是这个需求:接入 JoyAI-VL-Interaction 模型,通过第一视角持续理解周围环境,为全盲及低视力人群提供辅助,减少「必须问人」的时刻。 这是一副充满爱与希望的智能眼镜。它也是观察京东 AI 路线的一个小切口。 JDD 期间,京东发布并开源JoyAI-Echo WM 实时可交互世界模型,并带来一
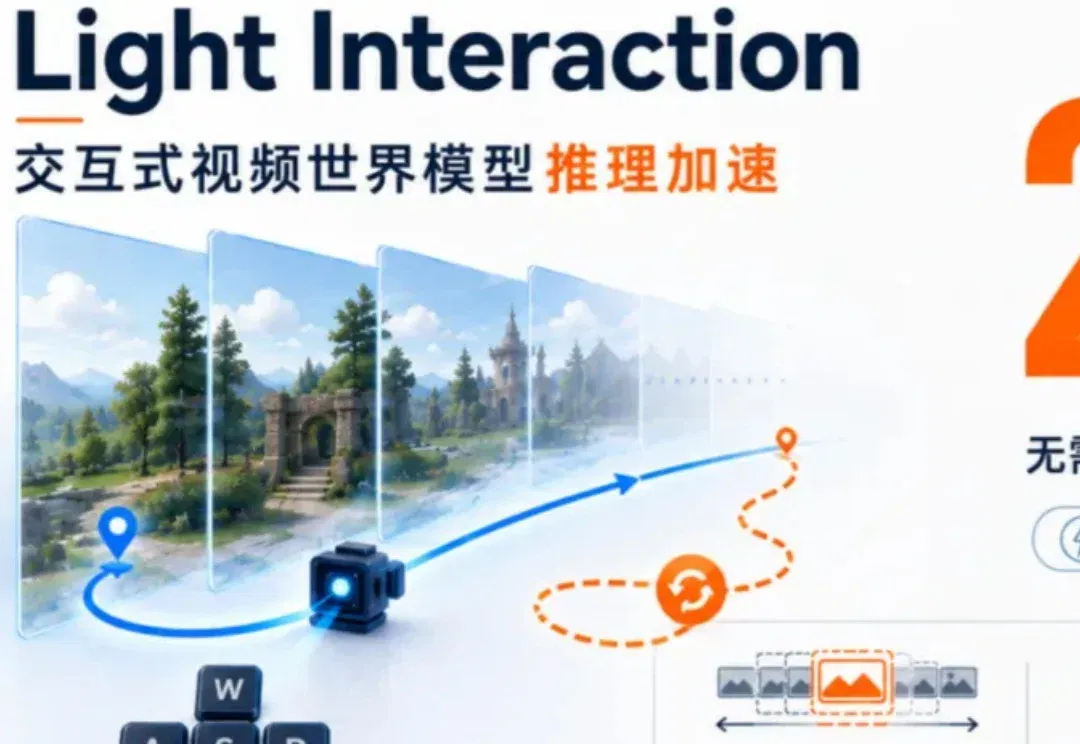
交互式视频世界模型正在从「一次性生成短片」走向「像游戏一样边操作边生成」。但长轨迹交互会迅速放大上下文、显存和多步去噪开销。Light Interaction不改模型参数、不重新训练,只在推理阶段把相机轨迹变成调度信号,动态选择历史上下文、在回访状态复用去噪输出,并用面向自回归生成的3D稀疏注意力降低计算。