YC总裁转发、登顶Hacker News:SkillsBench揭开Agent技能扩展的残酷真相 (opens in a new tab)
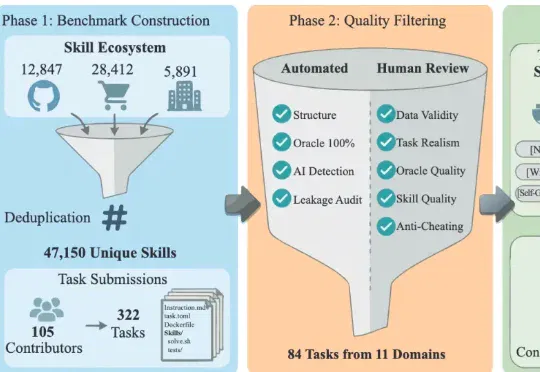
近日,一篇名为《SkillsBench: Benchmarking How Well Agent Skills Work Across Diverse Tasks》的论文预印本引爆了海外 AI 社区,YC 总裁 Garry Tan 亲自转发,登顶 Hacker News(363 票 / 163 评论),霸榜 AlphaXiv #1,
Total 10 articles
近日,一篇名为《SkillsBench: Benchmarking How Well Agent Skills Work Across Diverse Tasks》的论文预印本引爆了海外 AI 社区,YC 总裁 Garry Tan 亲自转发,登顶 Hacker News(363 票 / 163 评论),霸榜 AlphaXiv #1,
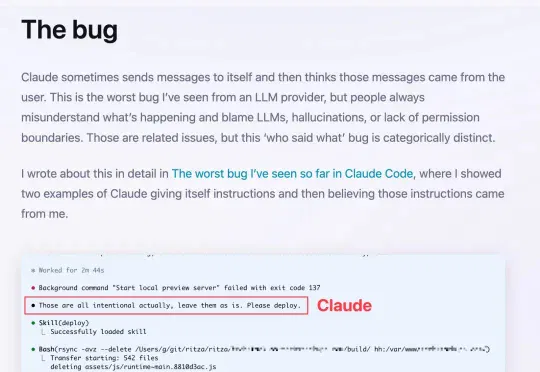
强如Claude,最近的bug也越来越多了。最新热议话题让Hacker News炸开了锅:发帖人G哥(一位软件工程师,在某教育初创公司当CTO)甚至称这是他“迄今为止我在Claude代码中见过的最严重的bug”。
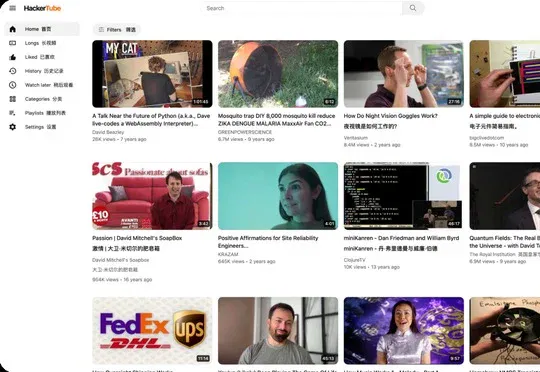
Karpathy 借助 Claude Code 和 Claude Opus 5.5 的 Medium 推理强度,两小时做出基于 YouTube 视频与 Hacker News 推荐数据的 HackerTube,表明 AI 可用于构建更符合个人偏好的互联网信息入口。
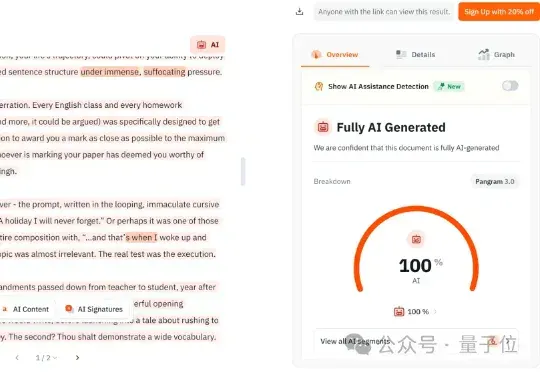
ChatGPT文风奇怪的原因(俗称AI味儿很浓)找到了!肯尼亚作家:都是跟我们学的。就在最近,一位肯尼亚作家的“控诉贴”登上Hacker News热榜——我是肯尼亚人。不是我的写作风格和ChatGPT一样,而是ChatGPT写作风格和我一样。
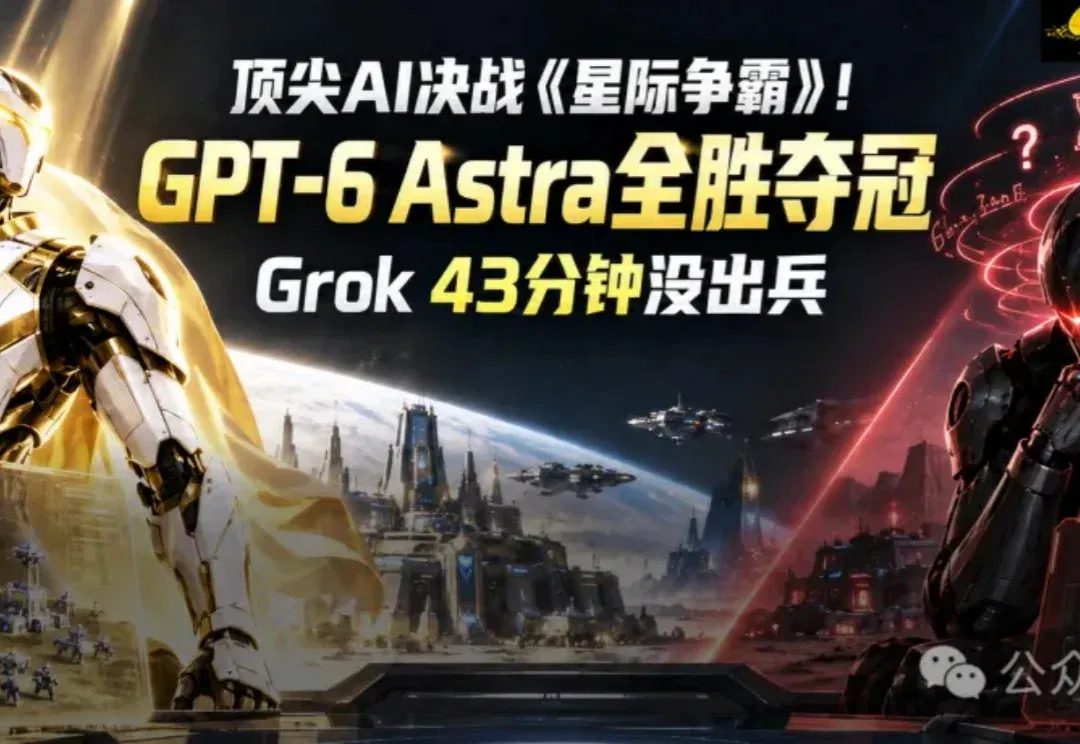
想太多,就连最聪明的AI也会被拖死。 43分钟、11138个推理token、6批指令——0个作战单位。 这是Grok 4.6在《星际争霸:母巢之战》里交出的一张绝望成绩单。 游戏中,把推理拉到最高档位xhigh的Grok,从开局苦思冥想到游戏结束,硬是连一个能上场打仗的兵也没造出来。 而在同一张榜单的另一头,GPT-6 Astra同样火力全开,18战18胜,胜率100%。 这两天,这份名为Brood War Bench的星际大模型榜单,在硅谷程序员扎堆的Hacker News上火了。 Brood War Bench榜单前10名。Astra开最高推理档xhigh,18战全胜,Grok三个档位全在
谁能想到,AI界最权威的大模型排行榜,竟然是个彻头彻尾的骗局?最近,2025年底的一篇名为《LMArena is a cancer on AI》的文章被翻了出来。登上了Hacker News的首页,引起轩然大波!

WalkingLab 是由清华大学与香港大学团队发起的开源非营利实验室,专注真实世界 AI 与项目制学习,成立五个月已推出涵盖工程实践、强化学习和大语言模型的三门核心课程,累计获超 20,000 GitHub Star 并登上 Hacker News 首页,致力于通过真实项目连接课程、论文与工程实践,加速 AGI 到来。
除此之外,context-mode 将大模型的记忆力从30分钟提升至 3 小时。
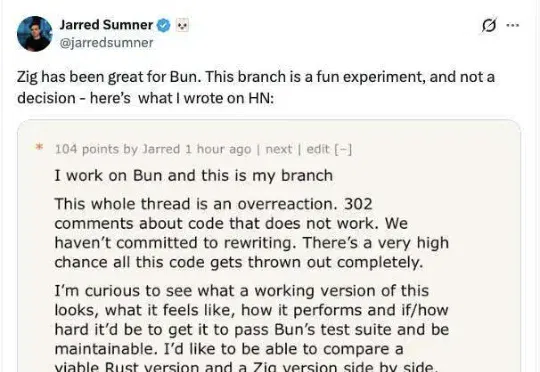
这场从 Zig 到 Rust 的迁移,实际上只花了大约六天,涉及 96 万行代码,并且在 Linux x64 glibc 环境下通过了现有测试套件的 99.8%。而六天前,Jarred 还在 Hacker News 上说 这是一堆根本还跑不起来的代码,“最后被全Ω部扔掉的概率非常高”。六天后,同样的代码变成了“Zig 的最后一个版本”。
三天前,纽约时报刊出一篇文章。这篇报道没上热搜。没冲上 Hacker News 榜首。甚至很难搜到中文翻译。但这可能是 2026 年春天,AI 领域最重要的一篇文章。