Search

Results for “FP8”

Total 10 articles

AMD新论文颠覆认知:FP4训练不稳定,原因不是随机性不足

AMD新论文颠覆认知:FP4训练不稳定,原因不是随机性不足 (opens in a new tab)

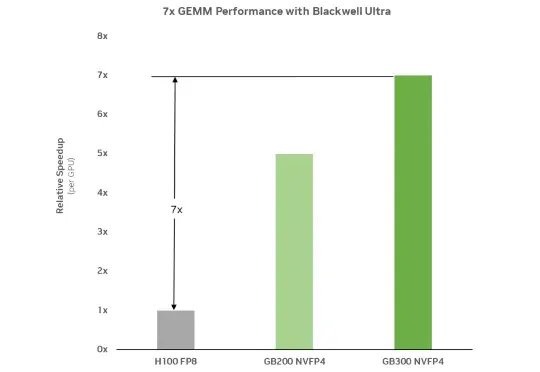
众所周知,大模型训练成本极高。 但大家又知道,降低训练精度能够显著降低训练成本。DeepSeek-V3 用 FP8 训练把成本打到了 560 万美元,已经让全行业侧目。 在 FP8 成功后,行业仍然在不断探索低精度的边界:从 FP8 降到 FP4,训练成本还能再降多少? 理论上,FP4 的计算吞吐可以是 FP8 的两倍。NVIDIA Blackwell 和 AMD MI350 系列都已经在硬件层面原生支持了 FP4 运算,前者在 B200 上标称 FP4 算力可达 4500 TOPS(稀疏)。硬件已经准备好了,但软件和算法那一侧,一直卡在一个问题上: 用 FP4 从头训练大模型,训练过程非常不
AI guides
0
智源:FlagOS完成DeepSeekV4八款芯片Day0 适配,实现三重技术突破

智源:FlagOS完成DeepSeekV4八款芯片Day0 适配,实现三重技术突破 (opens in a new tab)

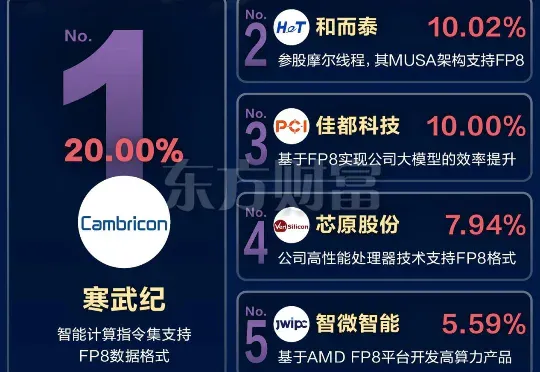
由智源研究院牵头研发的众智 FlagOS 第一时间对两个“巨无霸”模型进行全量适配,已经完成 DeepSeek-V4-Flash 在8款以上 AI 芯片上的全量适配与推理部署,包括海光、沐曦、华为昇腾、摩尔线程(FP8)、昆仑芯、平头哥真武、天数、英伟达(FP8)等芯片。FlagOS 同时正在推进 DeepSeek-V4-Pro 模型在多个芯片的迁移适配,晚些时间开源出来,敬请期待。

AI news
0
5.5B激活参数!又一国产多模态模型开源,能自己看网页改代码,免费可用

5.5B激活参数!又一国产多模态模型开源,能自己看网页改代码,免费可用 (opens in a new tab)

视觉编程成绩超GPT-5.4。 智东西9月9日报道,今日,蚂蚁百灵正式开源其首个原生多模态大模型Ling-3.0-flash-VL。Ling-3.0-flash-VL是一款1240亿总参数的MoE模型,单次推理激活5.5亿参数,原生支持图像、文本和视频输入,上下文窗口达到256K Tokens。 此次蚂蚁同步开放了模型的BF16和FP8版本,开发者已经可以在Hugging Face和ModelScope下载模型权重,FP4和INT4版本也将在近期上线。 ▲Ling-3.0-flash-VL开源主页(图源:Hugging Face) 这款模型基于此前的Ling-3.0-flash拓展而来。相比纯

AI news
0
OpenRouter周榜全球第二,这个国产模型终于开源了

OpenRouter周榜全球第二,这个国产模型终于开源了 (opens in a new tab)

在能力、成本、稳定性之间寻找最优解。 智东西10月15日报道,今天,一款刚登上OpenRouter Token全球使用量周榜第二的大模型,开源了! 阶跃星辰正式开放Step 5 Preview的模型权重,BF16、FP8两个版本同步上线HuggingFace和ModelScope。 Hugging Face: https://huggingface.co/stepfun-ai/Step-5-Preview ModelScope: https://modelscope.cn/models/stepfun-ai/Step-5-Preview Step 5 Preview采用稀疏MoE架构,总参数量

AI news
0