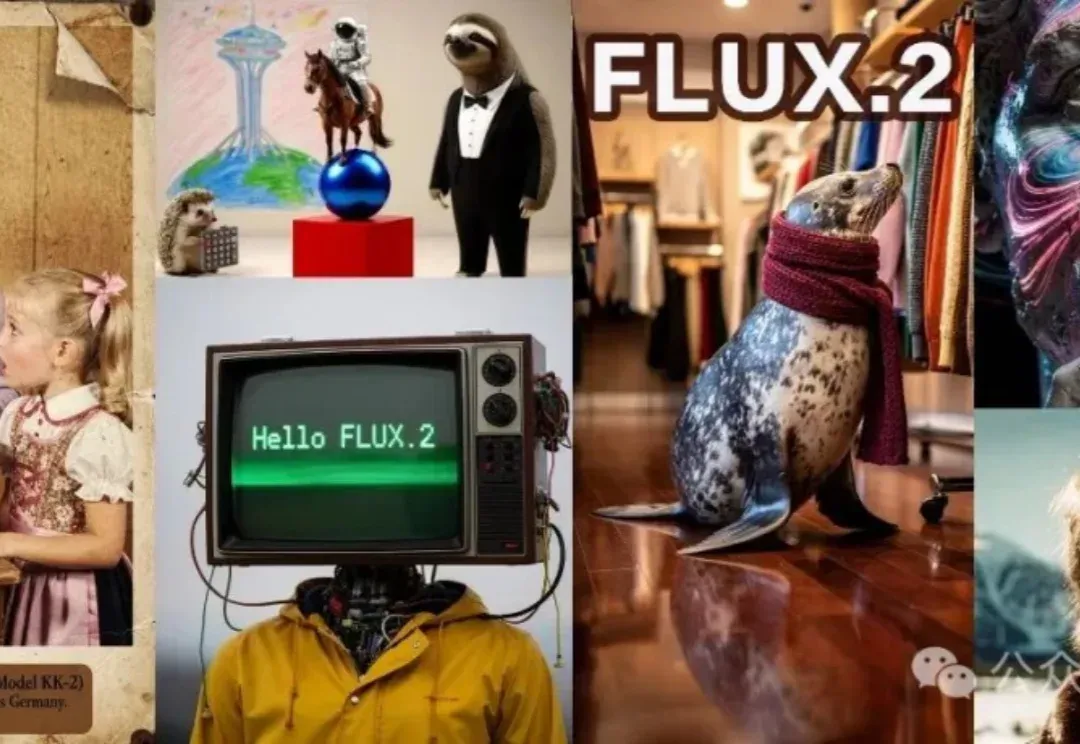
爆火全网FLUX.2重磅上线,开源版Nano Banana来了! (opens in a new tab)
Black Forest Labs的开源视觉模型FLUX.2上新,这是一款专为现实创意工作流程打造,绝非演示噱头的生产力工具,与前代FLUX.1相比,实现了从「会画」到「懂你要画什么」的跃升。
Total 18 articles
Black Forest Labs的开源视觉模型FLUX.2上新,这是一款专为现实创意工作流程打造,绝非演示噱头的生产力工具,与前代FLUX.1相比,实现了从「会画」到「懂你要画什么」的跃升。
AI绘图圈的朋友们肯定都知道这个产品。FLUX。这次,发布了4款基础模型和1个VAE模型,其中2款是不开源的。分别是Pro和Flex,这两个最强大的模型,是闭源的。而其中2款模型是开源的,一个dev,目前已经开源了。
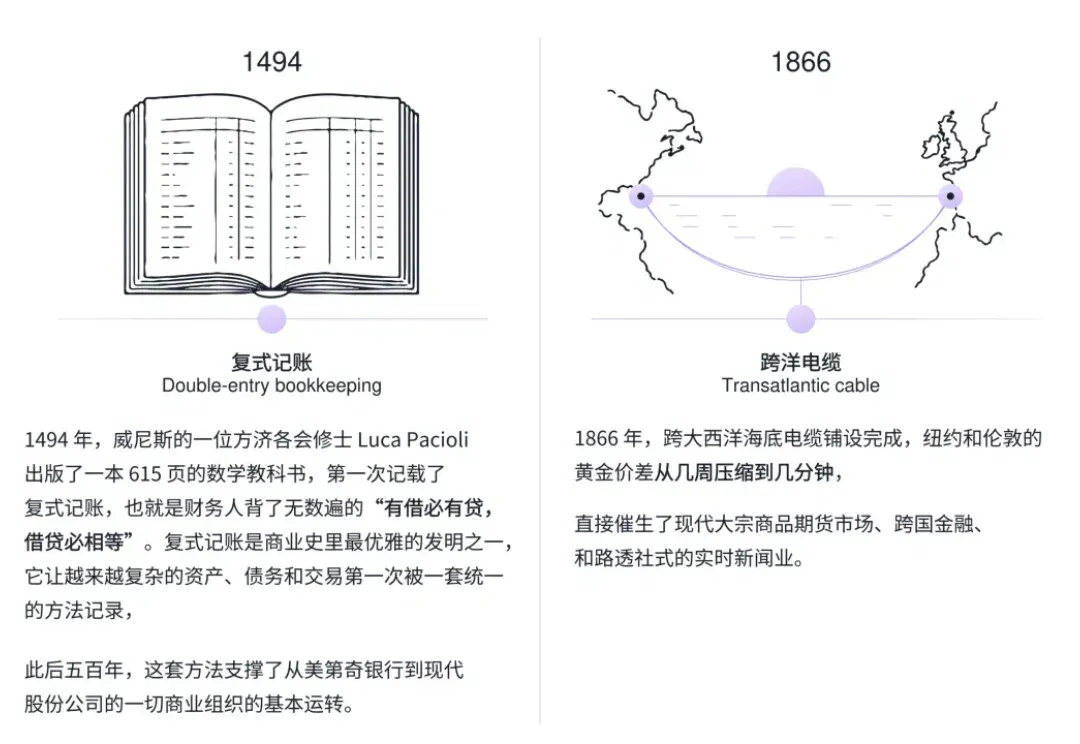
EigenFlux 团队阐述其对智能体网络的设想,讨论身份、信誉和持续协作,并介绍早期 MCP Checkup 案例。文中市场规模与网络演进属于预测。
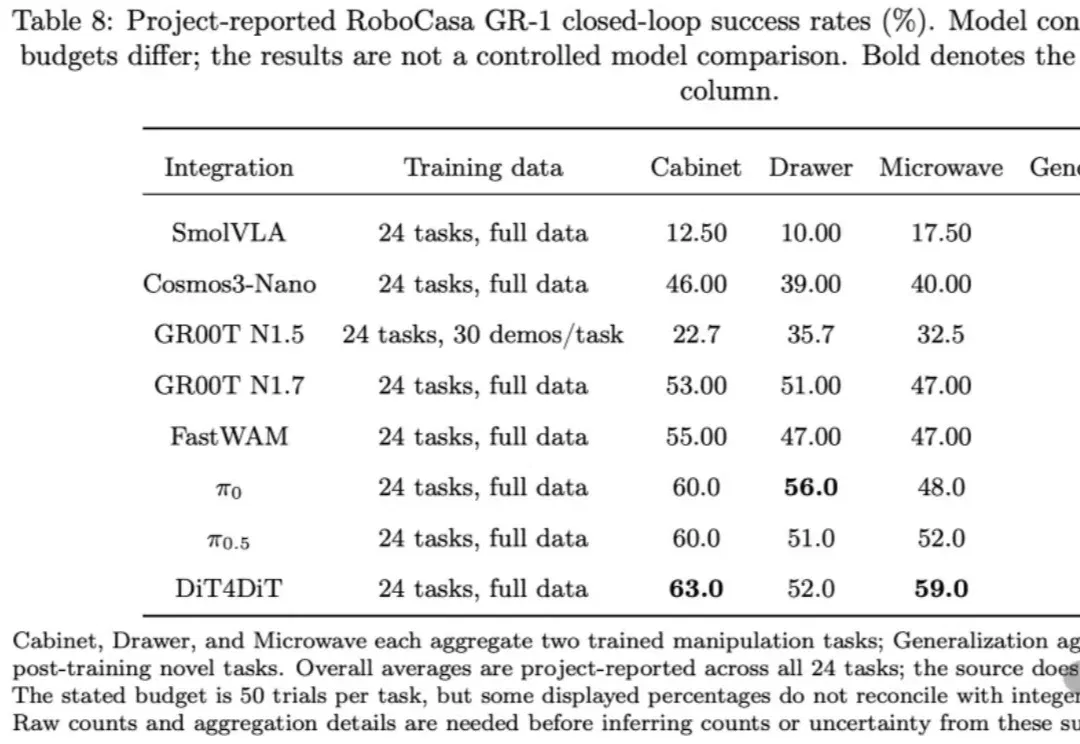
逐际动力更新 FluxVLA Engine 技术报告,补充在线强化学习、仿真评测和多种机器人平台的部署链路。统一配置、数据接口、推理加速与动作衔接旨在减少重复工程;报告中的性能增益来自特定模型和设备组合,仿真高分与真机任务完成率仍需分别看待。
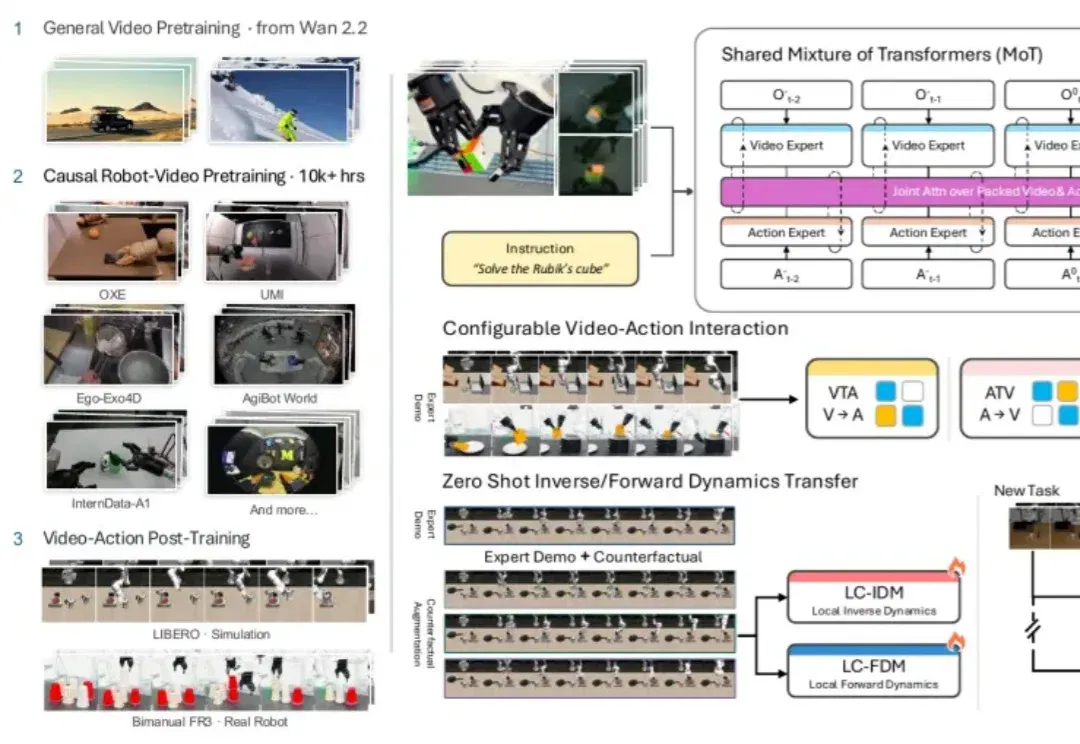
9 月 22 日,以 FLUX 图像模型闻名的 Black Forest Labs 跨界发布了开源 7B 世界动作模型 FLUX 3 Action。据其官方博客,该模型在英伟达 RoboLab-120 榜单上超过了此前最强的开源模型 Cosmos 3 Nano,参数量却不到后者一半。一家做图像生成的公司跑来卷机器人控制,说明视频模型里积累的「物理直觉」正被越来越多的团队当作机器人大脑的底座。
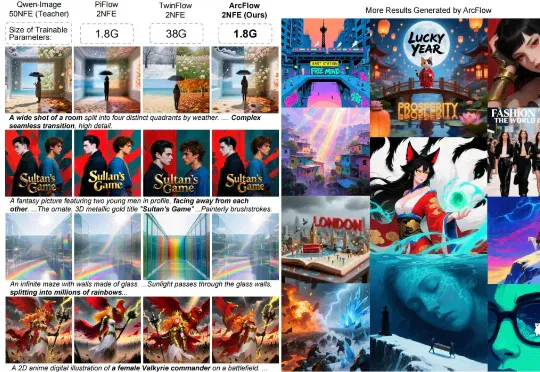
复旦大学与微软亚洲研究院带来的 ArcFlow 给出了答案:如果路是弯的,那就学会 “漂移”,而不是把路修直。在扩散模型中,教师模型(Pre-trained Teacher)的生成过程本质上是在高维空间中求解微分方程并进行多步积分。由于图像流形的复杂性,教师模型原本的采样轨迹通常是一条蜿蜒的曲线,其切线方向(即速度场)随时间步不断变化。
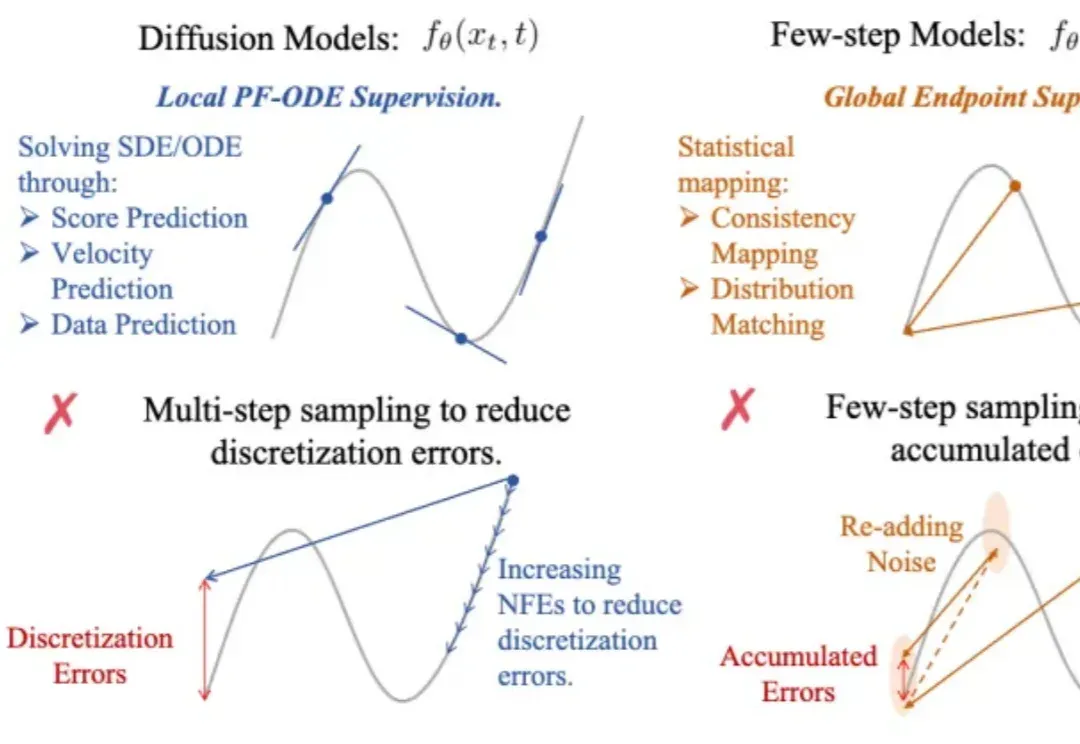
生成式AI的快与好,终于能兼得了? 从Stable Diffusion到DiT、FLUX系列,社区探索了很多技术方法用于加速生成速度和提高生成质量,但是始终围绕扩散模型和Few-step模型两条路线进行开发,不得不向一些固有的缺陷妥协。 这便是训练目标引发的“生成质量”与“生成速度”之间的矛盾根源: 要么只监督无穷小局部动力学(PF-ODE),要么只学习有限区间的端点映射,两者都各有内在限制。 一项新研究提出了名为Transition Model(TiM)的新范式,试图从根本上解决这一矛盾。 它放弃了传统扩散模型学习“瞬时速度场”或Few-step模型学习“端点映射”的做法,转而直接建模任意两
Bun 1.4正式发布,核心开发者Jarred Sumner利用AI Agent在11天内将底层代码从Zig重写为Rust,生成超100万行代码并烧掉约16.5万美元Token,InfluxDB创始人Paul Dix发文《The end of programming》指出传统编程方式正走向消亡。
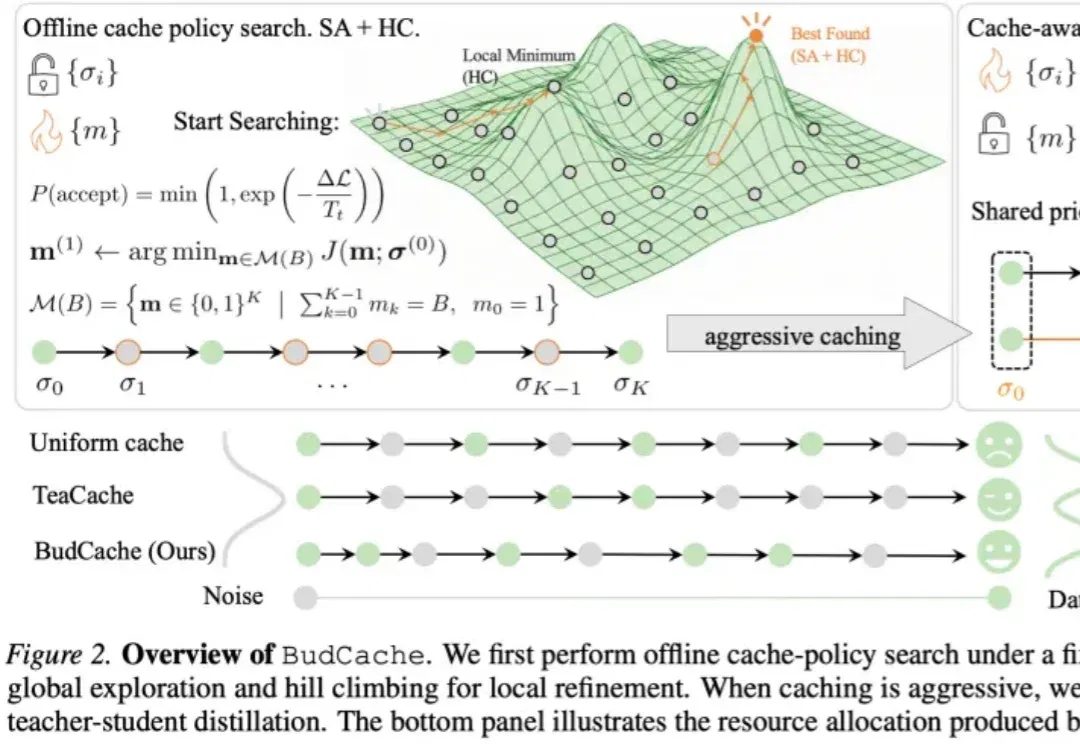
扩散模型生成得越来越好,但也越来越慢。 近年来,以FLUX、Wan为代表的扩散生成模型,在文本生成图像、文本生成视频上,已经能产出高分辨率、细节丰富又语义一致的内容。 但它们都有一个共同的麻烦——推理依赖多步去噪,每一步都要完整调用一次大型生成网络,算力成本居高不下。 对图像生成来说,这会直接拖慢交互式创作和在线部署的响应;对视频生成来说,模型还要同时兼顾空间细节与时间连续性,计算量更大,对高效推理的需求也更突出。 为应对这一问题,西湖大学AGI实验室提出了BudCache:一种面向固定计算预算的扩散模型step-level cache方法。 和已有那些基于启发式阈值的缓存方法不同,BudCa
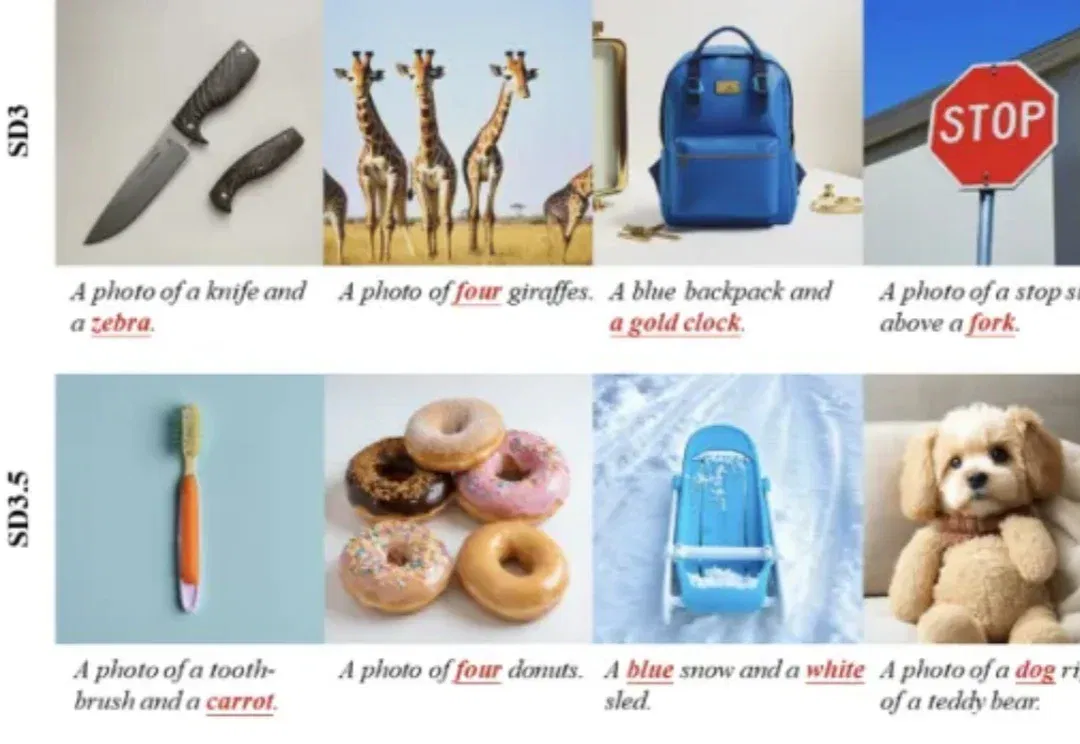
近年来,文生图模型的能力快速提升。从 Stable Diffusion 到 FLUX、Qwen-Image,扩散模型已经能够生成高质量图像,也能处理越来越复杂的文本提示。