独家!字节推出“量原求索Labelease”,超5000名顶尖专家已入驻 (opens in a new tab)
《读佳》获悉,由北京青阳智维科技有限公司运营“量原求索Labelease”已推出,通过媒体报道可知,该公司隶属于字节跳动。 据悉,Labelease的主要作用是帮助模型团队解决模型从训练到部署全链路中
Total 5 articles
《读佳》获悉,由北京青阳智维科技有限公司运营“量原求索Labelease”已推出,通过媒体报道可知,该公司隶属于字节跳动。 据悉,Labelease的主要作用是帮助模型团队解决模型从训练到部署全链路中
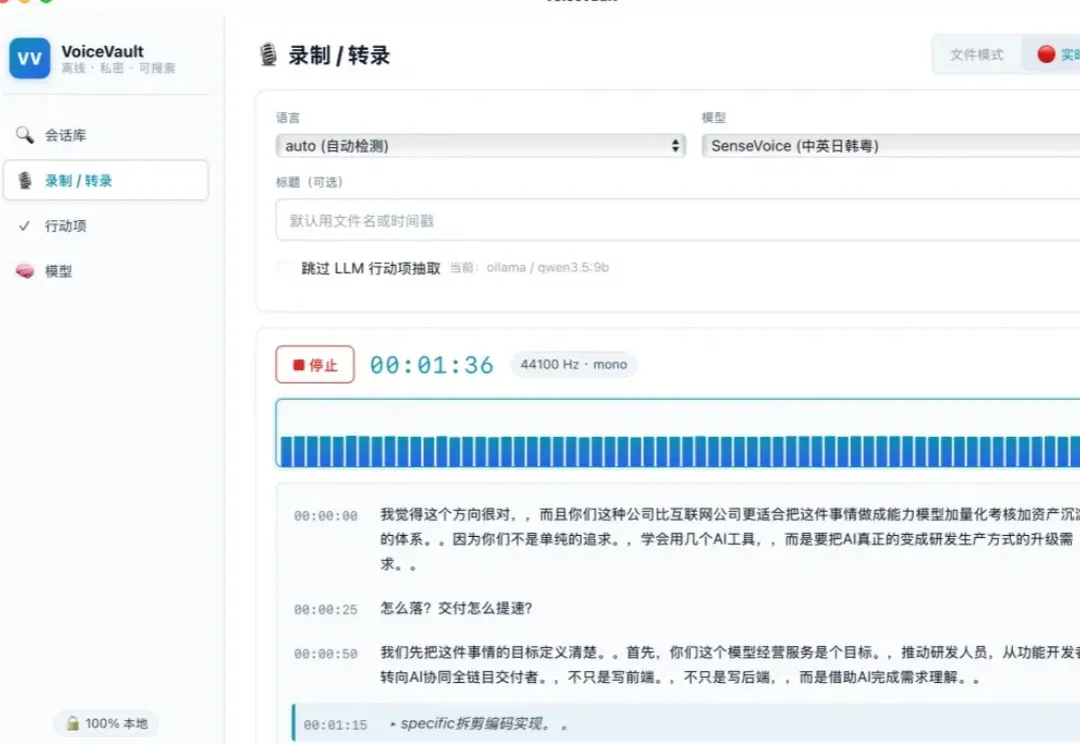
把 VoiceVault 的转录引擎从 Whisper 迁移到 FunASR(sherpa-onnx),中文识别速度提升 3x,不再需要 500MB 的模型文件。但"切个后端"这件听起来很简单的事,让我在 GitHub Release 的 404、Tauri 白屏、trait object 生命周期和 CSP 策略里翻滚了一整天。
《Nature Medicine》 的研究报道“A multimodal sleep foundation model for disease prediction”,研究人员开发了一种名为 SleepFM 的基础模型,从超过58万小时的记录中“学会”了睡眠的语言。这不仅是睡眠科学的进步,更是AI在生物医学领域的深层突围。
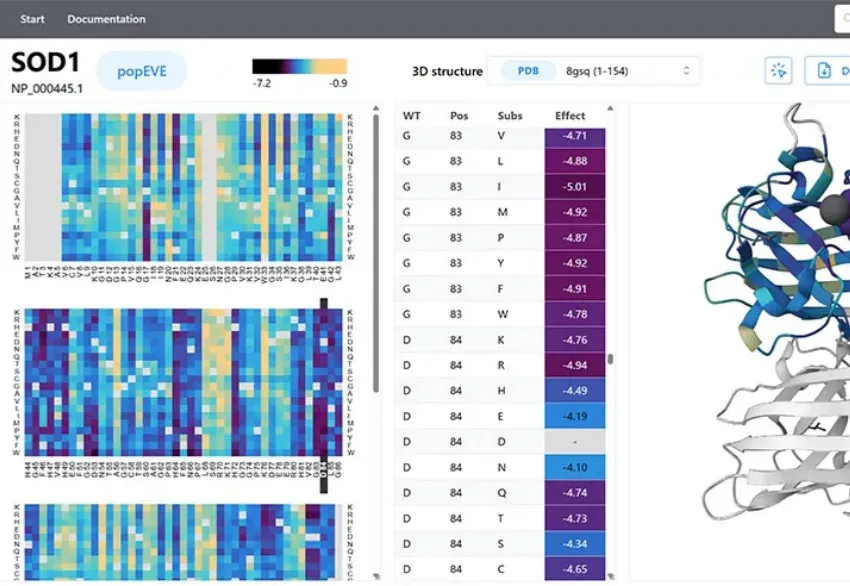
罕见病诊断一直是医学界的难题。 传统方法存在着检测流程复杂、报告解读困难等问题,约半数患者因缺乏明确病因治疗受阻。 近日,《Nature Genetics》期刊上发布了一项名为“Proteome-wide model for human disease genetics”的研究,哈佛医学院和巴塞罗那基因组调控中心(CRG)的研究人员开发出一款名为popEVE的AI蛋白质模型。 该模型是一款结合进化信息和人类群体数据的深度生成模型,能在全蛋白质组范围内评估变异的有害程度。有望彻底改变遗传疾病的诊断方式。 为验证模型效能,团队分析了超过3.1万个患有严重发育障碍的儿童家庭遗传数据。 在98%的病例
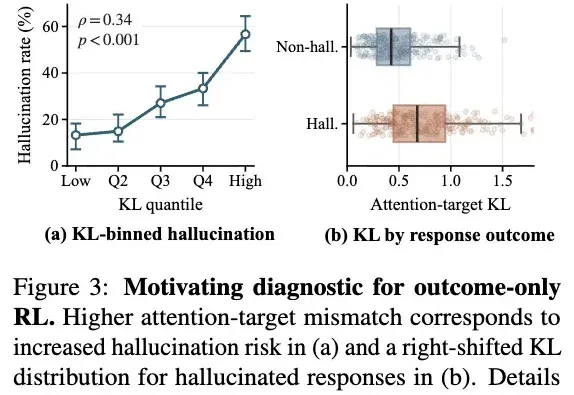
强化学习与可验证奖励(RLVR)已成为提升视觉语言模型(VLM)推理能力的标配手段。但一个隐蔽的问题始终存在:最终答案的奖励信号,只告诉模型「答对了没有」,却从不告诉它「答案应该从图像的哪个区域得出」。答对,可能是因为真的看懂了图,也可能只是语言先验的捷径、数据集的偏差,甚至是一次幸运的瞎猜。