刚刚,LeCun团队让世界模型学会持续学习! (opens in a new tab)
刚刚,纽约大学联合LeCun初创AMI带来JEPA系列的最新成果——AdaJEPA。与过去在预训练结束后就冻结参数的世界模型不同,AdaJEPA能够在与环境交互中,基于测试时自适应(Test-Time Adaptation, TTA),实时调整世界模型的编码器和预测器参数,从而实现持续学习。
Total 8 articles
刚刚,纽约大学联合LeCun初创AMI带来JEPA系列的最新成果——AdaJEPA。与过去在预训练结束后就冻结参数的世界模型不同,AdaJEPA能够在与环境交互中,基于测试时自适应(Test-Time Adaptation, TTA),实时调整世界模型的编码器和预测器参数,从而实现持续学习。
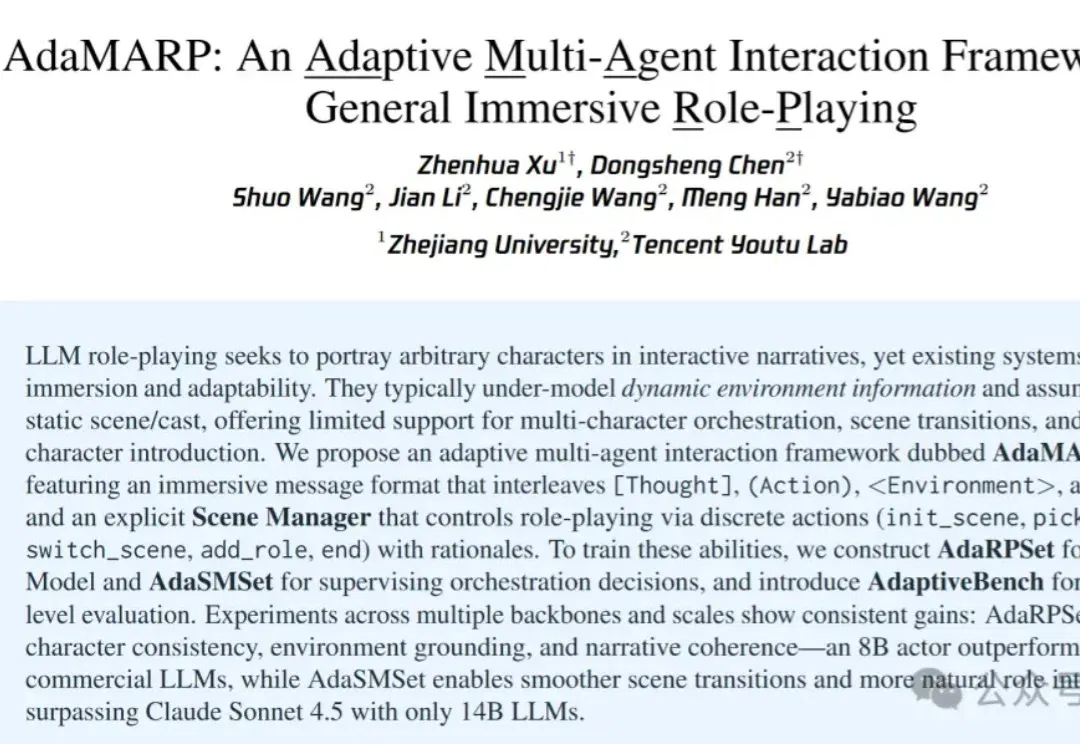
AI能实现真正的沉浸式扮演了。 大语言模型在角色扮演任务上进展迅速,但现有系统往往缺乏沉浸感和适应性: 环境信息未被充分建模,场景与角色也多为静态,难以支撑多角色调度、场景切换、动态引入新人等复杂叙事需求。 现在,浙江大学联合腾讯优图实验室提出AdaMARP(Adaptive Multi-Agent Interaction Framework for General Immersive Role-Playing)—— 一种面向通用沉浸式角色扮演的自适应多智能体交互框架。 该框架通过四通道消息格式和场景管理器,让AI不仅会「说」,还会「想」、会「动」、会「感知环境」,并在复杂叙事中灵活切换场景、
Anthropic联合Adaptyv Bio发起蛋白质设计公开赛并提供百万美元Claude积分,但初创公司Geodesic Intelligence(极奥智能)早一天就发布了百万美元现金悬赏的药物发现问题征集,且后者向全球开放参赛,不设国籍限制。
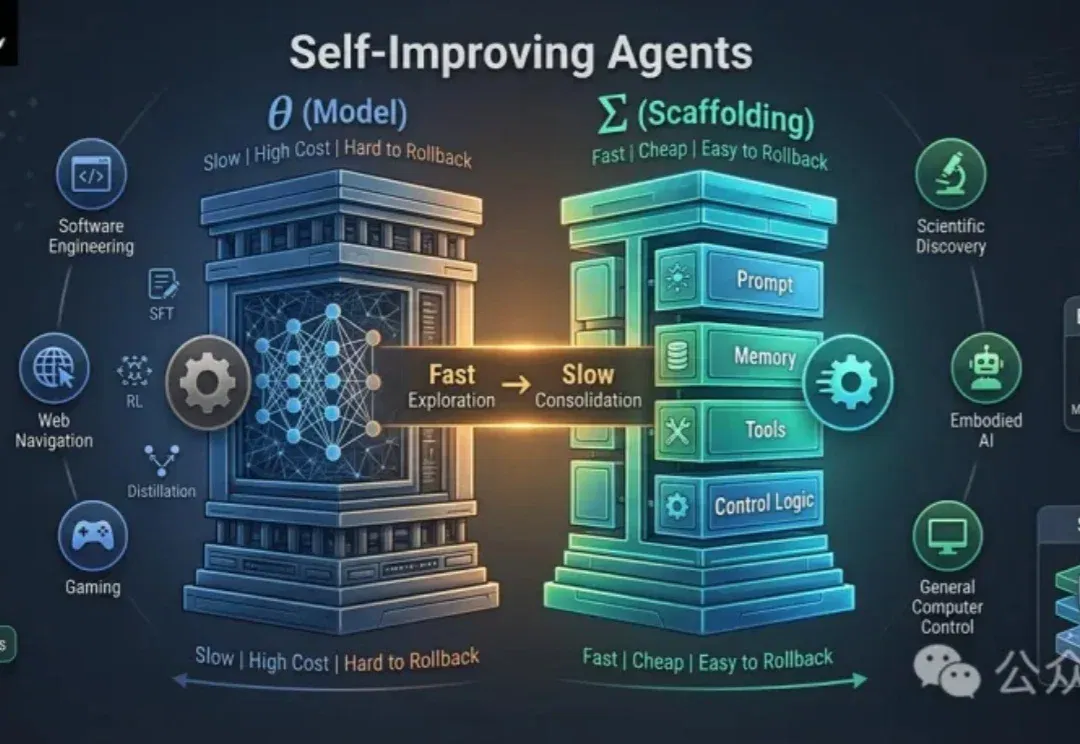
过去两年,self-reflection、self-correction、self-play、agentic RL、skill learning、test-time adaptation、open-ended evolution、self-evolving agent等概念不断涌现。
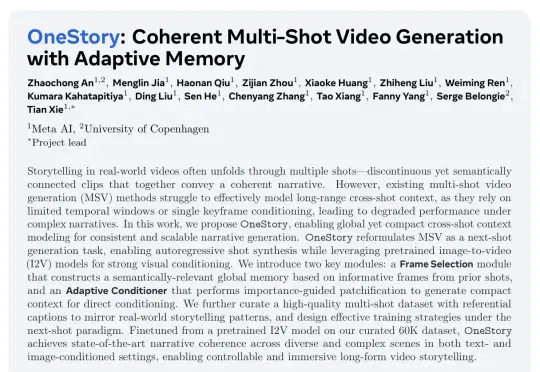
最近,来自Meta与University of Copenhagen的研究者提出了OneStory: Coherent Multi-Shot Video Generation with Adaptive Memory(收录于CVPR 2026)。这项工作聚焦于一个核心问题:如何在生成多镜头视频时,有效保留长程跨镜头上下文,从而实现更强的叙事一致性。
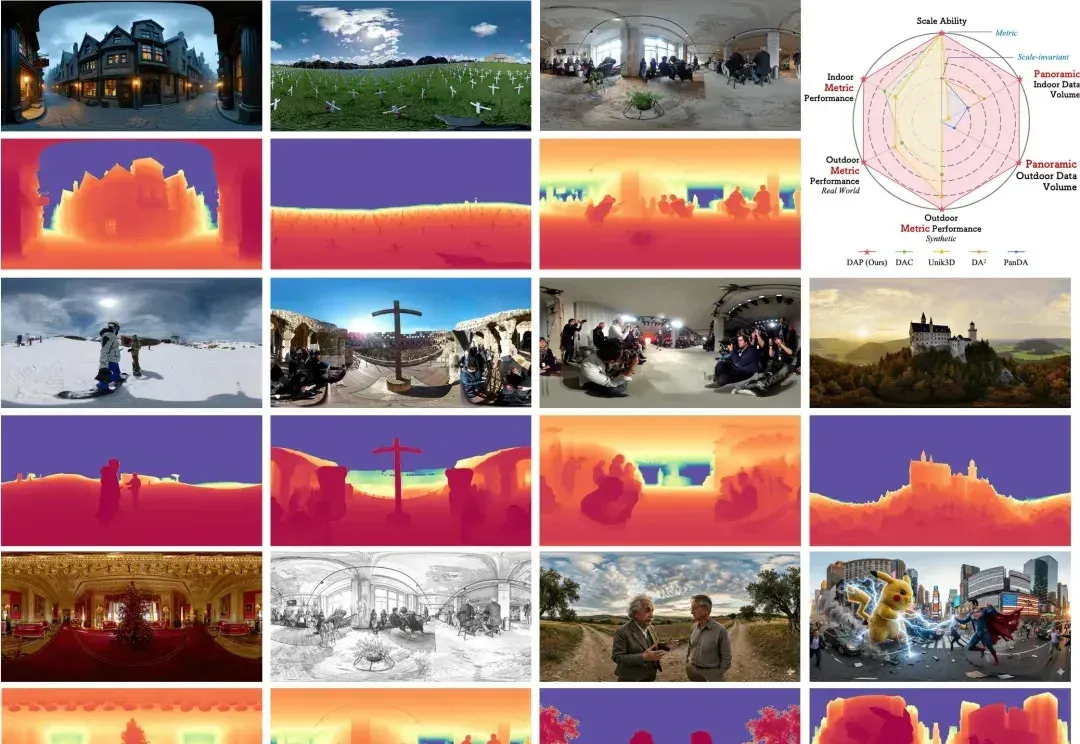
在空间智能(Spatial Intelligence)飞速发展的今天,全景视角因其 360° 的环绕覆盖能力,成为了机器人导航、自动驾驶及虚拟现实的核心基石。然而,全景深度估计长期面临 “数据荒” 与 “模型泛化差” 的瓶颈。
随着基础模型的日益成熟,AI领域的研发重心正从“训练更强的模型”转移到“构建更强的系统”。在这个新阶段,适配(Adaptation) 成为了连接通用智能与垂直应用的关键纽带。
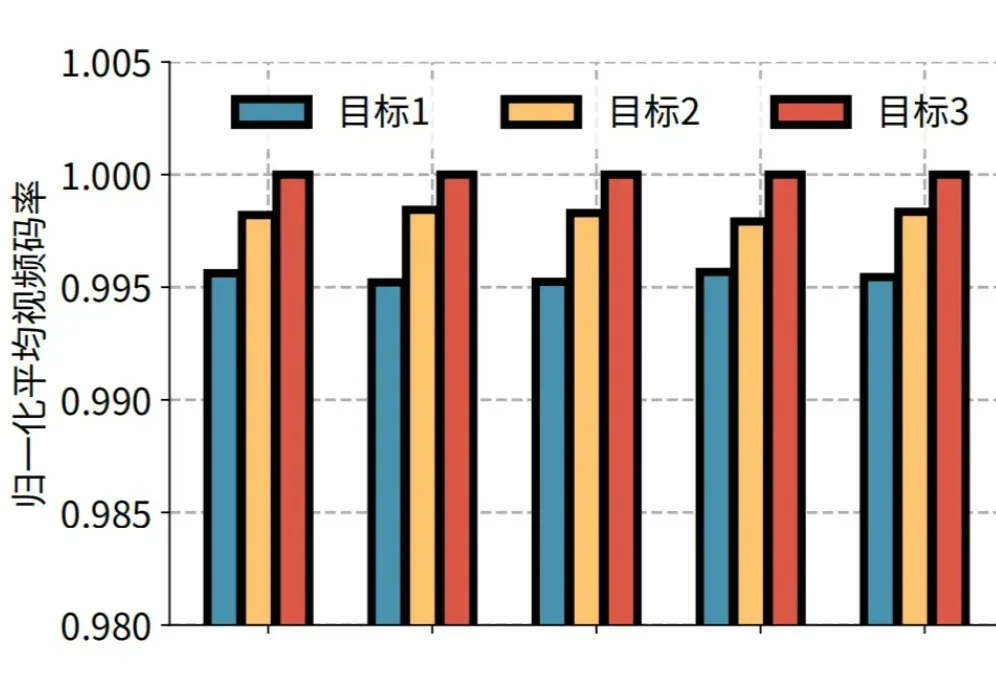
近日,快手与清华大学孙立峰团队联合发表论文《Towards User-level QoE: Large-scale Practice in Personalized Optimization of Adaptive Video Streaming》,被计算机网络领域的国际顶尖学术会议 ACM SIGCOMM 2025 录用。