Cursor 凌晨自曝黑科技:重写 MoE 生成机制,Blackwell 推理性能直接翻倍!网友:直接榨干B200最后一滴带宽! (opens in a new tab)
今天早上,Cursor 在X上发布一条推文:“我们重建了 MoE 模型在 Blackwell GPU 上生成 Tokens 的方式,导致推理速度快了 1.84 倍。”
Total 19 articles
今天早上,Cursor 在X上发布一条推文:“我们重建了 MoE 模型在 Blackwell GPU 上生成 Tokens 的方式,导致推理速度快了 1.84 倍。”
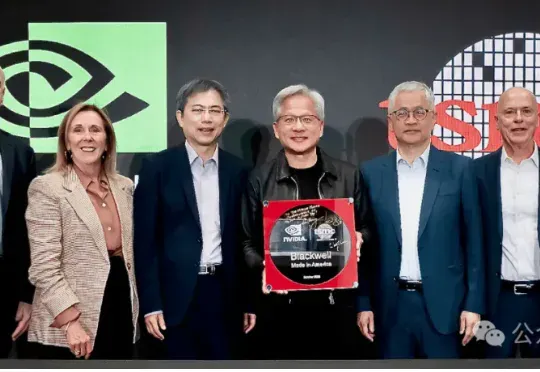
全球AI竞争的核心在于芯片制造。英伟达与台积电在美国亚利桑那工厂,历史性地亮相了首片用于AI的Blackwell芯片晶圆。标志着最强AI芯片首次实现「美国本土造」,是足以改变行业格局的里程碑,也象征着美国尖端制造业的回归。
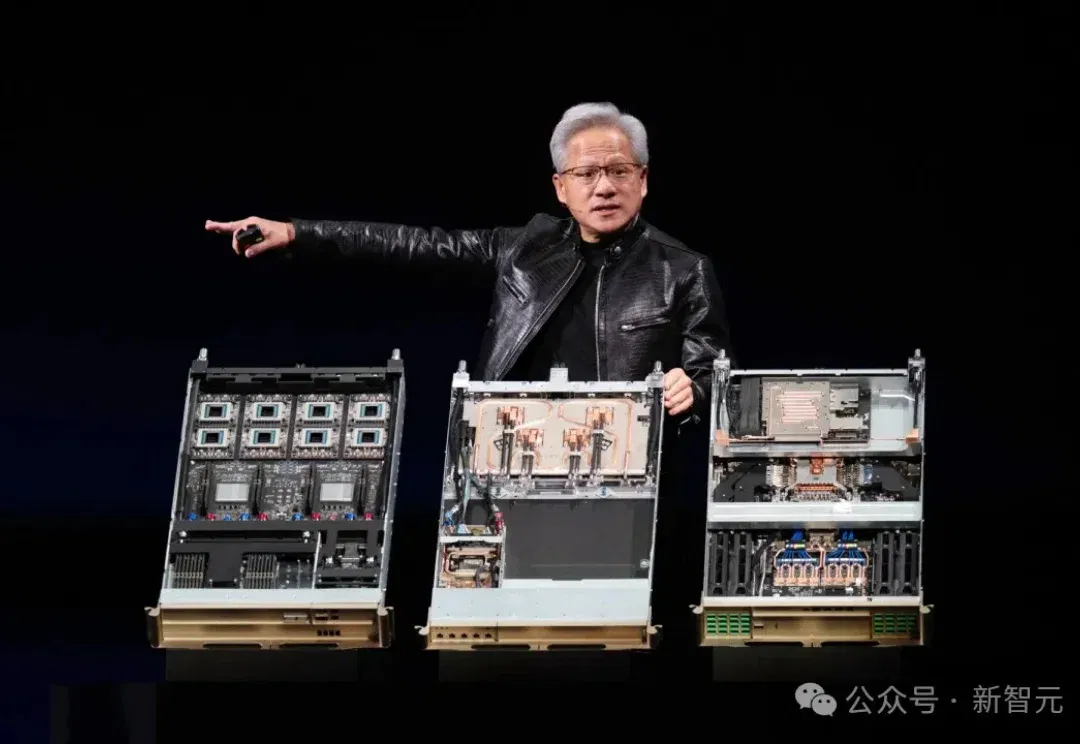
一台AI服务器,涨价超过15%! 刚刚,英伟达最大的几家客户集体收到了涨价通知单: 搭载英伟达AI芯片的服务器要涨价,很多配置涨幅直接超过15%,2027年初就生效;旗舰级的Vera Rubin和Grace Blackwell,也未能幸免。 提到AI服务器涨价,大多数人脑子里都会跳出这样一个画面:英伟达那颗几万美元一片的GPU。 但这波涨价,发通知的还真不是英伟达,而是那些替微软、谷歌、甲骨文组装机柜的代工厂。 他们最近一封接一封,把涨价通知发给了自己的客户。 英伟达那边还没吭声,代工厂这边先坐不住了。 可代工厂毕竟也只是个传话的,定价权根本不在他们手里。 Bloomberg援引匿名知情人士的
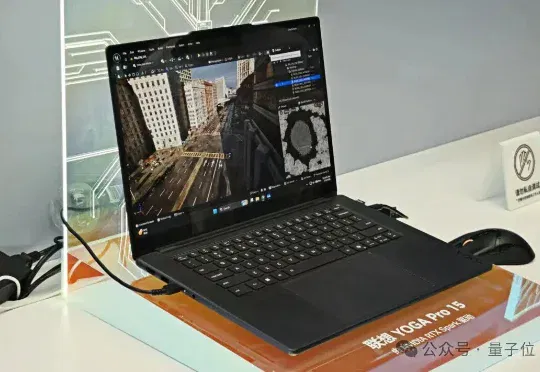
就在这届Bilibili World上,英伟达首次面向大众玩家展示了搭载RTX Spark超级芯片的笔记本电脑。这款芯片专为个人智能体打造,不仅搭载了Blackwell RTX GPU,连CPU也是出自英伟达的Grace CPU。
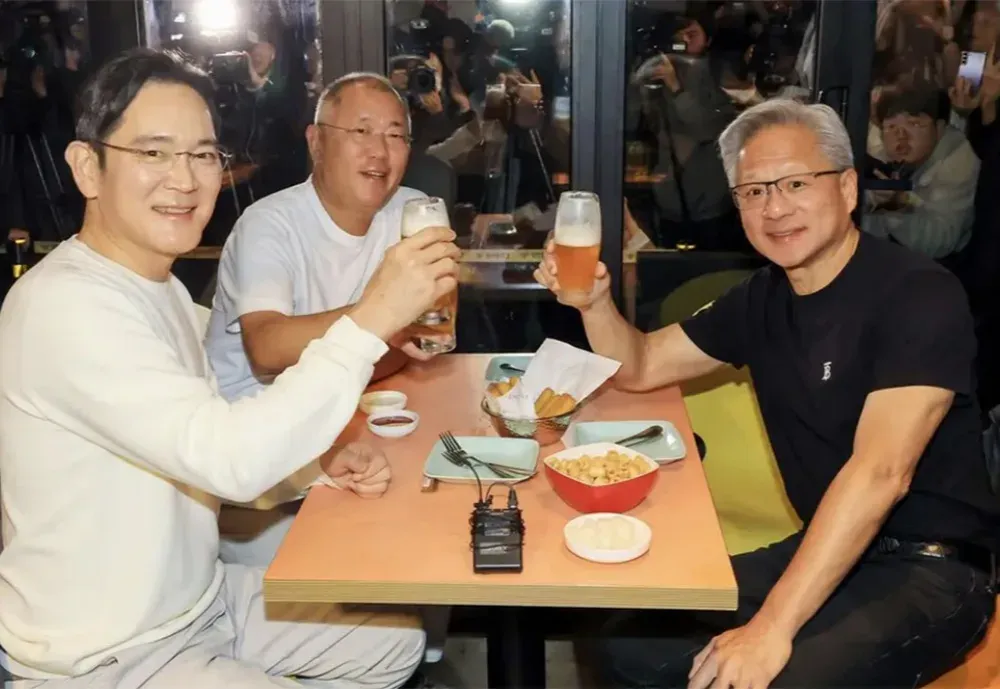
正与三星共同研发HBM4。 芯东西11月3日报道,英伟达在上周举行的APEC会议期间与韩国总统李在明以及三星、SK集团、现代汽车集团的高管会面,并宣布将向韩国政府及韩国大型企业供应超过26万块先进AI芯片。 韩国政府计划投资AI基础设施,采用超过5万块英伟达最新芯片;三星、SK集团、现代汽车也将分别在AI工厂中部署5万块AI芯片,用于半导体和汽车制造等领域;韩国互联网巨头Naver还将购买6万块英伟达芯片。 据韩联社报道,英伟达将向韩国政府及韩企供应的GPU主要是GB200 Grace Blackwell,还有一部分RTX 6000系列。据推算,英伟达供货总价值约为10万亿至14万亿韩元(约合
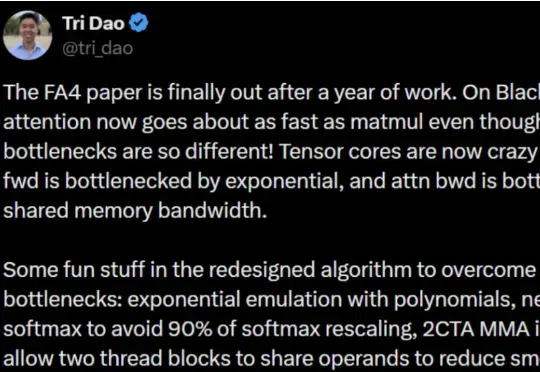
近日,深度学习领域重要底层优化技术 FlashAttention 迎来大版本更新。FlashAttention 核心作者、普林斯顿大学助理教授 Tri Dao 表示,在 Blackwell GPU 上,即使瓶颈截然不同,注意力机制的执行速度现在也几乎与矩阵乘法一样快了!
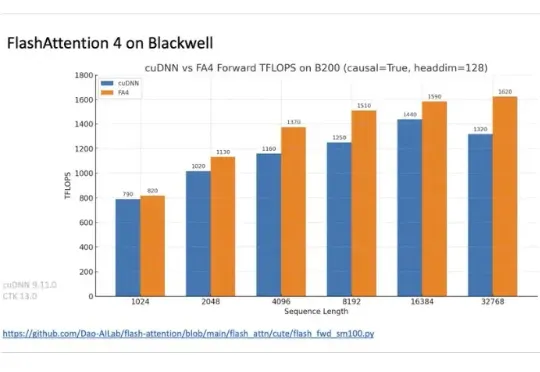
在正在举办的半导体行业会议 Hot Chips 2025 上,TogetherAI 首席科学家 Tri Dao 公布了 FlashAttention-4。
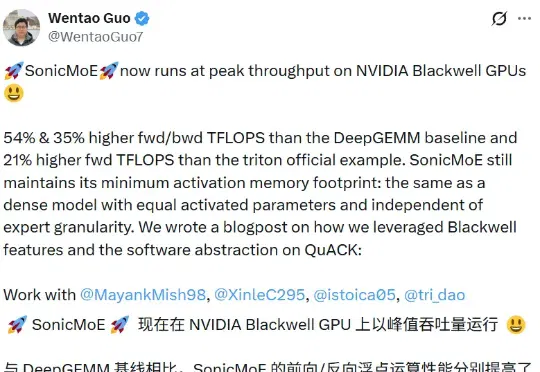
近日,由普林斯顿大学 Tri Dao(FlashAttention 的一作)和加州大学伯克利分校 Ion Stoica 领导的一个联合研究团队也做出了一个超快的索尼克:SonicMoE。据介绍,SonicMoE 能在英伟达 Blackwell GPU 上以峰值吞吐量运行!并且运算性能超过了 DeepSeek 之前开源并引发巨大轰动的 DeepGEMM。
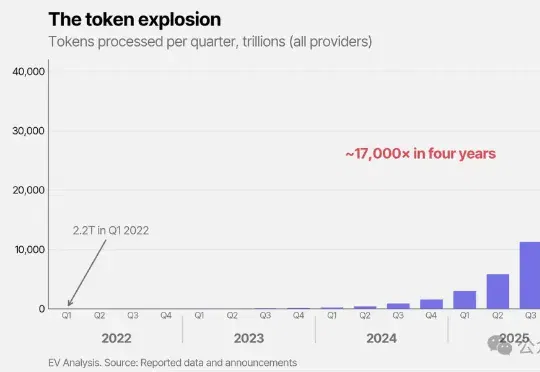
Epoch AI刚刚发布的《梯度更新》报告,做了一件简单粗暴的事:把全球所有Blackwell芯片能处理的Token数量算出来,再和实际需求一比。结论只有一个字——不够。
众所周知,大模型训练成本极高。 但大家又知道,降低训练精度能够显著降低训练成本。DeepSeek-V3 用 FP8 训练把成本打到了 560 万美元,已经让全行业侧目。 在 FP8 成功后,行业仍然在不断探索低精度的边界:从 FP8 降到 FP4,训练成本还能再降多少? 理论上,FP4 的计算吞吐可以是 FP8 的两倍。NVIDIA Blackwell 和 AMD MI350 系列都已经在硬件层面原生支持了 FP4 运算,前者在 B200 上标称 FP4 算力可达 4500 TOPS(稀疏)。硬件已经准备好了,但软件和算法那一侧,一直卡在一个问题上: 用 FP4 从头训练大模型,训练过程非常不