给音视频生成打草稿!复旦&腾讯提出Baton:首创语义蓝图指引,实现音画逻辑精准同步 (opens in a new tab)
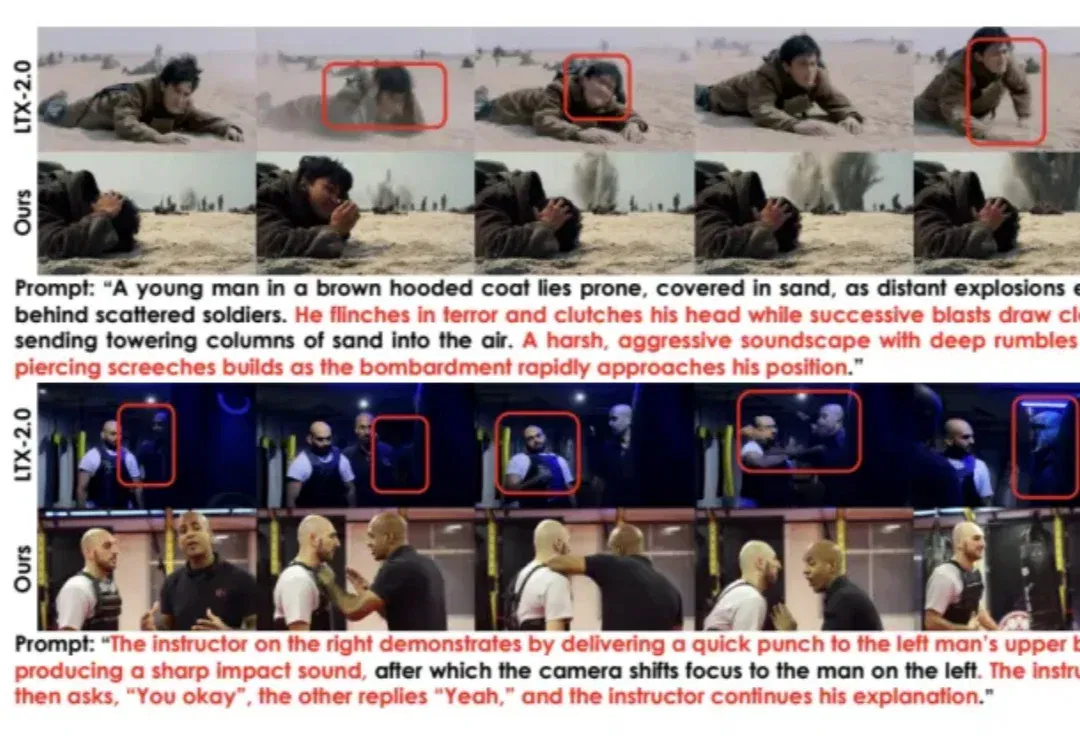
当用户给出一句简单提示词时,当前的音视频生成模型往往已经能够生成具有不错质量的视听内容。然而,一旦提示词变得复杂,问题便开始暴露出来。
Total 2 articles
当用户给出一句简单提示词时,当前的音视频生成模型往往已经能够生成具有不错质量的视听内容。然而,一旦提示词变得复杂,问题便开始暴露出来。
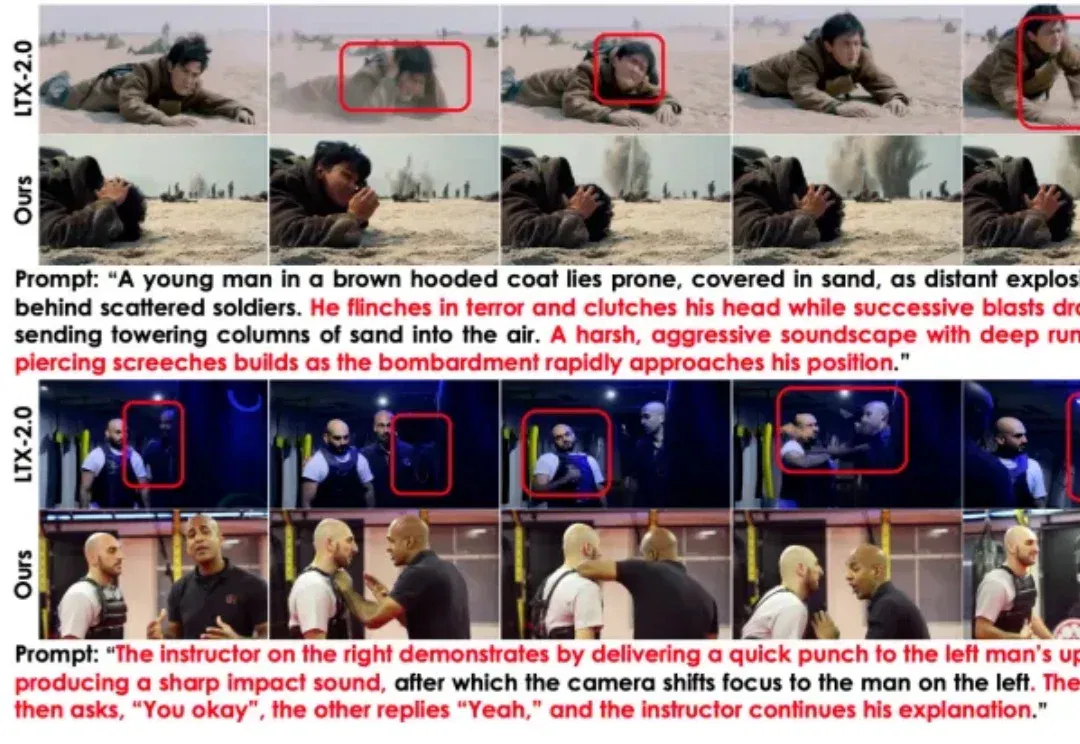
视频生成,早已不止于视觉。 随着生成式AI发展,联合视频—音频生成正成为重要研究方向。与视频优先、音频后期合成的传统流水线相比,原生同步生成的视听内容跨模态一致性更强,用户体验更沉浸。 但问题在于,现有开源模型面对复杂语义时力不从心。 遇到多阶段动作的组合式指令、涉及人与物体交互的复杂任务时,模型往往无法准确建模场景中的时序逻辑和因果关系——不仅要求长程语义推理能力,还必须在推理中维持视频与音频的时空一致性。 核心矛盾在于:现有方法依赖粗粒度全局文本嵌入指导扩散过程,无法将多阶段动作与多说话人对话分解为具有时间对齐的指导信息,视频和音频去噪轨迹因此各自演化,最终跨模态失配。 为解决这一问题,复