一兆瓦养活6万智能体!英伟达GB300碾压前代20倍 (opens in a new tab)
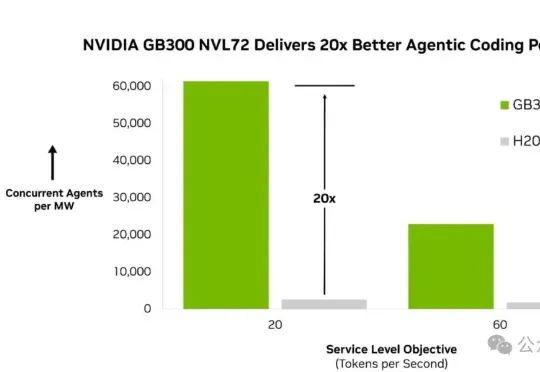
同样一兆瓦电,英伟达最新的GB300 NVL72能同时扛住61400个智能体,上一代H200只扛得住大约2600个。这中间,差了整整20倍。它就是独立评测机构Artificial Analysis发布的新基准:AA-AgentPerf。
Total 9 articles
同样一兆瓦电,英伟达最新的GB300 NVL72能同时扛住61400个智能体,上一代H200只扛得住大约2600个。这中间,差了整整20倍。它就是独立评测机构Artificial Analysis发布的新基准:AA-AgentPerf。

英伟达死守的推理性价比神话,碎了。 就在刚刚,SemiAnalysis发布了谷歌第七代TPU Ironwood的首份第三方推理性能测算。 在完全对等的模型负载下,TPU的每美元性能最高领先英伟达B200达50%,对B300的领先幅度更是逼近翻倍的96%! 外部TCO口径下每百万token成本 vs 交互速度 换算成业界最敏感的每百万Token成本,差距触目惊心。 TPU仅需0.181美元,B200为0.222美元,B300则高达0.276美元。 更戏剧性的,是时间。 今年4月,黄仁勋在Dwarkesh播客上宣称TPU与Trainium都不敢来跑分。他甚至公开鼓励挑战者使用InferenceMA
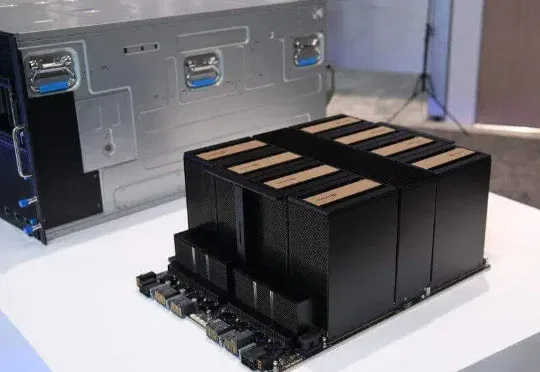
最近的B300市场可以说是“冰火两重天”——群里叫卖得火热,实际成交却降至冰点。老美的出口管制如同悬在头顶的达摩克利斯之剑,彻底改变了顶级算力芯片的流通逻辑。 以下是基于近期一线实操、买卖双方博弈以及
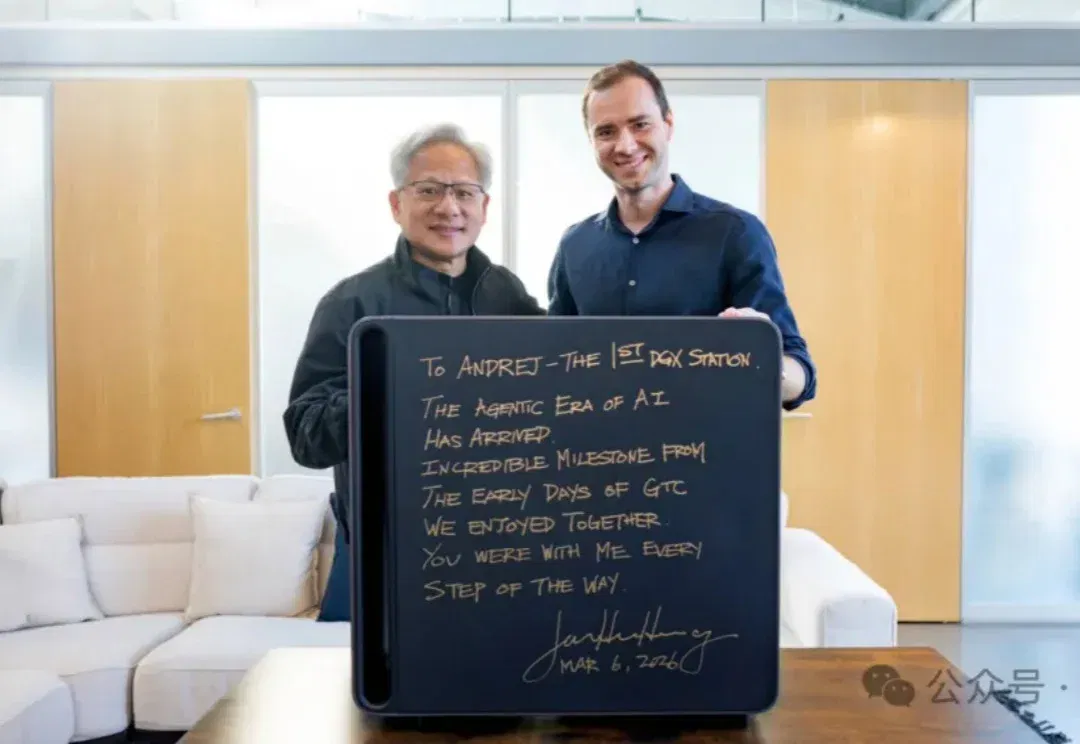
老黄又又又亲自上门送“显卡”了! 首台DGX Station(GB300)送给了卡帕西——这位AI时代的个人开发者代表。 △图源:英伟达官方博客 注意到没,就在这台“大玩具”上,老黄还附赠了一篇洋洋洒洒的“小作文”: 致Andrej——第一台DGX Station的拥有者: AI智能体时代已经到来,这是一个令人难以置信的里程碑时刻,也让人想起我们一起走过的GTC早期岁月。 一路走来,你始终与我并肩同行。 而另一边,卡帕西也在𝕏上对老黄隔空发射爱心,并且透露自己准备用它搭一套个人AI集群,专门拿来折腾各种有意思的实验。 对了,针对老黄提到的“GTC早期岁月”,卡帕西还顺带解惑了一波: 后来的事
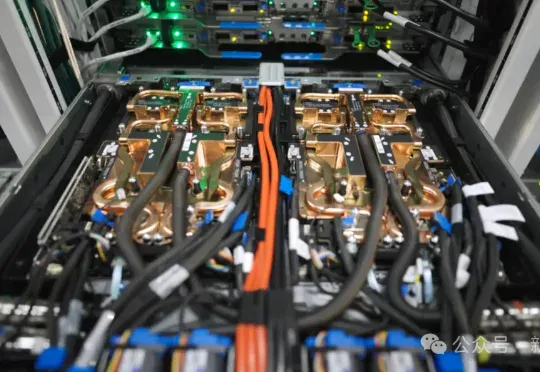
为了争夺有限的GPU,OpenAI内部一度打得不可开交。2024年总算力投入70亿美元,但算力需求依旧是无底洞。恰恰,微软发布了全球首台GB300超算,专供OpenAI让万亿LLM数天训完。
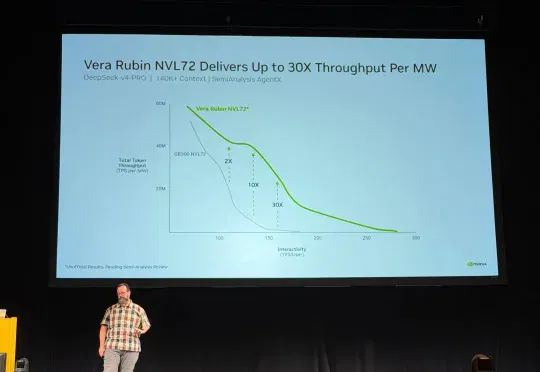
就在刚刚,英伟达史上首次公布了下一代旗舰级机柜 Vera Rubin NVL72 的首次片上实测数据。而且,这次实测直接拉来了DeepSeek-V4-Pro,跑最真实的「智能体编码」任务!结果令人吃惊:对比当前的主力机皇GB300 NVL72,Vera Rubin的每兆瓦吞吐量最高飙升了30倍、Token成本最高暴降了35倍!
就在刚刚,OpenAI首颗自研芯片Jalapeño「墨西哥辣椒」,交出了首批实测成绩单——AI推理性能,全面反超英伟达GB200和GB300。实测速度直接起飞!Jalapeño一秒能狂吐1459个Token,英伟达GB200只有535个,连一半都不到。
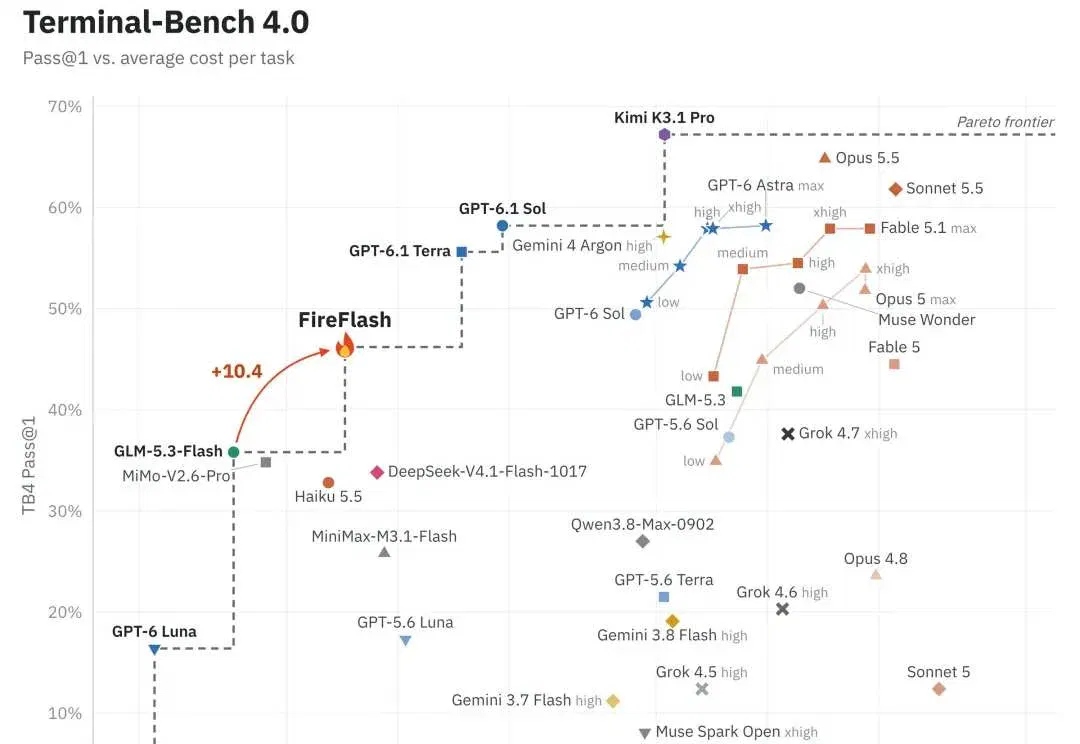
The team post-trains GLM-5.3-Flash using task filtering, asynchronous sampling, and a shared runtime framework, reporting terminal and software engineering benchmark results and estimated costs.
马斯克深夜掀桌!最强旗舰Grok 4.5突袭,数万块GB300炼出性价比之王,不仅硬刚GPT-5.5,性能紧贴Opus 4.8,又快又便宜。这一次,SpaceXAI与Cursor强强联手。成绩单相当亮眼——