Depth Anything再出新作!浙大&港大出品:零样本,优化任意深度图 (opens in a new tab)
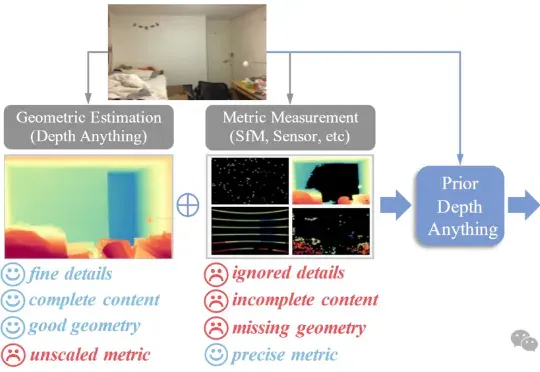
浙江大学与港大团队推出「Prior Depth Anything」,把稀疏的深度传感器数据与AI完整深度图融合,一键补洞、降噪、提分辨率,让手机、车载、AR眼镜都能实时获得精确三维视觉。无需额外训练,就能直接提升VGGT等3D模型的深度质量,零样本刷新多项深度补全、超分、修复纪录。
Total 19 articles
浙江大学与港大团队推出「Prior Depth Anything」,把稀疏的深度传感器数据与AI完整深度图融合,一键补洞、降噪、提分辨率,让手机、车载、AR眼镜都能实时获得精确三维视觉。无需额外训练,就能直接提升VGGT等3D模型的深度质量,零样本刷新多项深度补全、超分、修复纪录。
这两天,GitHub 上一个叫 REA(Reverse Engineer Anything)的项目狂揽了近 7 万颗星!
8 月 7 日晚上 10 点,MiniMax H3 团队来到 Reddit 的 r/StableDiffusion 社区举行 AMA(Ask Me Anything)。参与此次交流的包括 H3 研究负责人 dacongya,研究员 Luigi、Nero、Kiro,系统工程师 Reynor,以及 MiniMax 开发者关系负责人 Ryanlee。
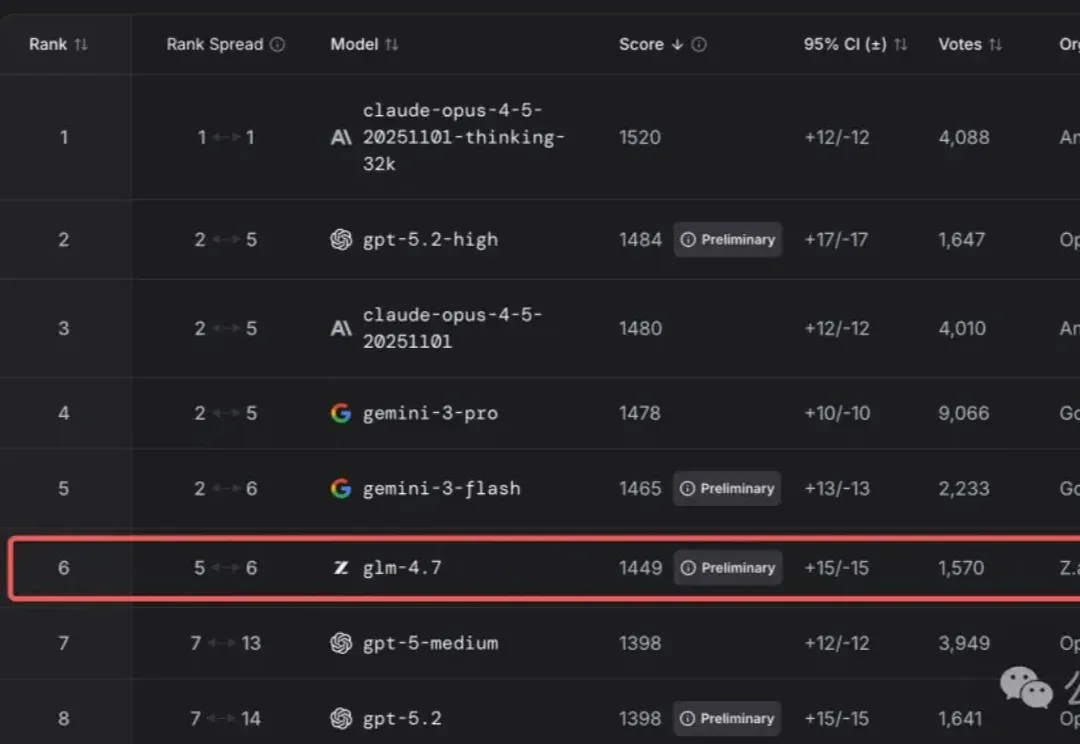
真是越到年底,越是神仙打架。 这不,智谱又又又发了新模型——GLM-4.7。 然后一举在代码竞技场WebDev榜单上超越GPT-5.2,拿下开源大模型第一! 现在网友们也正在拿它疯狂实测中,体验完几乎都是清一色的“Amazing”。 直接来感受一下网友拿着GLM-4.7和Gemini 3同时做的桌版溜溜球游戏,让网友直呼: GLM-4.7完胜! 那么,为什么GLM-4.7这次会在编程效果上有这么大的进步? 就在今天早些时候,智谱还特意在Reddit上举办了一场AMA(Ask Me Anything)活动,关于背后的一切,都已经回答得清晰明了。 关于GLM-4.7,智谱回答一切 这场对话不仅揭示
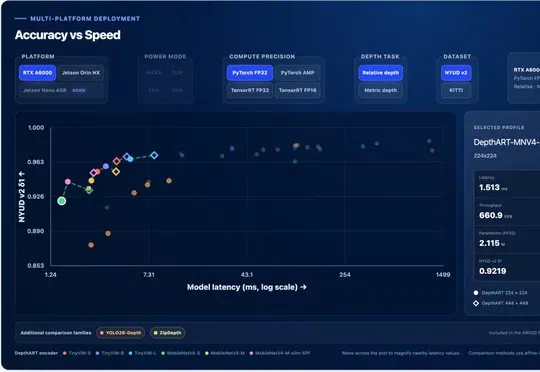
论文DepthART提出抗偏置数据采样与相机条件化微调方法,将基础单目深度估计模型压缩至约6M参数,在保留跨场景泛化能力的前提下实现Jetson等端侧设备的高帧率部署。
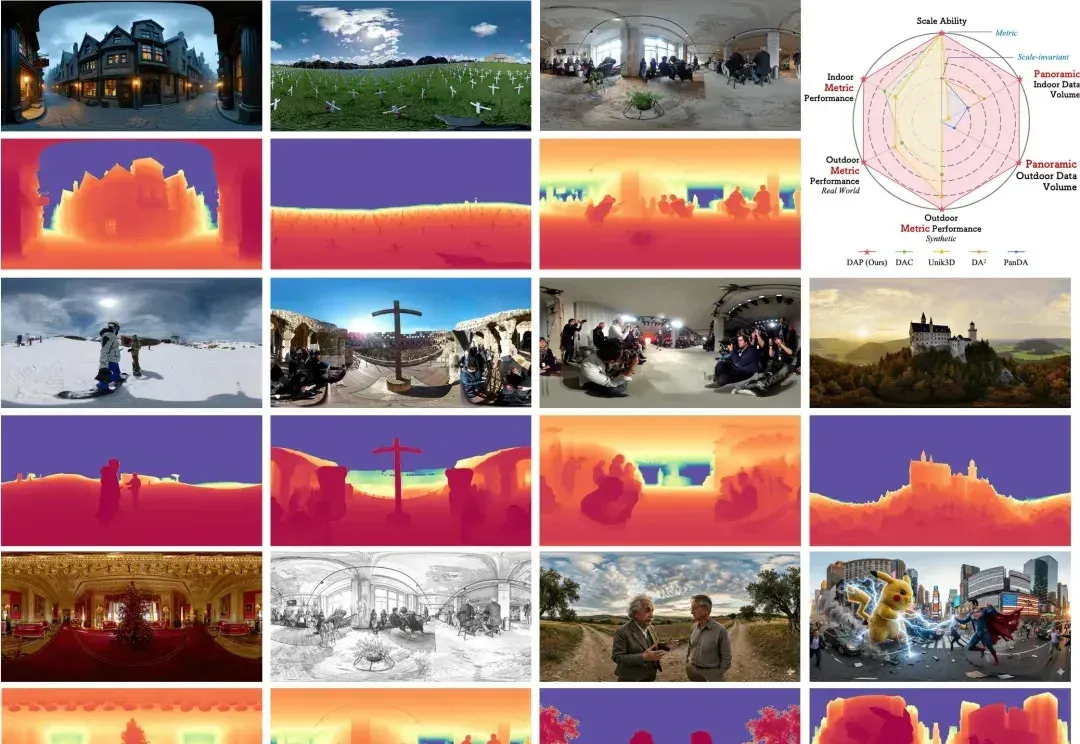
在空间智能(Spatial Intelligence)飞速发展的今天,全景视角因其 360° 的环绕覆盖能力,成为了机器人导航、自动驾驶及虚拟现实的核心基石。然而,全景深度估计长期面临 “数据荒” 与 “模型泛化差” 的瓶颈。
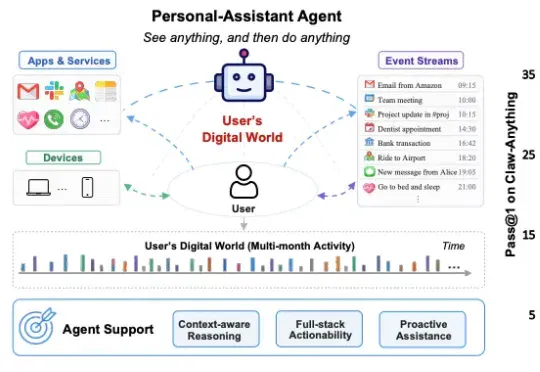
我们相信,常驻型 (always-on) AI 助理的下一次飞跃,不在于把某一个模型单点调得更聪明,而在于扩展智能体的上下文 (Scaling Agent Context)—— 不断拓宽助理能够持续 "感知 — 推理 — 执行" 的范围,作为生活连接器连接用户的信息孤岛,直到它能接管用户的整个数字世界。
机器之心报道 编辑:泽南、杨文 现在,只需要一个简单的、用深度光线表示训练的 Transformer 就行了。 这项研究证明了,如今大多数 3D 视觉研究都存在过度设计的问题。 本周五,AI 社区最热
当下计算机视觉长期陷入“一任务一专用模型”内卷: 做深度估计要用DepthAnything,分割依赖SAM,人体姿态单独训练Sapiens,几何重建还得搭VGGT,各类网络骨干、解码器、损失函数完全割裂,研发与部署成本居高不下。
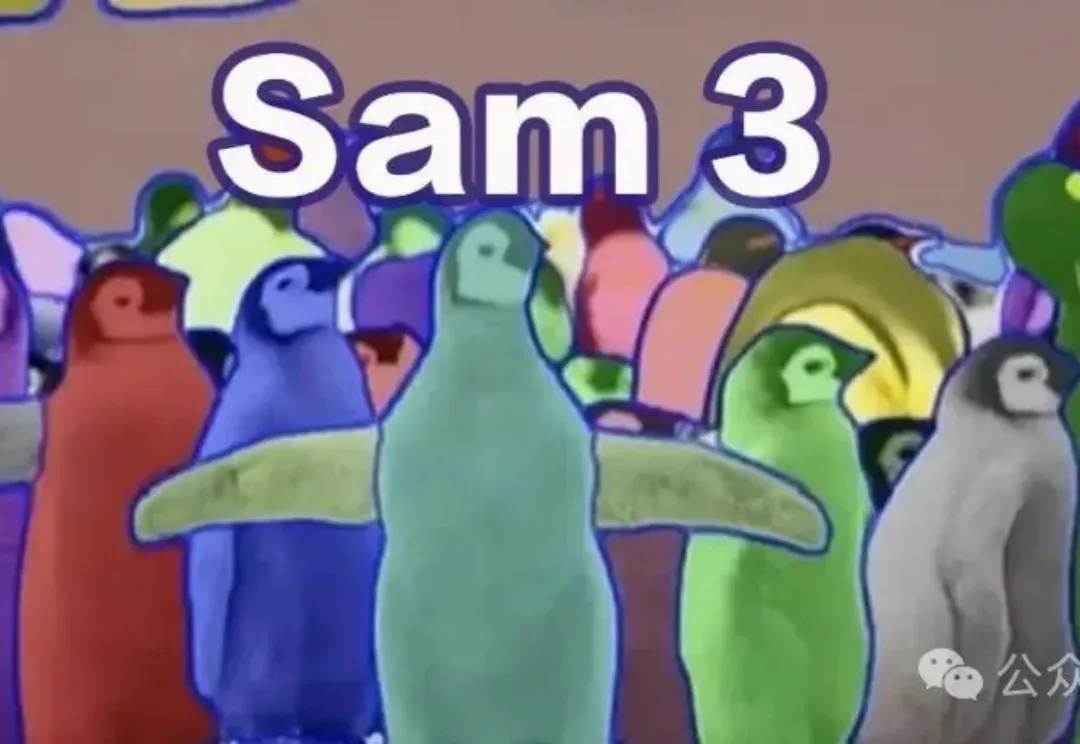
2023年Meta推出SAM,随后SAM 2扩展到视频分割,性能再度突破。近日,SAM 3悄悄现身ICLR 2026盲审论文,带来全新范式——「基于概念的分割」(Segment Anything with Concepts),这预示着视觉AI正从「看见」迈向真正的「理解」。