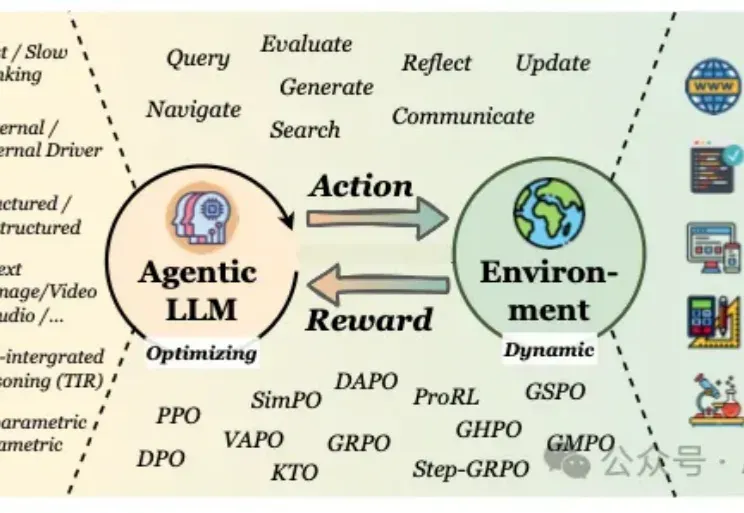
Agent的RL和LLM的RL是一回事吗?牛津用500+论文写成综述,一次说清Agentic RL (opens in a new tab)
当我们谈论大型语言模型(LLM)的"强化学习"(RL)时,我们在谈论什么?从去年至今,RL可以说是当前AI领域最炙手可热的词汇。
Total 5 articles
当我们谈论大型语言模型(LLM)的"强化学习"(RL)时,我们在谈论什么?从去年至今,RL可以说是当前AI领域最炙手可热的词汇。
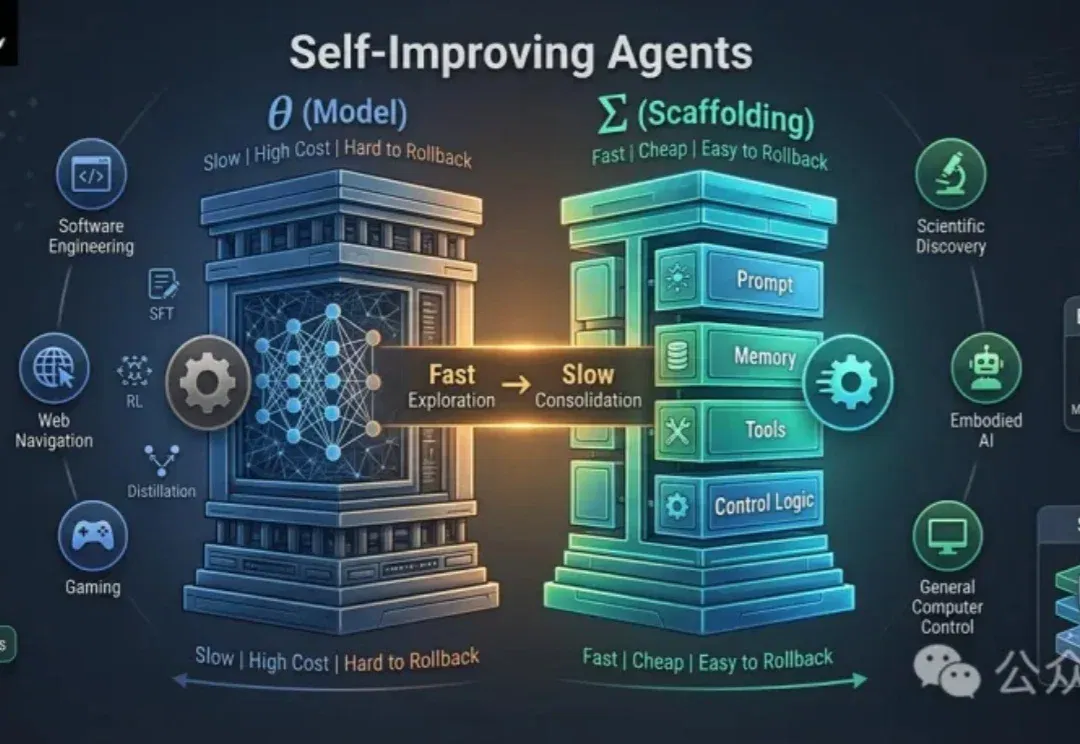
过去两年,self-reflection、self-correction、self-play、agentic RL、skill learning、test-time adaptation、open-ended evolution、self-evolving agent等概念不断涌现。
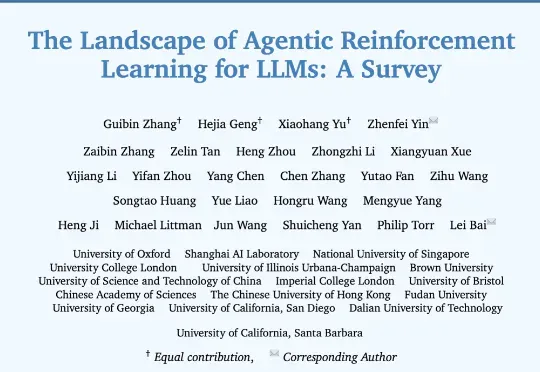
来自牛津大学、新加坡国立大学、伊利诺伊大学厄巴纳-香槟分校,伦敦大学学院、帝国理工学院、上海人工智能实验室等等全球 16 家顶尖研究机构的学者,共同撰写并发布了长达百页的综述:《The Landscape of Agentic Reinforcement Learning for LLMs: A Survey》。
提起马卡龙,你会想到什么?是橱窗里的精致甜点,一种“少女心”的味觉象征?还是代表了温柔优雅的时尚配色?当一个AI产品也被命名为“马卡龙”,这份联想便悄然发生了偏移:从舌尖的甜,转向科技的未知,却又奇妙地保留了那一份色彩与气质。
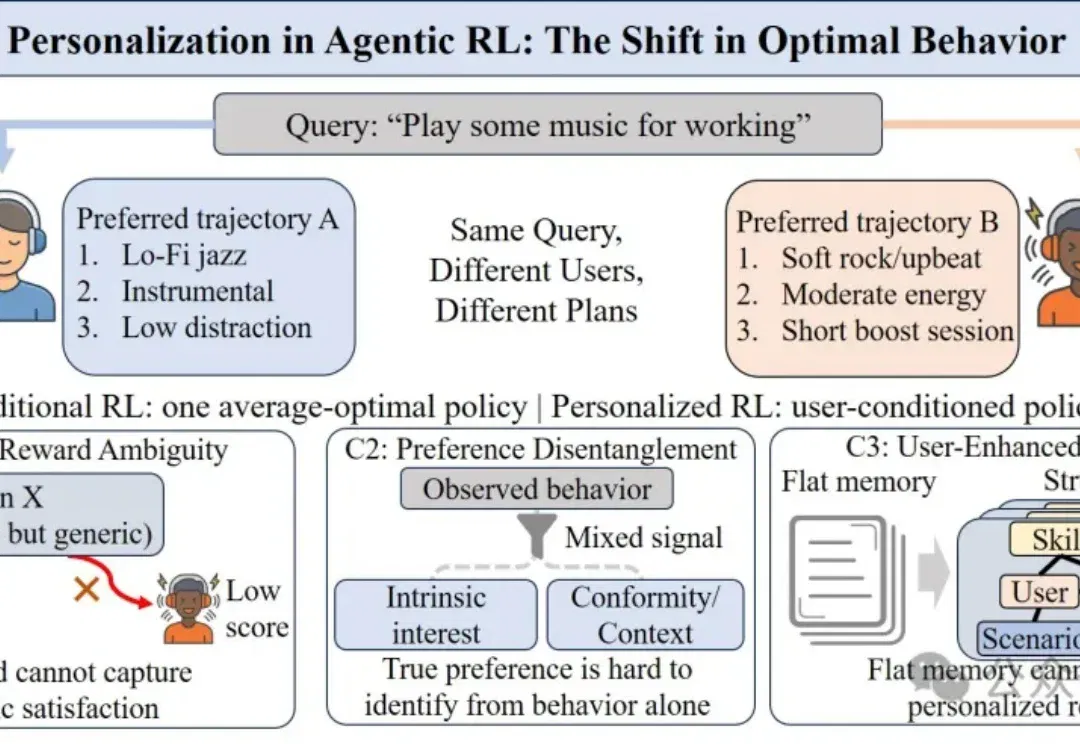
当个性化Agentic RL遇上现实用户平台场景时,一直存在一个常见难点:面对同样的query,不同用户往往偏好不同的规划策略、工具调用和最终表达。