快手发布旗舰级的Agentic Coding模型KAT-Coder-Pro V2.5,可以接入claude code (opens in a new tab)
国产Coding模型杀疯了!实测1分20秒闭环真实Bug,1395行代码徒手捏出《我的世界》,长程工程能力直逼Opus 4.8,不用再当AI保姆了。这款装入CC的AI,就是快手发布的KAT-Coder-Pro V2.5,一款旗舰级的Agentic Coding模型。
Total 9 articles
国产Coding模型杀疯了!实测1分20秒闭环真实Bug,1395行代码徒手捏出《我的世界》,长程工程能力直逼Opus 4.8,不用再当AI保姆了。这款装入CC的AI,就是快手发布的KAT-Coder-Pro V2.5,一款旗舰级的Agentic Coding模型。
刚刚,阿里旗下的Qoder正式推出了Qoder Security,直击AI Coding的安全风险问题。在这个工具中,代码安全内生于 Qoder,贯穿从编码到提交的每一步。Qoder Security的发布,让Qoder成为国内首个交付「编码会话内三层安全护航 + 发现问题同会话修复」能力Agentic Coding产品。
“很正确,无比正确” 当我们问起阿里巴巴 Qoder[1] (Agentic Coding 产品)创始人叔同,关于他带领团队冲入全球 AI Coding 这片“红海” 60 天后的感受时,他给出了这样简单而坚定的回答。他的底气,源自一份优秀的成绩单:上线 5 天用户迅速突破 10 万,仅 60 天斩获 50 万开发者用户。
开源模型同样能承担复杂工程任务。 如果你问一个开发者,AI 编程最让人崩溃的时刻是什么? 他给你的答案很可能会是它在报错面前那句机械的「对不起,我理解错了」,然后复读一段同样错误的代码。 过去一年,Coding 大模型的进步,更多体现在「生成能力」上:一句话生成网页、组件、小游戏——15 秒内搓出一个像素风网页、一个炫酷的 SVG 图标,或者一个能跑的贪吃蛇。这些 Demo 足够惊艳,但也足够「轻」,它们有点像是在 Vibe Coding(氛围感编程)时代产出的高级玩具。但当涉及到高并发架构、底层驱动适配或者复杂的系统重构,它们就成了「温室里的花朵」。 所以最近,硅谷的风向已经变了。 不管是
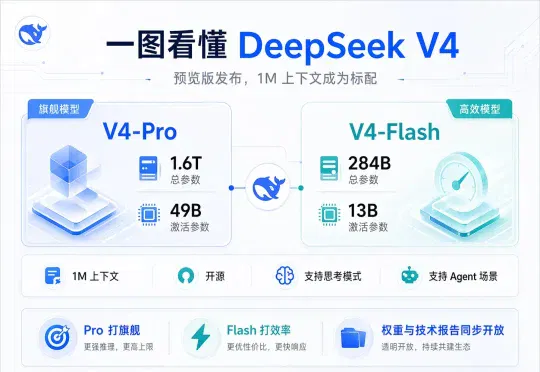
Agentic Coding 评测里 V4-Pro 已经到当前开源最佳水平。DeepSeek 公司内部已经把 V4 作为默认编码模型,反馈是优于 Sonnet 4.5,交付质量接近 Opus 4.6 的非思考模式,和 Opus 4.6 的思考模式还有差距。这次还专门为 Claude Code、OpenClaw、OpenCode、CodeBuddy
全球最强编程模型,中国造。 你可以从同事.skill 的爆火中看到两种截然不同的时代情绪,其一固然是对 Markdown 文件“大变活人”这一魔幻现实的试探,而反面则是如今对模型能力的评价,已经离不开工作级任务的场景。 “AI 能不能替代程序员”的老生常谈之下,今天的真问题是,国产大模型能在多大程度上接管开发工作流。 这背后是一个被反复验证的痛点:当 AI Agent 被放进真实项目,它并没有想象中那么“能扛活”。它能开始任务,但执行过程反复中断,多轮对话后上下文丢失,结果前后不一致。面对非标准需求时,工具调用也频频失误。你一觉醒来,发现流程早已卡死,标准结局总是如此。 问题的根源不在 Age
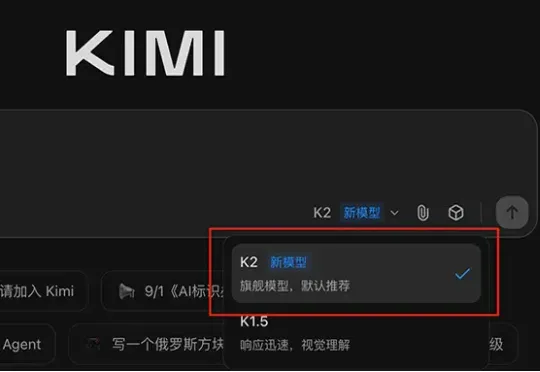
智东西9月5日消息,刚刚,大模型独角兽月之暗面发布新模型Kimi K2-0905,目前,Kimi应用和网页版中的K2模型已全量升级到Kimi K2-0905。该模型的核心升级点为Agentic Coding能力增强、支持256K上下文、API支持高达60-100Token/s的输出速度、支持Claude Code。
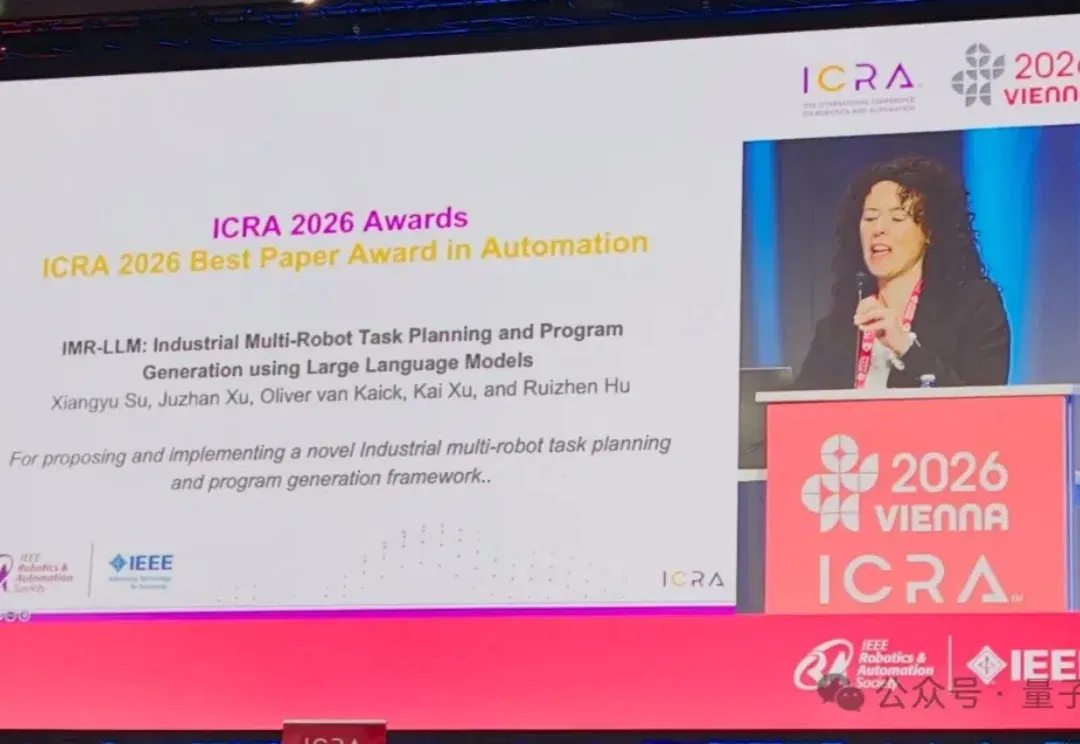
刚刚,在维也纳落幕的机器人顶会ICRA 2026上,最佳论文奖(自动化方向)颁给了一支中国团队。
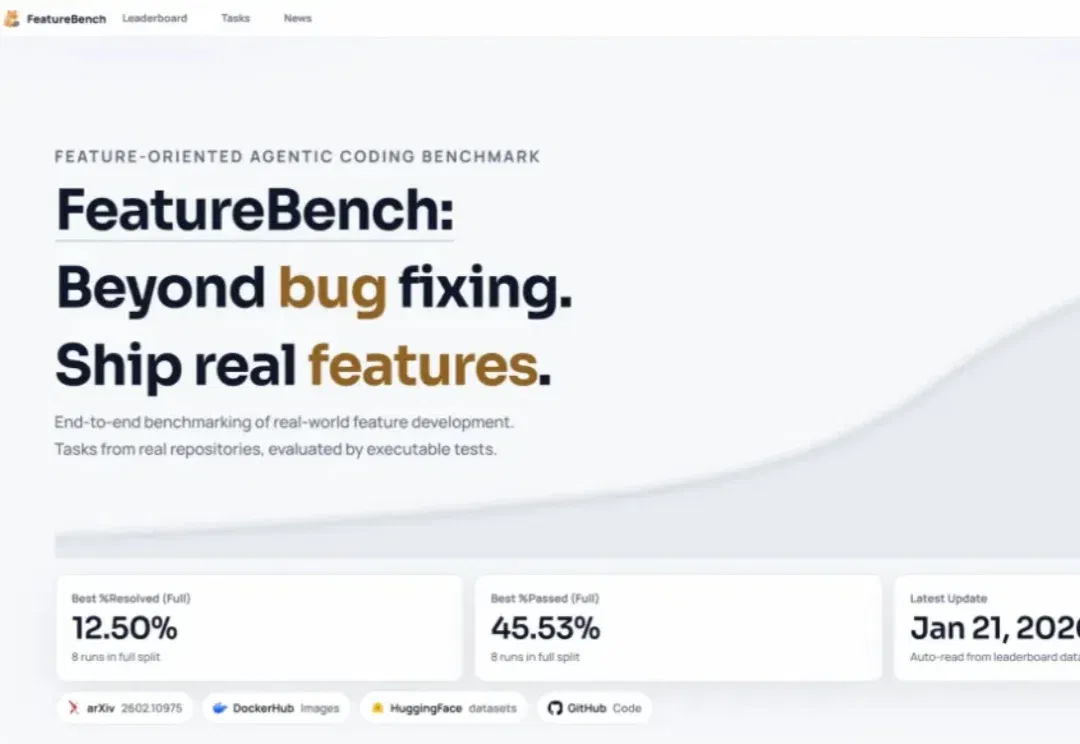
在 Princeton 发布 SWE-Bench 之后,用真实世界代码仓库+可执行测试评测大模型软件工程能力,几乎已成为学术界与工业界的共识。围绕 SWE issue 的评测范式迅速发展,也催生了一系列 SWE 系列 benchmark,在刻画模型 bug 修复能力方面发挥了重要作用。