5万条网页众源轨迹,真能把机器人模型练强吗?AXIS基准给出答案 (opens in a new tab)
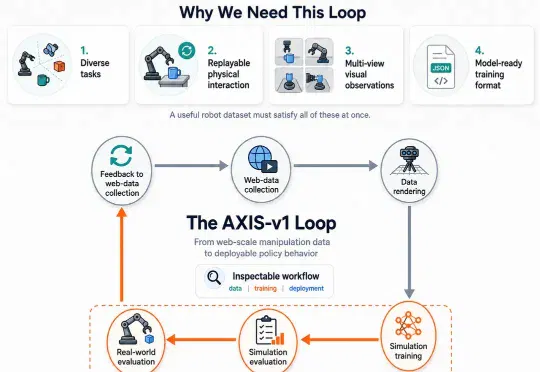
Axis Robotics 与佐治亚理工、加州大学伯克利分校、南洋理工等高校团队通过超过 5 万条人类演示和一组规模实验,给出了一个肯定但更复杂的答案:众源仿真数据可以有效,但模型能否从数据规模中持续获益,取决于任务覆盖、行为多样性、质量控制和数据增强,而不只是轨迹数量。
Total 2 articles
Axis Robotics 与佐治亚理工、加州大学伯克利分校、南洋理工等高校团队通过超过 5 万条人类演示和一组规模实验,给出了一个肯定但更复杂的答案:众源仿真数据可以有效,但模型能否从数据规模中持续获益,取决于任务覆盖、行为多样性、质量控制和数据增强,而不只是轨迹数量。
今天凌晨,喜欢闷声做大事的 DeepSeek 再次发布重大技术成果,在其 GitHub 官方仓库开源了新论文与模块 Engram,论文题为 “Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models”, 梁文锋再次出现在合著者名单中。