突发!腾讯AI Lab撤销,部分人员并入混元 (opens in a new tab)
今天,机器之心获悉,腾讯 TEG 技术工程事业群组织架构发生了部分调整,AI Lab 被撤销,蒋杰不再担任 AI Lab 主任,但其他管理职责不变。此次调整过后,原 AI Lab 部分人员调整至混元团队向姚顺雨汇报。产学研合作中心保留。多模态部负责人向 TEG 总裁卢山汇报。
Total 56 articles
今天,机器之心获悉,腾讯 TEG 技术工程事业群组织架构发生了部分调整,AI Lab 被撤销,蒋杰不再担任 AI Lab 主任,但其他管理职责不变。此次调整过后,原 AI Lab 部分人员调整至混元团队向姚顺雨汇报。产学研合作中心保留。多模态部负责人向 TEG 总裁卢山汇报。
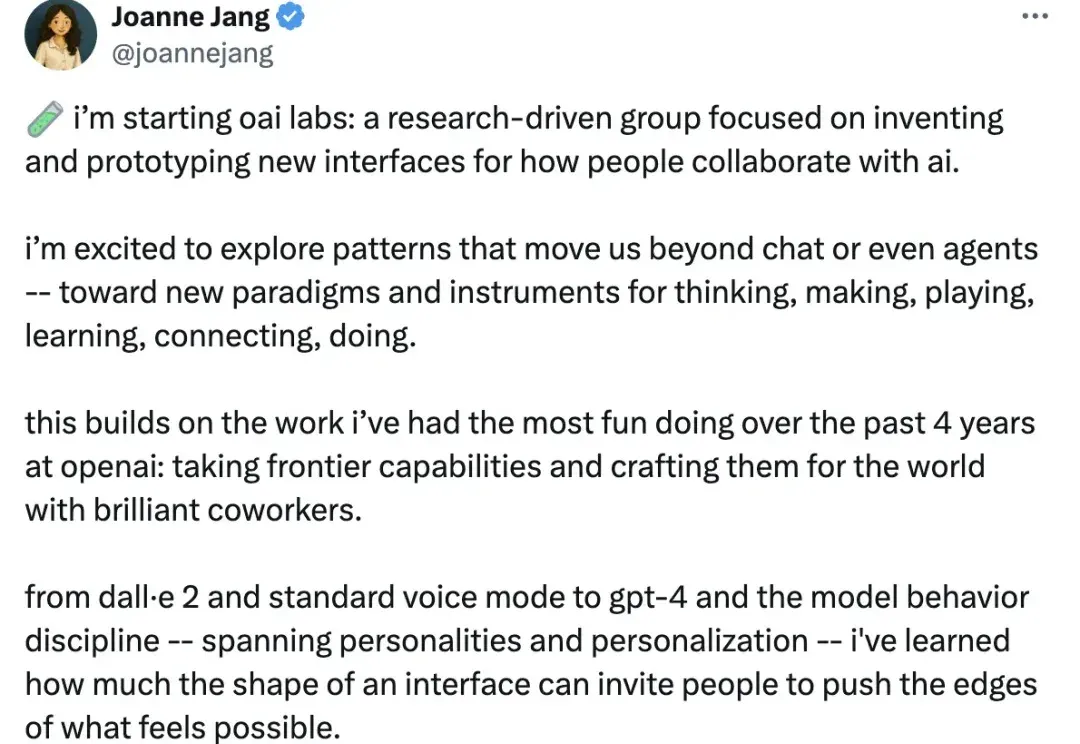
OpenAI又要成立新团队了! TechCrunch消息,OpenAI正在对其模型行为(Model behavior)团队进行重组。 模型行为团队,就是OpenAI内部专门塑造模型“个性”的核心研究小组。迄今已参与GPT-4、GPT-4o、GPT-4.5与GPT-5等版本的后训练工作。 随着重组的进行,其创始负责人Joanne Jang,也正在组建一个名为OAI Labs的新研究团队。 Joanne介绍,OAI Labs的职责是探索人与AI协作的新范式。 这是一个以研究为导向的团队,专注于发明和设计人们与人工智能协作的新接口。 OpenAI成立OAI Labs 作为模型行为团队改组行动的一部分
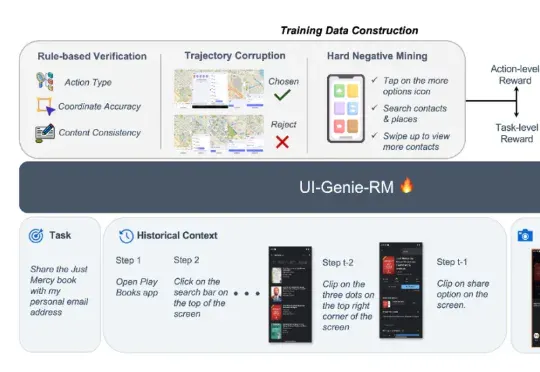
本文来自于香港中文大学 MMLab 和 vivo AI Lab,其中论文第一作者肖涵,主要研究方向为多模态大模型和智能体学习,合作作者王国志,研究方向为多模态大模型和 Agent 强化学习。项目 le
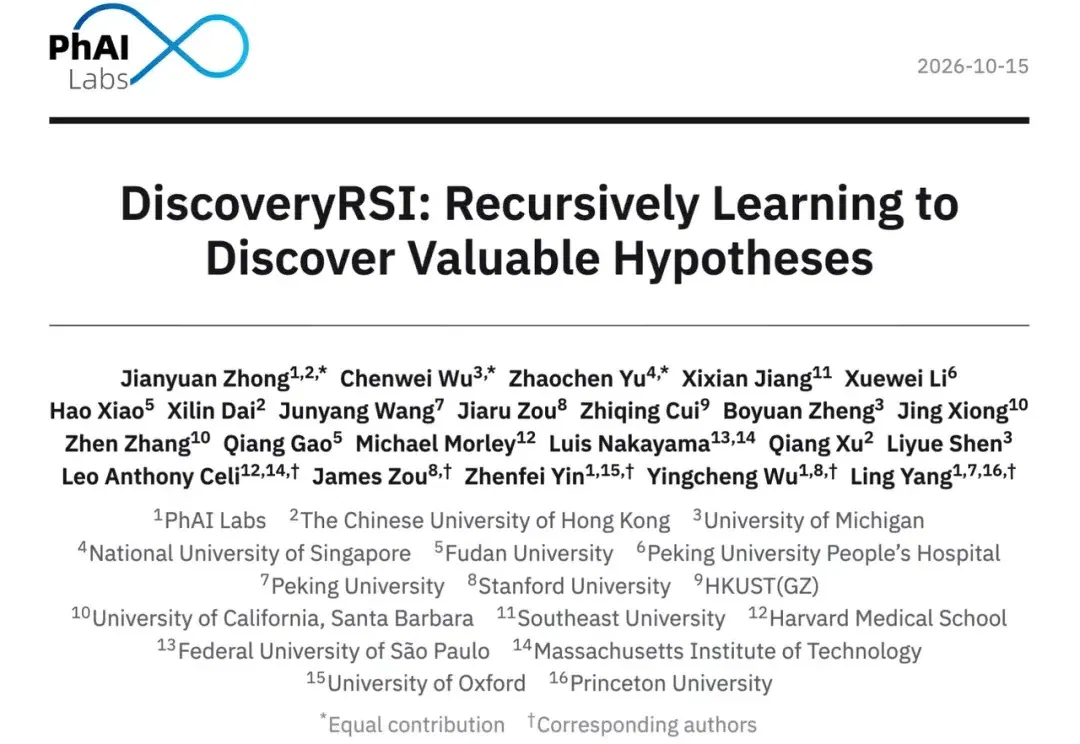
Claude,竟然排在最后? PhAI Labs 最新公布了一项 AI 研究能力对照,结合后续发表的科学文献,考察不同模型提出的研究假设能否为未来的研究思路与探索方向提供启发。报告所列的 Claude Opus 5 组对应比例为 2.3%,排在图中五个模型组的末位。GPT 组为 2.5%,GLM 为 2.8%,DeepSeek 为 5.4%。 排在最前面的,是 DiscoveryRSI:6.3%,约为 GPT 组的 2.5 倍、Claude 组的 2.7 倍。 图 1|五个模型组对未来研究的启发:DiscoveryRSI 总体比例为 6.3%。 这项比较观察的是:AI 提出的研究假设,能否在后
所见即所学。 近日,谷歌在 AI Lab 中发布了一项名为 Little Language Lessons 的实验项目。 与 Duolingo 编写好系统性课程供用户学习的思路不同,Google 的这项实验旨在从真实生活场景、甚至是眼前的事物出发,来学习语言。 AI 可以根据具体场景、甚至是一张照片,快速生成一节短课程,内容上不会长篇大论,只会给出最关键的内容与表达。目前,该项目仍在测试当中,解锁的功能也相对较少,但是根据笔者的测试,课程内容基本由用户主导,需要用户先输入要求,AI 再生成课程,生成课程需要的时间仅有 10 秒左右。 目前,在 Google AI Labs 上,已经上线了三个功
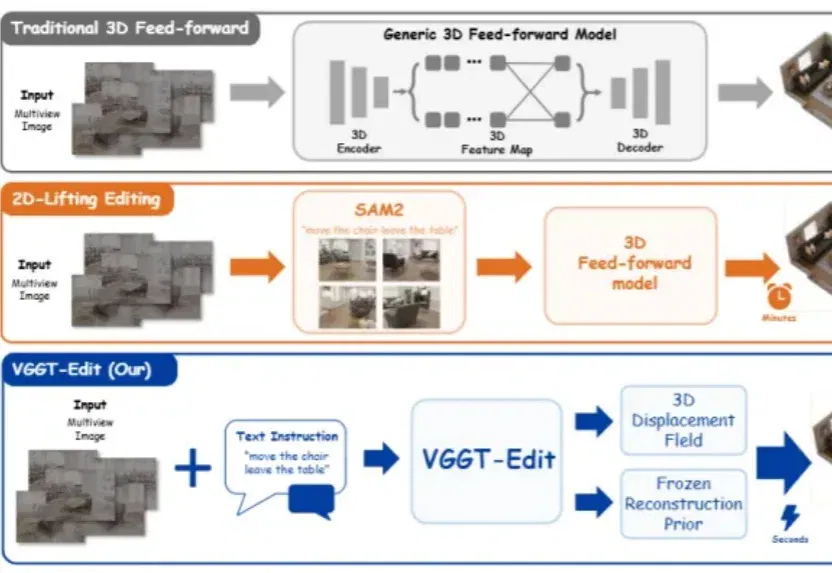
3D世界“会看”了,但还不会“改”。 从NeRF到83D Gaussian Splatting,再到VGGT、π³这类前馈式3D重建模型,整个行业的进展速度明显加快——只需几张图片,就能在几秒内重建完整3D场景。 但问题也恰恰出在这里。这些模型虽然已经能理解三维世界,却还不会修改三维世界。你可以让它重建一个房间,却很难真正告诉它: 把椅子移到窗边,删除中间那张椅子,把灰色皮沙发改成白色长毛沙发。 更麻烦的是,一旦涉及复杂编辑,现有方法往往迌速崩採——某些角度里椅子消失了,换个视角椅子又重新出现;明明没改的背景,却跟着一起变形。 为应对这一挑战,来自北京大学、香港中文大学、上海AI Lab、NT
前腾讯AI Lab可信AI负责人吴秉哲的创业项目Knevo(思演智能助手)目前处于内测阶段,聚焦金融方向的AI决策,整合流式推理、工具调用、长期记忆与断线恢复等模块,并提出"千人千面+自净化"的Agent建设逻辑。
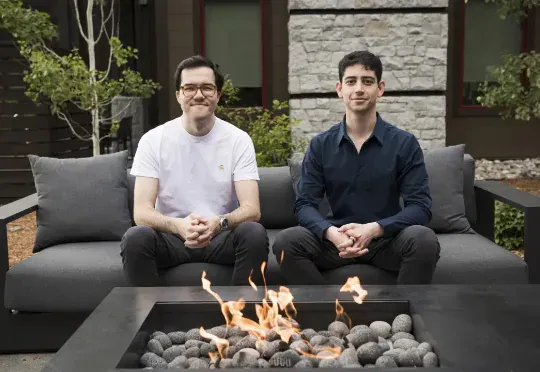
图片来源:David AI Labs David AI Labs 这家初创公司通过出售音频数据集来帮助训练人工智能模型,近期在新一轮融资中从投资者处筹集了 5000 万美元——这表明为 AI 开发提供
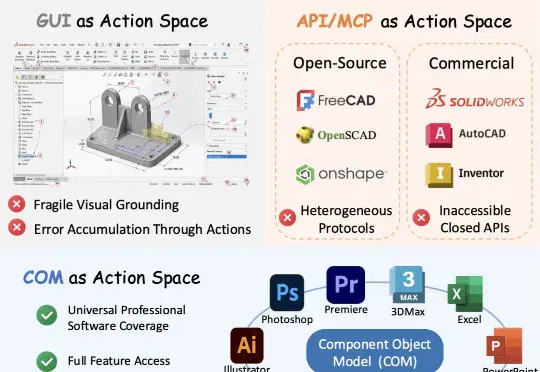
近日,上海AI Lab等团队提出了一种面向专业软件智能体的新范式——ComAct(COM-as-Action)。它的核心思想在于:不再把鼠标点击和键盘输入作为Agent的action,而是让Agent直接生成COM代码,通过软件底层对象模型操纵真实专业软件。
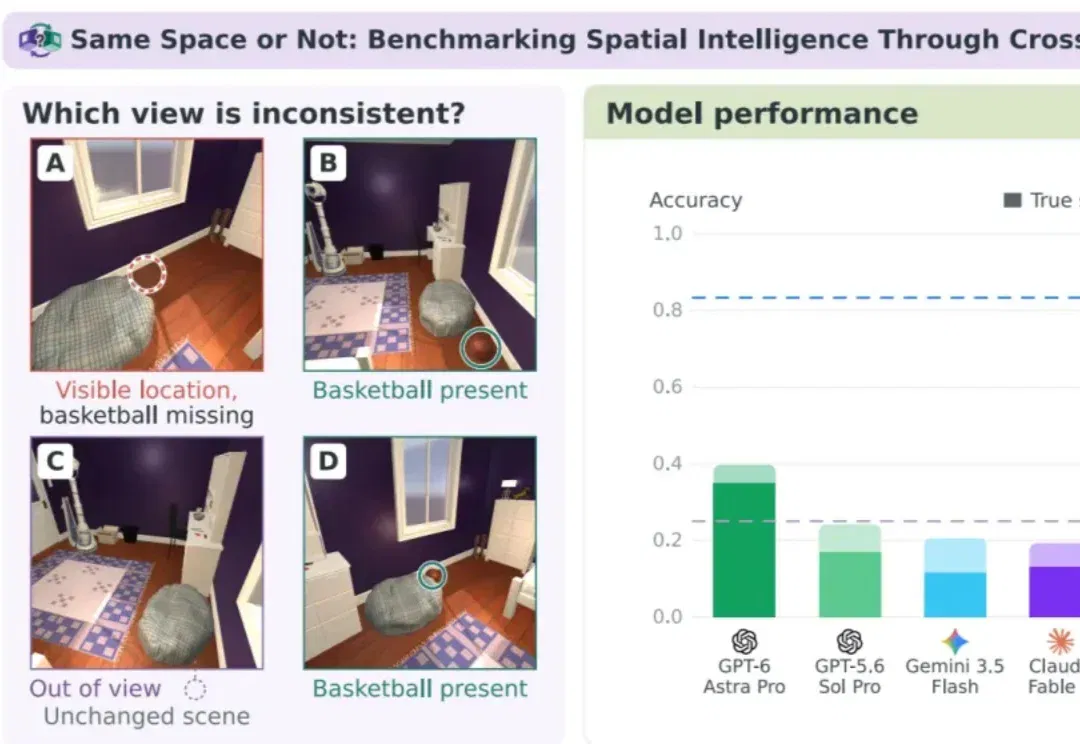
普林斯顿AI Lab等团队提出SSoN:用四张室内图像判断哪张违反同一场景的空间一致性。1000题上,人类准确率83.3%,六个受测VLM最高39.7%;解释核验、相机信息干预和定向微调进一步揭示跨视角推理的短板。