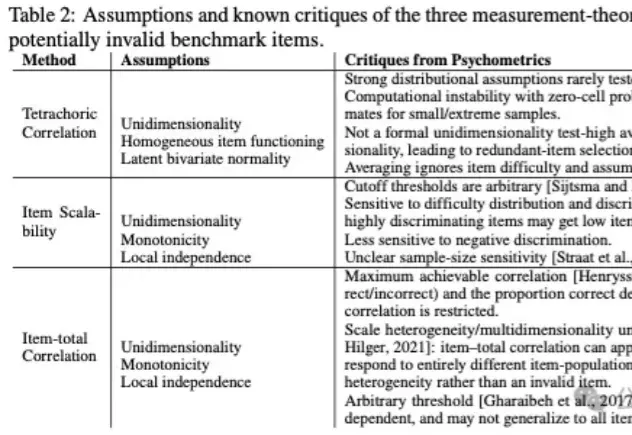
AI基准测试集体塌房,最高84%都是坏题 |斯坦福最新研究 (opens in a new tab)
基准测试(Benchmarks)在人工智能的发展进程中扮演着至关重要的角色,构成了评价生成式模型(Generative Models)性能的事实标准。对于从事模型训练与评估的AI研究者而言,GSM8K、MMLU等数据集的数据质量直接决定了评估结论的可靠性。
Total 7 articles
基准测试(Benchmarks)在人工智能的发展进程中扮演着至关重要的角色,构成了评价生成式模型(Generative Models)性能的事实标准。对于从事模型训练与评估的AI研究者而言,GSM8K、MMLU等数据集的数据质量直接决定了评估结论的可靠性。
「金山银山前路有」 「同志们朋友们,版本回调了! 搞AI应用的家人们没活了。胜利女神的天平又一次倾向了大模型公司一边。有鉴于此,我们将复刻致敬葬AI一年前的系列——把模型公司挨个写一遍。 之前已经写过了Kimi、智谱和豆包,其他模型公司敬请期待😘」 阿里巴巴是一家很神奇的公司。 现在AI火成这个样子。GLM 5.2达到Opus 4.8水平,智谱彻底摆脱2G公司老教授组团爆金币的刻板印象,市值突破万亿港元,约等于1/2阿里。 我在做完第一期葬AI基准测试后,立即发现了GLM 5.2牛逼,同时发现的还有Qwen 3.7 Max也很牛逼,只比GLM差一点点,达到了Opus 4.7水平。 阿里的牛逼
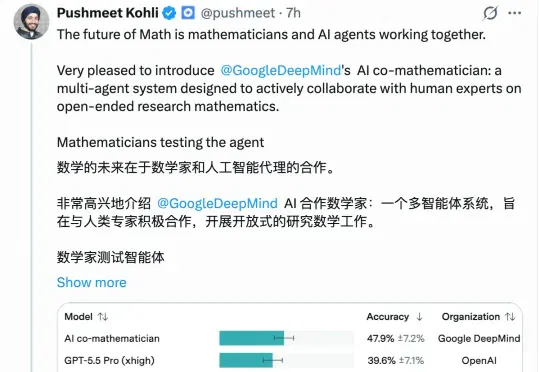
群论领域几十年无解的第21.10号问题,被牛津数学家Marc Lackenby用谷歌一个新系统破解了。过程也很有意思:AI第一次给出的证明是错的,被系统里的审查Agent揪出了漏洞。
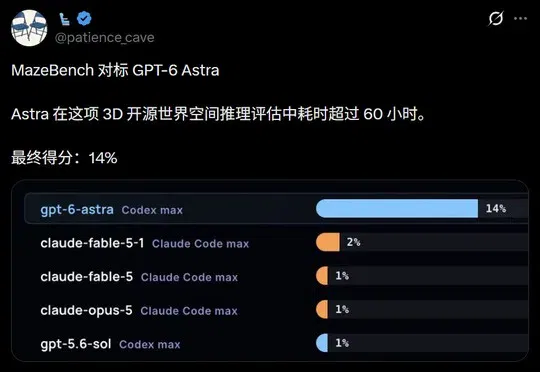
OpenAI的GPT-6 Astra登顶MazeBench等多项AI基准测试,以14%的成绩拿下3D空间推理第一,并在视频设计零件、3D分子交互模拟、频谱图识别声音等实际任务中展现出逼近AGI的全面能力,获得英伟达CEO黄仁勋认证为全球首个拿下AGI的团队。
这是葬AI起号以来工作量最大的一篇文章。为了严肃评测国产模型的能力,我自研了一个Benchmark,完整测试了智谱、Qwen、Kimi、Minimax、Deepseek这些最新国产模型,还引入了境外势力Claude作对照组。
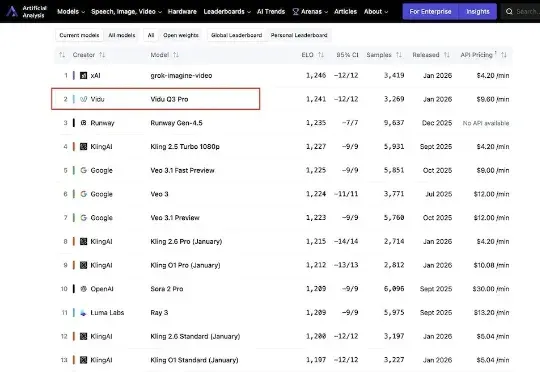
今日,来自生数科技的AI视频模型Vidu Q3 Pro登上国际权威AI基准平台Artificial Analysis榜单,位列中国第一,全球第二。这是最新榜单内,首个打入国际第一梯队的国产视频生成模型。
豆包产品无敌,但Seed模型一直不温不火,大伙对它的印象就两个: 工资高,隔三差五就有千万年包上亿年包新闻,也不知道真假;多模态,但编程能力不太行。