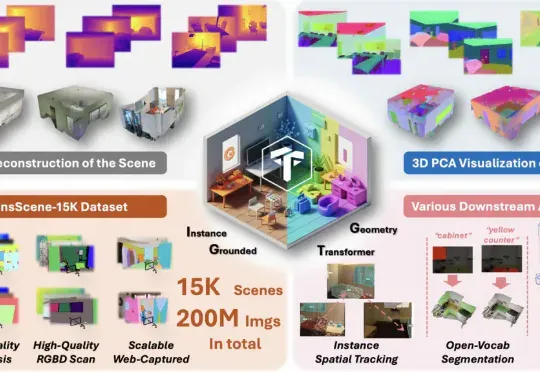
首个实例理解3D重建模型!NTU&阶越提出基于实例解耦的3D重建模型,助理场景理解 (opens in a new tab)
现在,NTU联合StepFun提出了IGGT (Instance-Grounded Geometry Transformer) ,一个创新的端到端大型统一Transformer,首次将空间重建与实例级上下文理解融为一体。
Total 3 articles
现在,NTU联合StepFun提出了IGGT (Instance-Grounded Geometry Transformer) ,一个创新的端到端大型统一Transformer,首次将空间重建与实例级上下文理解融为一体。
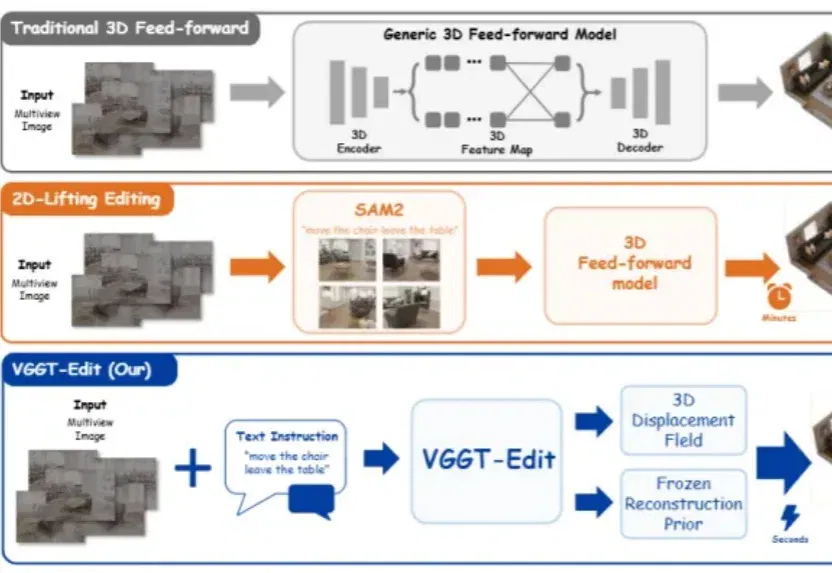
3D世界“会看”了,但还不会“改”。 从NeRF到83D Gaussian Splatting,再到VGGT、π³这类前馈式3D重建模型,整个行业的进展速度明显加快——只需几张图片,就能在几秒内重建完整3D场景。 但问题也恰恰出在这里。这些模型虽然已经能理解三维世界,却还不会修改三维世界。你可以让它重建一个房间,却很难真正告诉它: 把椅子移到窗边,删除中间那张椅子,把灰色皮沙发改成白色长毛沙发。 更麻烦的是,一旦涉及复杂编辑,现有方法往往迌速崩採——某些角度里椅子消失了,换个视角椅子又重新出现;明明没改的背景,却跟着一起变形。 为应对这一挑战,来自北京大学、香港中文大学、上海AI Lab、NT
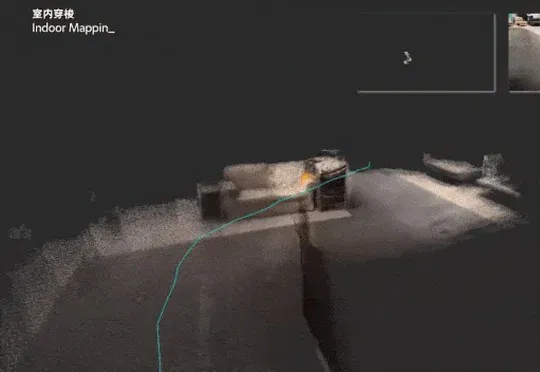
蚂蚁灵波开源的流式3D重建模型LingBot-Map凭借几何上下文注意力机制在GitHub获16.9K Stars后,其论文入选ECCV 2026 Oral,全球开发者围绕该项目完成Apple Silicon桌面前端、RTX 4060低显存适配及Ray-Ban Meta智能眼镜采集等多种二次开发。