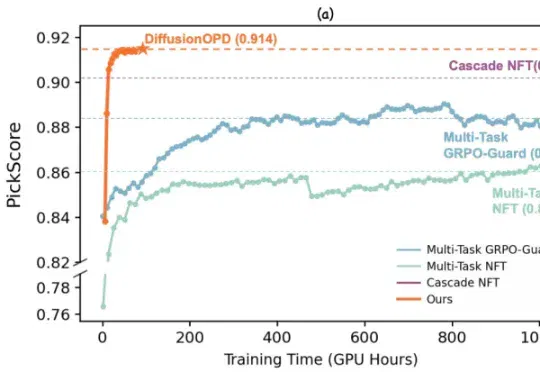
DiffusionOPD:复旦联合通义万相提出扩散模型「在线策略蒸馏」新范式,让学⽣模型同时学会构图、⽂字与美学 (opens in a new tab)
近期,来自复旦大学与阿里巴巴通义万相的研究团队对此提出了新的思考。他们认为,多任务强化学习不应被视为一个统一优化问题,而应该解耦为两个彼此独立的过程:单任务的在线策略探索 & 多任务能力整合。
Total 6 articles
近期,来自复旦大学与阿里巴巴通义万相的研究团队对此提出了新的思考。他们认为,多任务强化学习不应被视为一个统一优化问题,而应该解耦为两个彼此独立的过程:单任务的在线策略探索 & 多任务能力整合。
Veo 3真正对手,竟不是Sora 2!通义万相2.5全网首发,直接甩出王炸:一句话,直出10秒1080P电影级视频,首次实现音画精准同步。一键生成BGM、人声,全网实测玩疯。
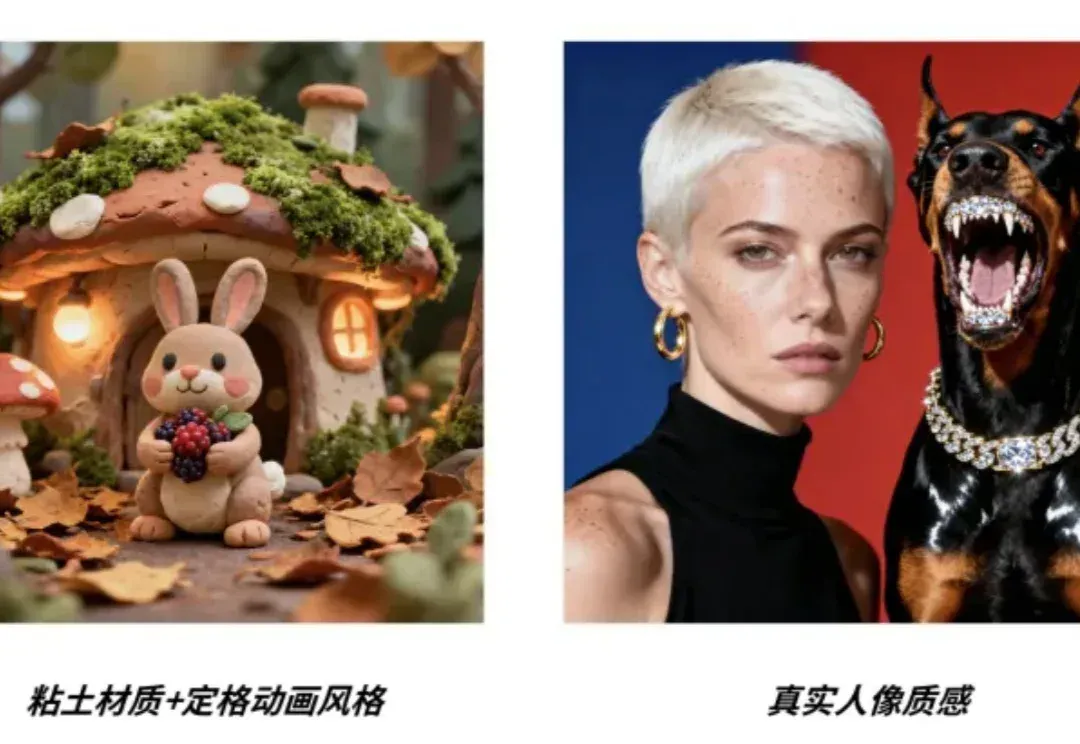
坏了,阿里这波是冲着Sora 2去的! 刚刚,阿里发布了新一代通义万相2.6系列模型,一次性覆盖文生视频、图生视频、参考生视频,以及图像生成和文生图,是目前全球功能最全的视频生成模型。 在视频创作上,万相2.6不仅推出了Sora2目前还没有的多音频驱动生视频能力,还同步引入了音画同步、多镜头叙事等能力。 像下面这个超火的一刀切ASMR,就是通过文本+音频直接驱动出来的: 再看这个由文本+图像+音频驱动的小猫沉浸式吃播,咀嚼声和嘴部动作基本能卡在点上,吃得那叫一个香: 文生图这条线也同步补强了,万相2.6在艺术风格控制、真实感人像、中英文长文本生图以及历史文化IP语义理解等方面的创作能力也都有明
这年头出门逛展,中国厂商真的是把排面拉爆了。比如火热进行中的东京电玩展(TGS),现场是这样的:一眼AI含量爆棚的,当属阿里展台——通义千问和通义万相两个开源界当红炸子鸡,妥妥C位出展。
人人都能创作视频的时代来了。 当新技术遇上老难题 如果给2025年下半年的AI行业选一个受关注的方向,视频生成几乎是绕不开的答案。在OpenAI发布Sora 2并上线App版本后,AI视频的热度几乎以“病毒式”的速率在全球范围内迅速扩散开来。 但梳理产业发展的脉络,才会发现,这并非是偶然的产品爆红。背后,是过去两年里视频生成技术在画面质量、时序建模与可用性上的持续进步。Sora、Veo、通义万相,无论是大公司还是创业公司,不断累加的技术贡献,让全球AI视频相关能力的迭代节奏显著加快。 更深层的影响,正在产业内部逐步显现。 当模型的进步不再局限于画面质量本身,而是逐步覆盖叙事能力、人物与风格一致
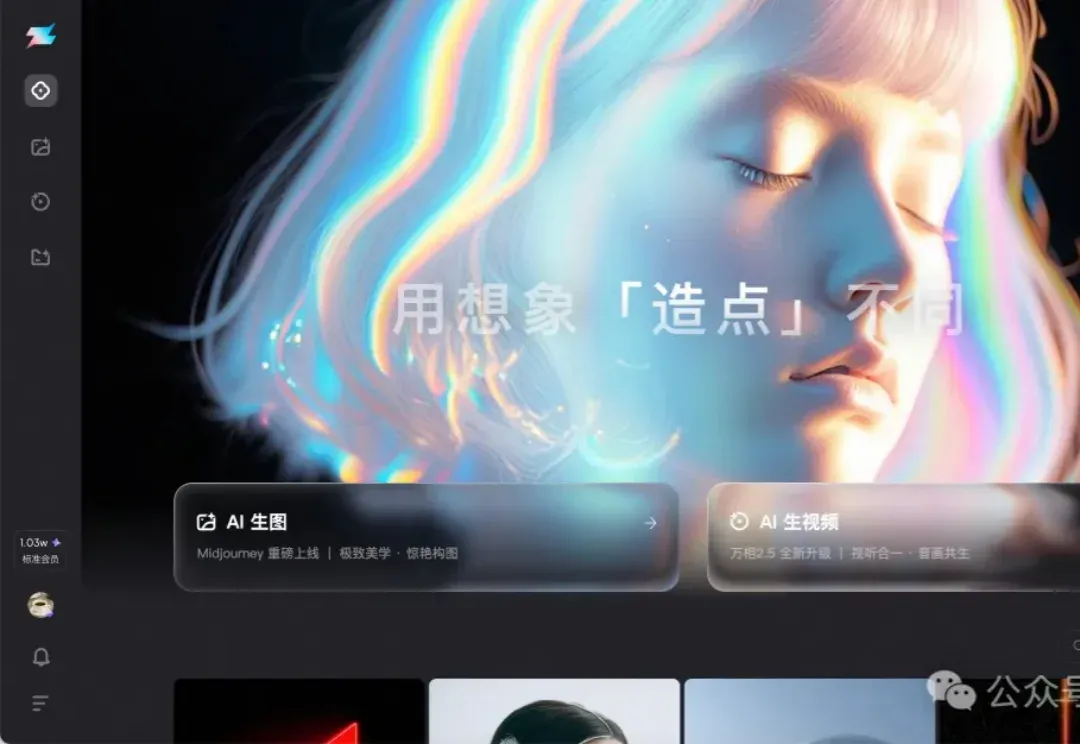
夸克“造点”AI发布了!直接上大招,Wan2.5+Midjourney V7双强模型联合!夸克“造点”还在今天第一时间,率先接入了阿里自家刚刚发布的视频生成模型通义万相Wan2.5,甚至直接开放了7天免费体验。