MIT团队推出递归语言模型!不改架构、不扩窗口,上下文处理能力扩展百倍 (opens in a new tab)
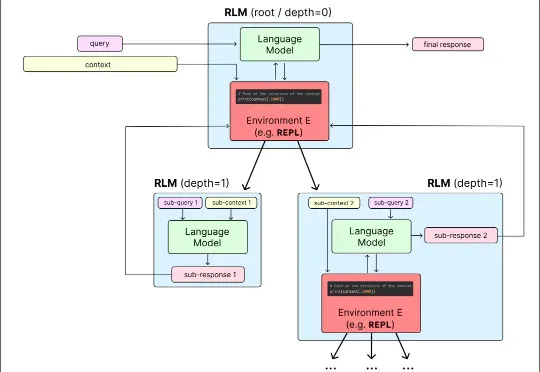
新年伊始,MIT CSAIL 的一纸论文在学术圈引发了不小的讨论。Alex L. Zhang 、 Tim Kraska 与 Omar Khattab 三位研究者在 arXiv 上发布了一篇题为《Recursive Language Models》的论文,提出了所谓“递归语言模型”(Recursive Language Models,简称 RLM)的推理策略。
Total 3 articles
新年伊始,MIT CSAIL 的一纸论文在学术圈引发了不小的讨论。Alex L. Zhang 、 Tim Kraska 与 Omar Khattab 三位研究者在 arXiv 上发布了一篇题为《Recursive Language Models》的论文,提出了所谓“递归语言模型”(Recursive Language Models,简称 RLM)的推理策略。
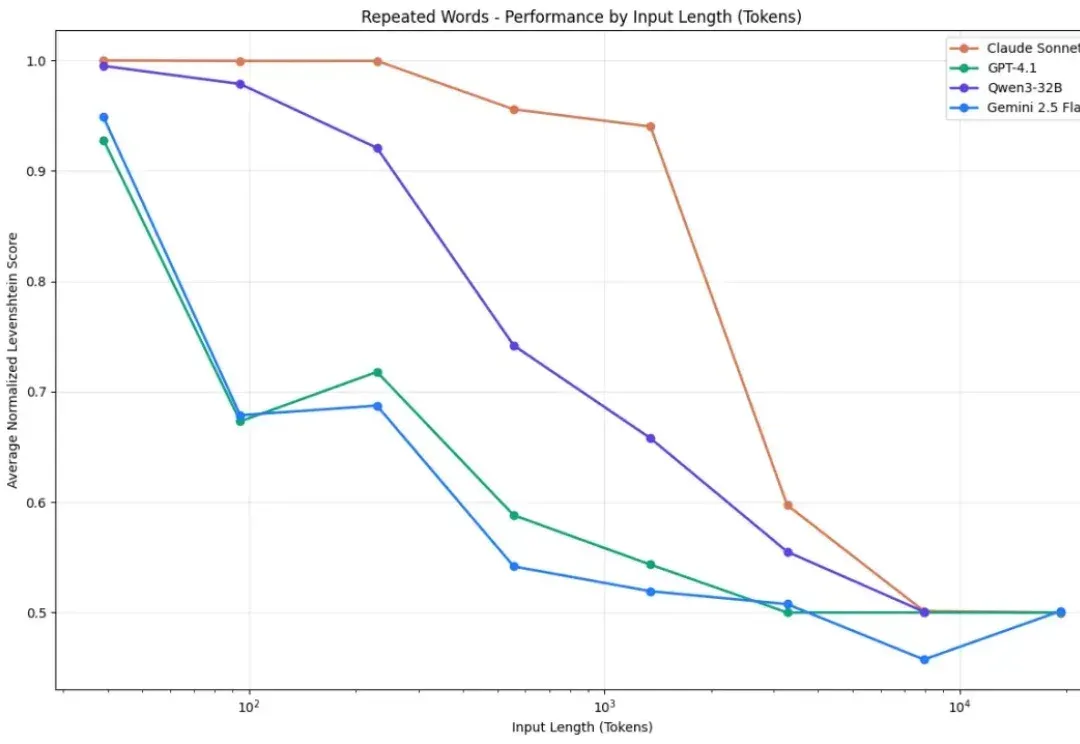
目前,所有主流 LLM 都有一个固定的上下文窗口(如 200k, 1M tokens)。一旦输入超过这个限制,模型就无法处理。 即使在窗口内,当上下文变得非常长时,模型的性能也会急剧下降,这种现象被称为「上下文腐烂」(Context Rot):模型会「忘记」开头的信息,或者整体推理能力下降。
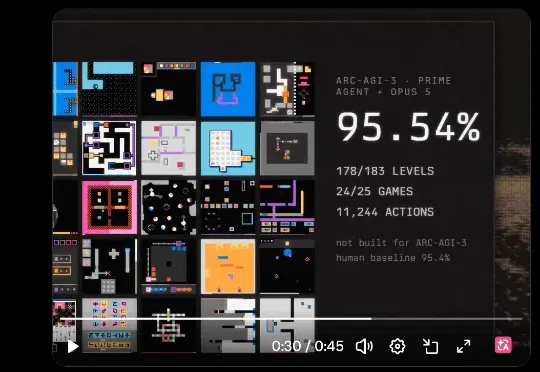
这个框架名叫 Prime Agent,由 Prime Intellect 发布。官方对它的定义是:一个面向编程、研究和长时间自主任务的「自我改进 RLM harness」。RLM 是 MIT 博士生 Alex Zhang 等人去年 10 月发布的一项工作(参见《递归语言模型登场!MIT华人新作爆火,扩展模型上下文便宜又简单》)