Search

Results for “连续扩散语言模型”

Total 3 articles

何恺明首个语言模型:105M参数,不走GPT自回归老路

何恺明首个语言模型:105M参数,不走GPT自回归老路 (opens in a new tab)

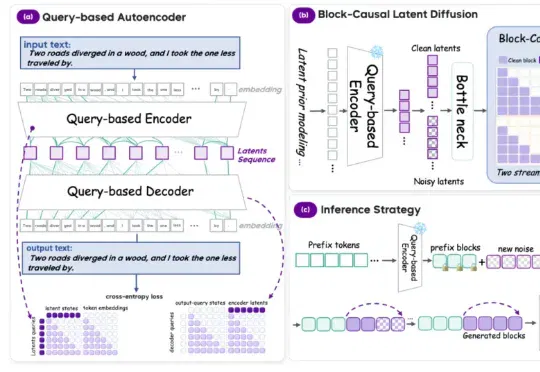
何恺明,也下场做语言模型了。 只不过,这次他带队做的不是大家熟悉的、像ChatGPT背后那套“预测下一个词元”(next token prediction)的自回归范式。 而是另一条过去几年在图像领域大火、如今正被越来越多人搬进文本生成的新路线:扩散语言模型(Diffusion Language Model,DLM)。 在最新的论文中,何恺明团队放出全新连续扩散语言模型:ELF:Embedded Language Flows。 与不少还停留在token层面做扩散的语言模型不同,ELF把整个生成过程都留在了连续的embedding空间里,直到最后一步,才重新离散化,将表示变回token。 靠着这
AI guides
0
继何恺明团队ELF后,南京大学基于昇腾算力同步提出连续扩散语言模型

继何恺明团队ELF后,南京大学基于昇腾算力同步提出连续扩散语言模型 (opens in a new tab)

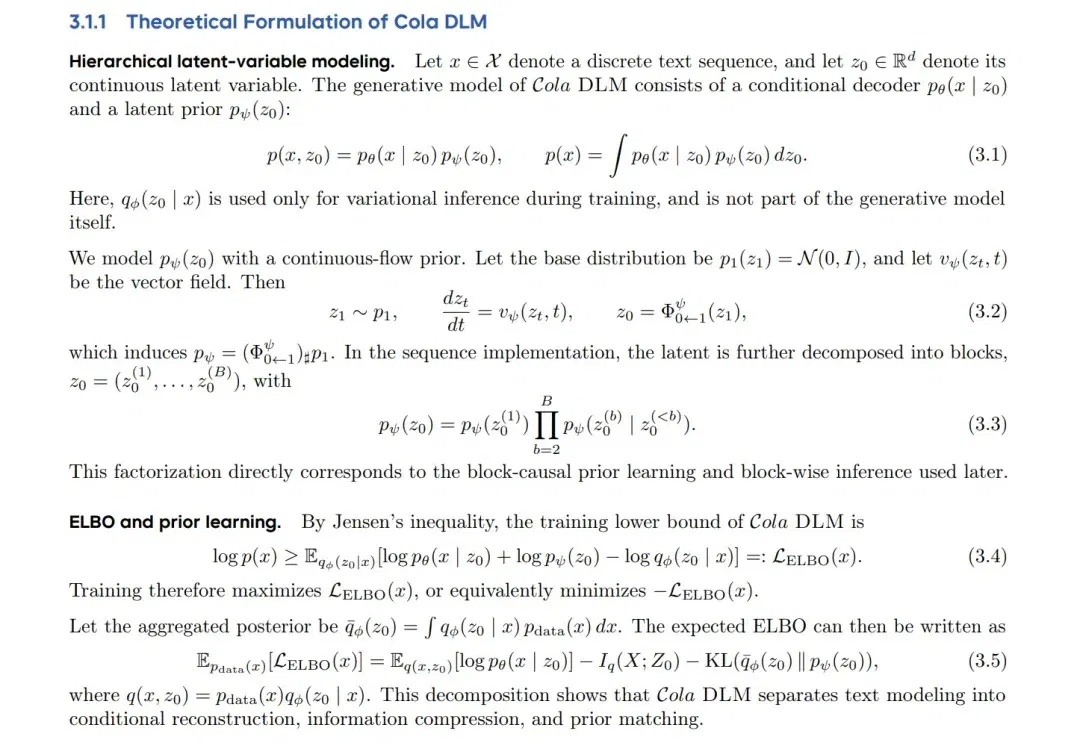
近日来自南京大学模式识别实验室(PRLab)的梁嘉骏、廖宇程,在司晨阳教授的指导下,联合新加坡南洋理工大学、英国帝国理工学院,提出连续扩散语言模型 AURORA-LM(Autoencoding Unified Representation for Continuous-Latent Diffusion Language Modeling),对连续空间下的语言建模作出了更多的思考和发现。

AI guides
0