达摩院发布世界模型评测基准,自家模型一个都没上榜...... (opens in a new tab)
达摩院联合高校推出WorldOlympiad评测基准,跳出传统视频“唯画质”的评价逻辑,以物理真实性、三维几何一致性、长时序交互保真度三大维度,搭配游戏、机器人、通用实景三大场景,打造一套全方位的视频世界模型评测体系。
Total 25 articles
达摩院联合高校推出WorldOlympiad评测基准,跳出传统视频“唯画质”的评价逻辑,以物理真实性、三维几何一致性、长时序交互保真度三大维度,搭配游戏、机器人、通用实景三大场景,打造一套全方位的视频世界模型评测体系。
编程智能体时代,顶流Cursor举旗发布新的评测基准——CursorBench,专门评价Cursor中不同模型谁更“智能体”(即高效执行复杂任务)。关于咋评的这个问题,Cursor还专门撰写了一篇博客。
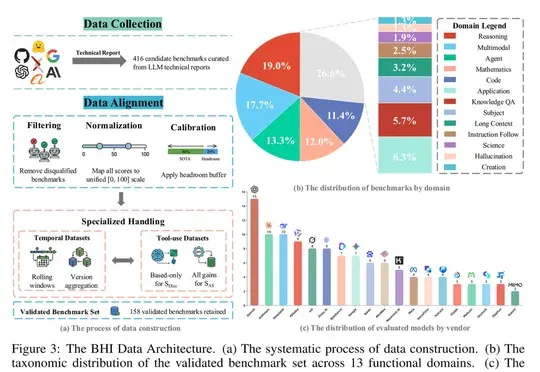
阿里数据团队提出基准健康指数 BHI,从模型区分度、剩余挑战空间和能力加权采用情况评估 158 个基准,并用留一基准法与扰动实验检查稳定性。它能辅助筛选与复核评测,但不同技术报告的测试条件仍有差异,短期趋势也不能准确预言某套题何时失效。
港科大团队提出音频生成统一模型AudioX,只需一个模型,就能从文本、视频、图像等任意模态生成高质量音效和音乐,在多项基准上超越专家模型。团队同时开源了700万样本的细粒度标注数据集IF-caps与可控T2A评测基准T2A-bench,并在该基准上大幅领先现有方法。论文已被ICLR 2026接收。
来自哈佛大学、MIT、IBM、波士顿大学、谷歌、JHU、CMU 和 Kempner Institute 的研究者提出了一个新的诊断性基准:MemoBench。这是首个面向动态环境的「消失-重现」世界建模评测基准,并已被计算机视觉顶会 ECCV 2026 接收。其一作 Haoyu Chen 为哈佛大学计算科学与工程专业一年级硕士生,师从哈佛大学计算机科学助理教授 Yilun Du。
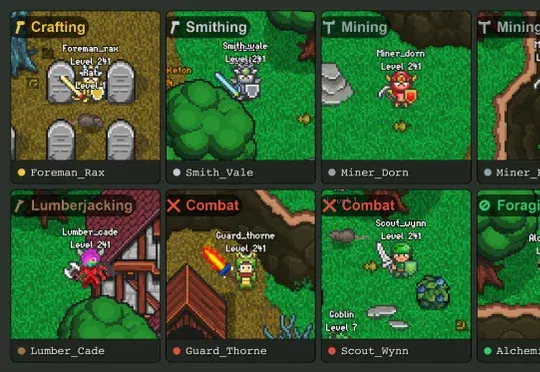
OpenAgents、哥伦比亚大学等研究者构建多智能体协作评测基准AgentWorld,评测显示主任务最高完整成功率为Gemini 3 Flash的52.0%,并提出CCE指标分析协作贡献。
近日,腾讯混元官方账号(@TencentHunyuan)在 X 上发布了一项新研究:ExplorationBench,一个专门衡量 AI 系统如何「探索」的评测基准;随后,腾讯 AI 官方账号(@TencentAI_News)也发文进行了专题推介。
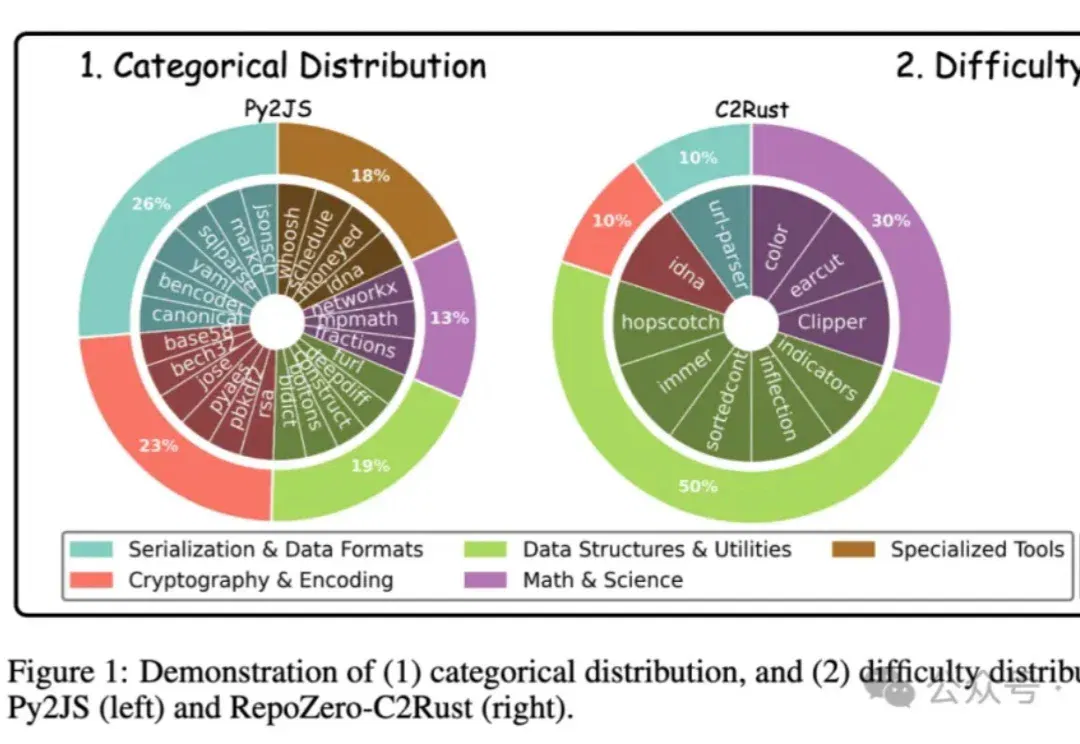
投稿来自北京大学与百度联合团队,他们提出了首个面向“从零生成完整代码仓库”的评测基准 RepoZero,通过跨语言复现任务与自验证框架 ACE,推动代码补全更近一步迈向自动化软件工程。
美团LongCat团队发布了当前高度贴近真实生活场景、面向复杂问题的大模型智能体评测基准——VitaBench(Versatile Interactive Tasks Benchmark)。VitaBench以外卖点餐、餐厅就餐、旅游出行三大高频生活场景为典型载体,构建了一个包含66个工具的交互式评测环境,并设计了跨场景综合任务。
中国电信研究院与MemTensor等机构提出首个面向智能体记忆系统的操作级幻觉评测基准HaluMem,已被EMNLP 2026主会接收,该基准分别对记忆提取、更新和问答三个环节进行检查,并对Mem0、MemOS等六套系统实测,发现高召回率可能伴随虚假信息写入、低更新幻觉率背后存在大量遗漏、上游记忆问题最终会影响回答等核心现象。