业界首个视觉世界模型综述:迈向更高智能的视觉范式 (opens in a new tab)
为了理清视觉与世界模型之间的深层联系,并为该领域的未来研究提供一张清晰的脉络图,北京交通大学靳潇杰、魏云超、赵耀等学者联合新加坡国立大学、腾讯、字节等国内外研究机构知名学者,发布了首篇视觉世界模型长篇综述:From Seeing to Knowing the World: A Survey of Vision World Models。
Total 3 articles
为了理清视觉与世界模型之间的深层联系,并为该领域的未来研究提供一张清晰的脉络图,北京交通大学靳潇杰、魏云超、赵耀等学者联合新加坡国立大学、腾讯、字节等国内外研究机构知名学者,发布了首篇视觉世界模型长篇综述:From Seeing to Knowing the World: A Survey of Vision World Models。
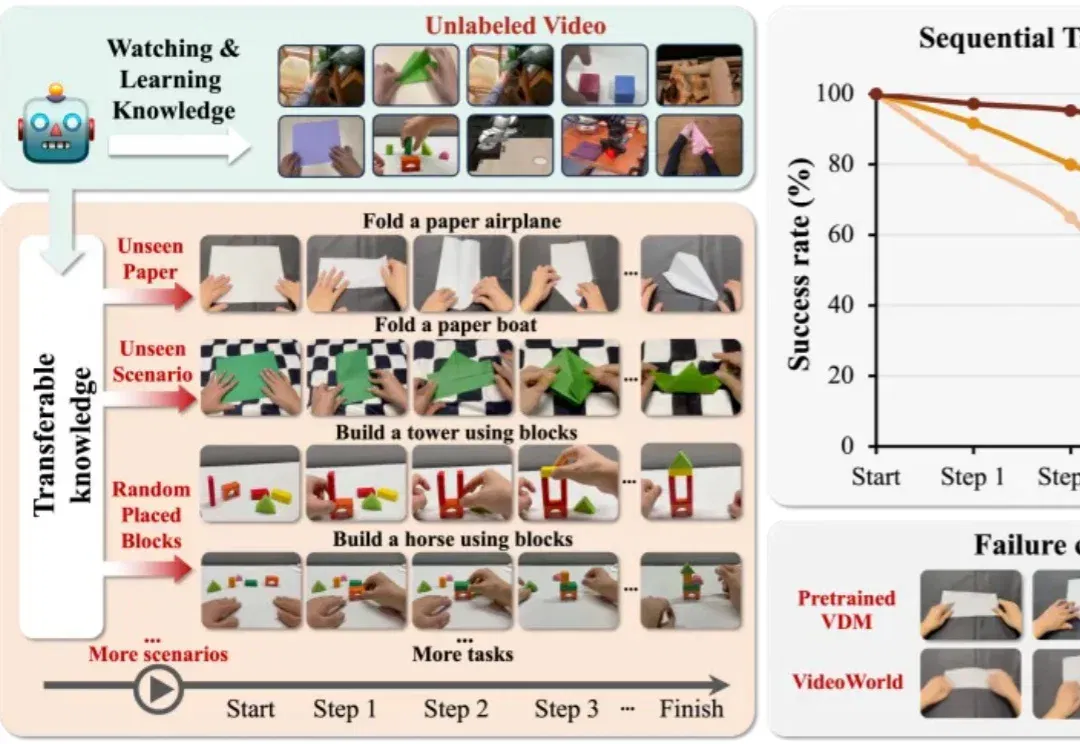
视觉世界模型 “VideoWorld 2” 由豆包大模型团队与北京交通大学联合提出。不同于 Sora 2 、Veo 3、Wan 2.2 等主流多模态模型,VideoWorld 系列工作在业界首次实现无需依赖语言模型,即可认知世界。
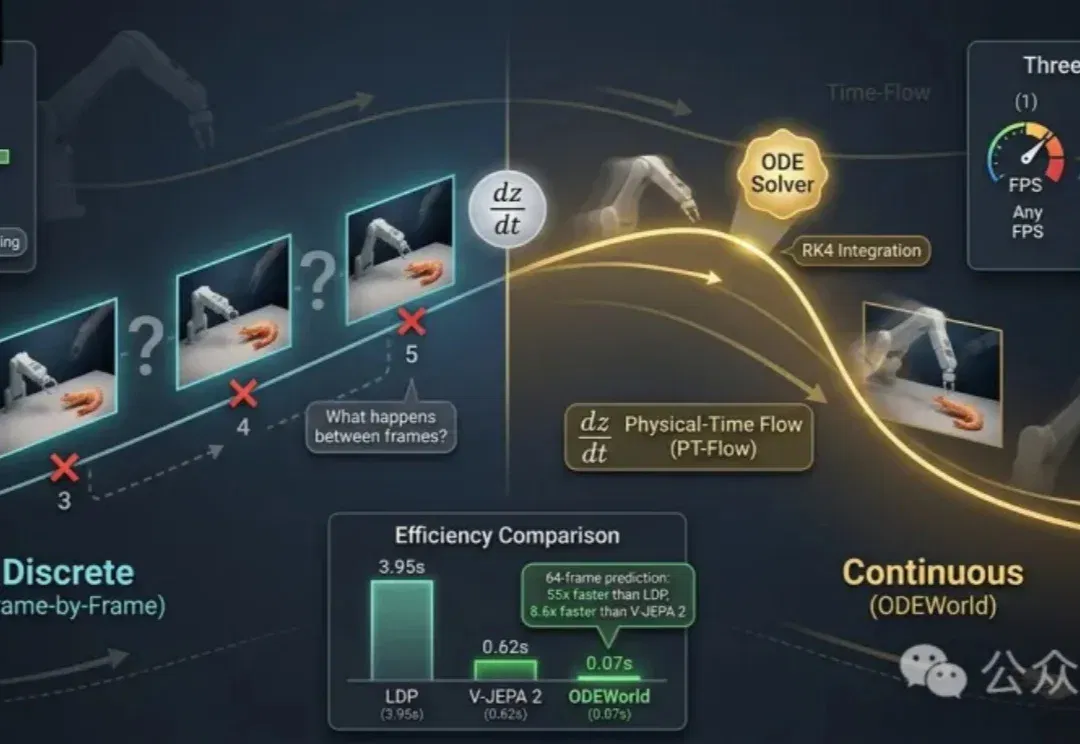
让机器人把一只虾夹起来,再放进锅里。 真正困难的,可能不是认出虾,也不是找到锅,而是把握夹爪闭合的那个瞬间:早一点,夹爪会落空;晚一点,虾可能已经被推走。夹住之后,机械臂还要连续调整力度、方向和速度。整个过程没有暂停键,也不会等摄像头拍完「下一帧」再继续。 但许多视觉世界模型认识时间的方式,恰恰来自这些被摄像头截取的画面。它们看到第1帧、第2帧、第3帧,并学习如何从一张图跳到下一张图。至于两帧之间发生了什么、换一种帧率后该如何预测,甚至某个关键瞬间缺失后如何还原,模型通常没有一条可以直接查询的连续轨迹。 问题也由此变得具体: 如果机器人对世界的理解只存在于一格格画面里,它要怎样抓住发生在两帧之