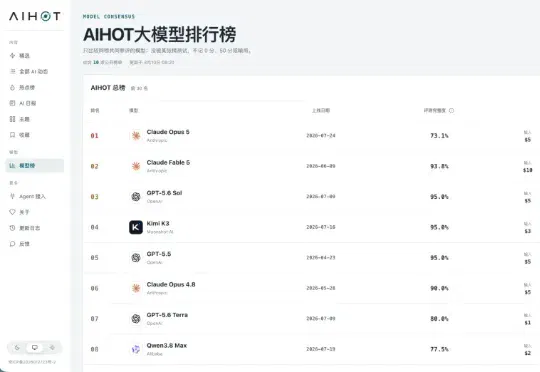
我花了54个小时,做了一个可能更公平的AI大模型排行榜。 (opens in a new tab)
希望能做一个各个模型评分排行的汇总,方便实时了解和对比各种模型的性能。这个是一个非常有趣、且对我自己非常刚需的需求。因为现在的模型评测排行榜、评测集等等,实在是太多太多了,人人其实都可以做一份自己的评测集,然后来跑一份模型排行榜,有的测的全一些,有的就是个垂直场景的特定任务,这个量级真的特别大。
Total 2 articles
希望能做一个各个模型评分排行的汇总,方便实时了解和对比各种模型的性能。这个是一个非常有趣、且对我自己非常刚需的需求。因为现在的模型评测排行榜、评测集等等,实在是太多太多了,人人其实都可以做一份自己的评测集,然后来跑一份模型排行榜,有的测的全一些,有的就是个垂直场景的特定任务,这个量级真的特别大。
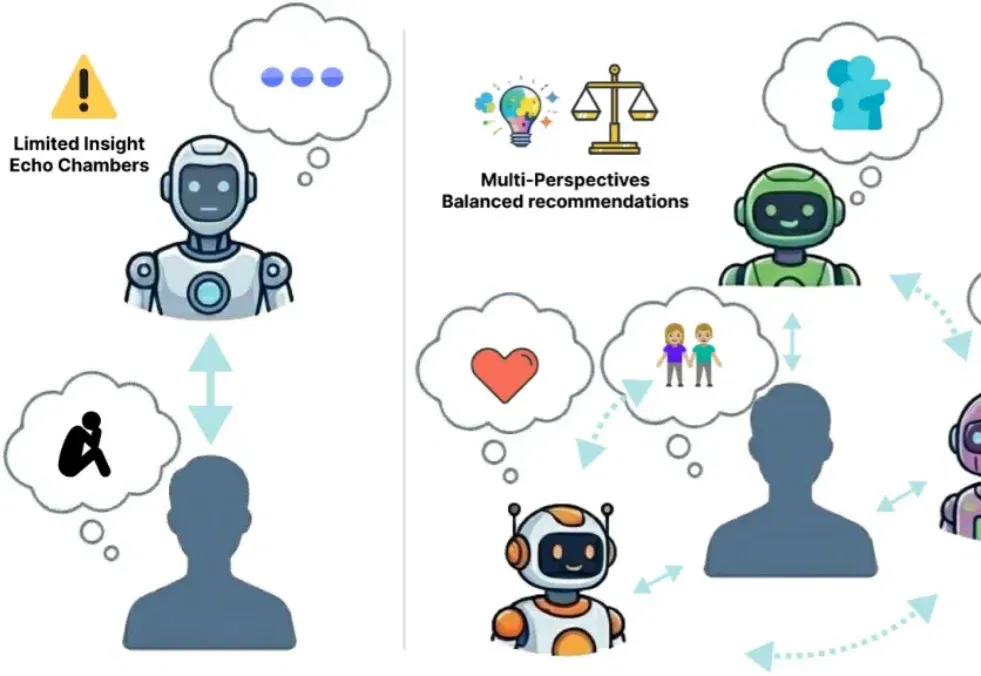
MASCOT 将多智能体群聊拆成角色行为对齐与主持人协调两个训练阶段,减少多个角色反复附和、缺少新贡献的问题。研究在情感支持与会议讨论数据上结合模型评分和人工盲评验证效果,现有证据主要来自英语和受控情境,长期互动仍待检验。