Search

Results for “模型对比”

Total 2 articles

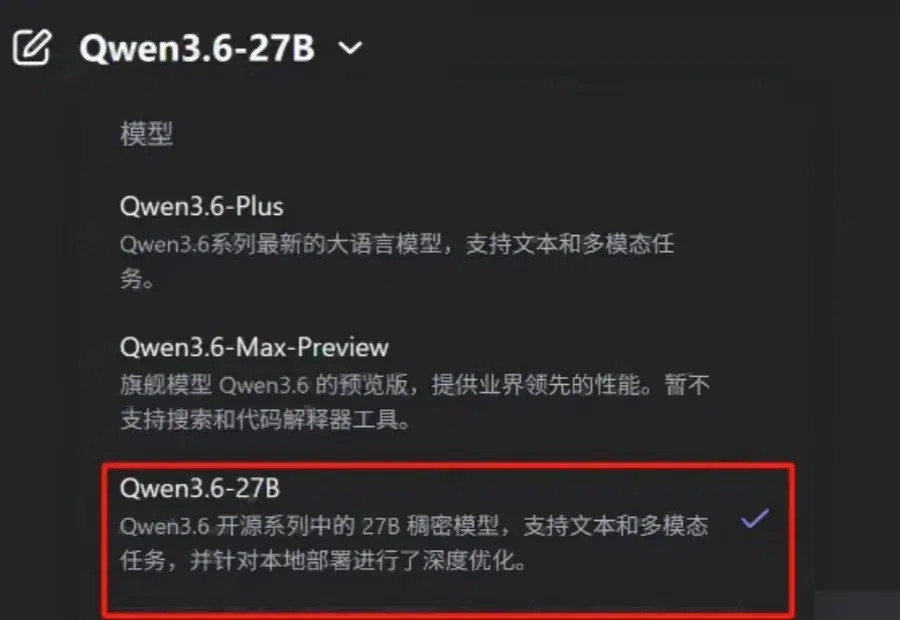
实测Qwen3.6-27B:4分钟做了个跑酷游戏,验证码识别正确率超90%

实测Qwen3.6-27B:4分钟做了个跑酷游戏,验证码识别正确率超90% (opens in a new tab)

Qwen3.6系列全员集结完毕。 智东西4月23日报道,昨晚,阿里通义千问团队宣布开源Qwen3.6-27B——一款270亿参数的稠密多模态模型,支持思考与非思考模式。 与阿里上一代开源模型Qwen3.5-397B-A17B相比,Qwen3.6-27B以1/15的参数规模,在SWE-bench Verified、SWE-bench Pro、Terminal-Bench 2.0以及 SkillsBench上实现了反超,其编程能力提升明显,同时还具备较强的文本和多模态推理能力。 与相似尺寸的Gemma 4-31B模型对比,Qwen3.6-27B在大部分维度上,展现出较大领先优势。 随着Qwen3.
AI reviews
0
都是你能部署的:Qwen3.6和Gemma4,谁更适合作为你的下一代本地MoE模型?

都是你能部署的:Qwen3.6和Gemma4,谁更适合作为你的下一代本地MoE模型? (opens in a new tab)

阿里前几天开源的Qwen3.6-35B-A3B,让这次讨论不再只是一次普通的新旧模型对比。它一边要面对谷歌Gemma4-26B-A4B的外部竞争,一边又必须回答一个更麻烦的问题:相较于 Qwen3.5-35B-A3B,它到底是升级,还是修补?更现实的是,很多人现在真正跑着的,其实是Qwen3.5-27B,那么这条新的35B-A3B路线,到底值不值得迁过去。

AI guides
0