DeepSeek、GPT-5都在尝试的快慢思考切换,有了更智能版本,还是多模态 (opens in a new tab)
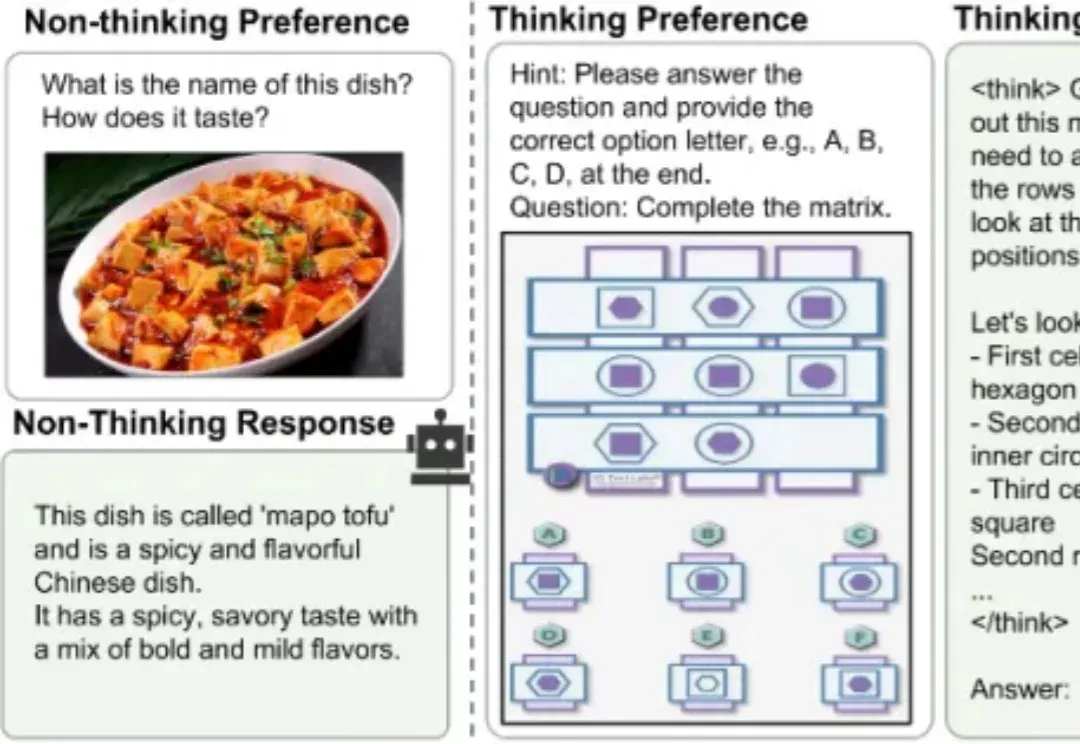
当前,业界顶尖的大模型正竞相挑战“过度思考”的难题,即无论问题简单与否,它们都采用 “always-on thinking” 的详细推理模式。无论是像 DeepSeek-V3.1 这种依赖混合推理架构提供需用户“手动”介入的快慢思考切换,还是如 GPT-5 那样通过依赖庞大而高成本的“专家路由”机制提供的自适应思考切换。
Total 5 articles
当前,业界顶尖的大模型正竞相挑战“过度思考”的难题,即无论问题简单与否,它们都采用 “always-on thinking” 的详细推理模式。无论是像 DeepSeek-V3.1 这种依赖混合推理架构提供需用户“手动”介入的快慢思考切换,还是如 GPT-5 那样通过依赖庞大而高成本的“专家路由”机制提供的自适应思考切换。
国产自研开源模型,让模型不用在快思考和慢思考间二选一了!
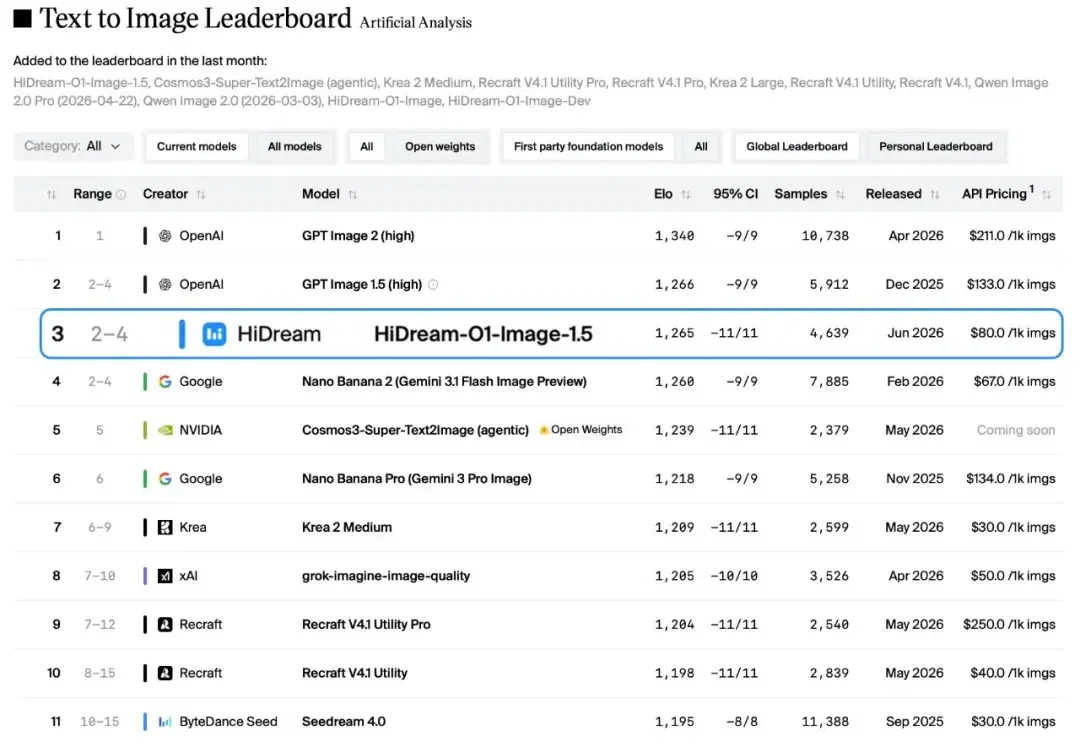
文生图的"慢思考",到底有没有用? “8B 开源版是一扇窗,真正的风景还在 200B+ 参数的 Pro 版本之后。” 智象未来 HiDream-O1-Image 开源版(8B)发布之后,我在测评最后留下了这样一句判断。前者以 Peanut 匿名登上 AA 榜、拿下文生图开源模型全球第一的事迹犹在眼前,今天 1.5 闭源版本又和公众见面了。 珠玉在前,HiDream-O1-Image-1.5 可以说是备受瞩目,而智象未来的官方口径很大程度上回应了这种期待:“连续登顶不仅印证了智象未来在图像生成大模型上的硬核实力,更标志着公司已稳居全球视觉生成大模型的第一梯队”。 看过 1.5 版本在 Artif
今天,“港股AGI第一股”云知声发布其最新通用大语言模型U2,该模型是由云知声自研的、基于快慢思考融合的MoE(混合专家)范式构建的通用大语言模型。U2跳出了传统大模型盲目堆参数、堆Token的内卷路径,实现了“小参数强能力、少Token高产出、低算力低成本”的进化。
Sora画下的饼终于被做熟了!用DeepSeek式的慢思考逻辑,把AI视频从「看运气抽卡」变成了「确定性交付」,这才是电商人真正需要的工业革命。