王兴一鸣惊人!美团首个开源大模型追平DeepSeek-V3.1 (opens in a new tab)
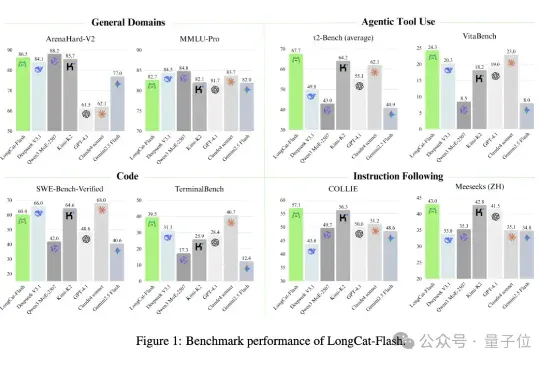
没想到啊,最新SOTA的开源大模型…… 来自一个送外卖(Waimai)的——有两个AI,确实不一样。 这个最新开源模型叫:Longcat-Flash-Chat,美团第一个开源大模型,发布即开源,已经在海内外的技术圈子里火爆热议了。
Total 23 articles
没想到啊,最新SOTA的开源大模型…… 来自一个送外卖(Waimai)的——有两个AI,确实不一样。 这个最新开源模型叫:Longcat-Flash-Chat,美团第一个开源大模型,发布即开源,已经在海内外的技术圈子里火爆热议了。
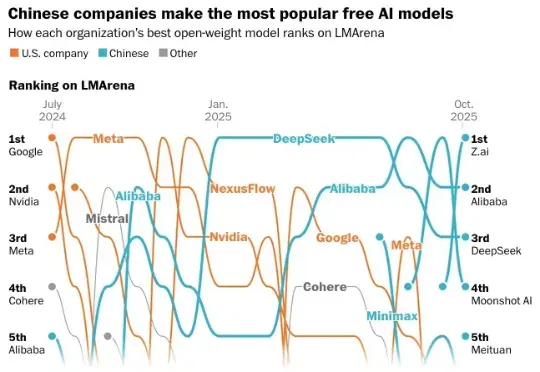
开源大模型,进入中国时间。 10月,公开数据显示,来自中国的开源大模型已经牢牢占据榜单前五。 阿里的Qwen系列和DeepSeek,更是从2024年下半年起,就在开源社区构建起越来越深远的影响力。
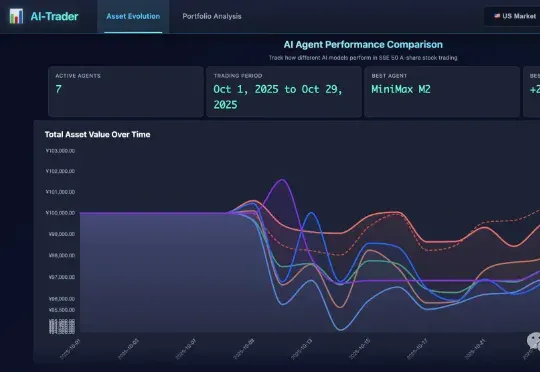
屠榜开源大模型的MiniMax M2是怎样炼成的?为啥M1用了Linear Attention,到了M2又换成更传统的Full Attention了? 面对现实任务,M2表现得非常扛打,在香港大学的AI-Trader模拟A股大赛中拿下了第一名,20天用10万本金赚了将近三千元。
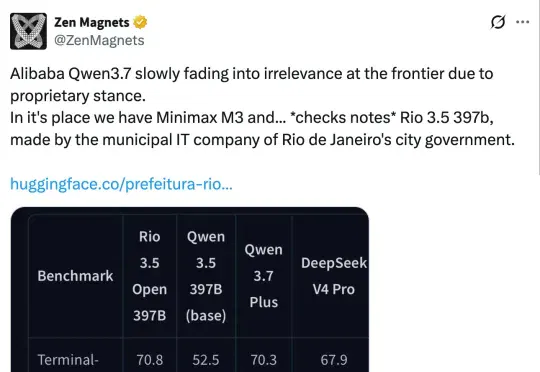
今天,除了全球(非美)被禁的 Claude Fable 5,AI 社区还被一个开源模型刷屏了。有推特博主发现,一个由巴西里约热内卢市政府旗下 IT 公司开源的模型 Rio 3.5 397B,在多项基准测试中超越了 Qwen 3.7 Plus 等开源模型,而这个模型的基础模型还是 Qwen3.5-397B-A17B。
最近,月之暗面 kimi 正式开源 Kimi K3 完整模型权重,Kimi K3 是一款总参数量达 2.8 万亿、上下文窗口达 100 万 token 的 MoE 大模型,更是全球首个落地的近 3 万亿参数级开源大模型,引起业界热议。
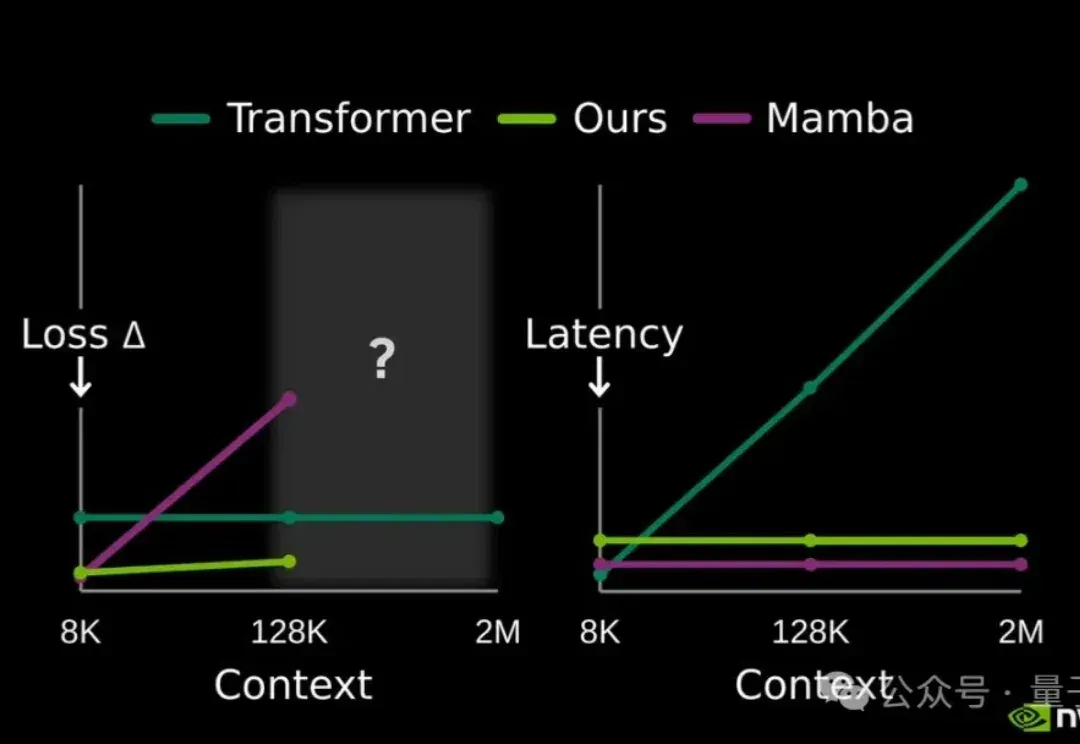
提高大模型记忆这块儿,美国大模型开源王者——英伟达也出招了。
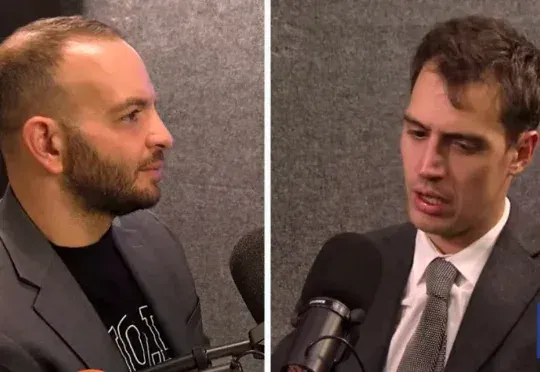
面对《the Big Technology Podcast》抛出的问题,Mistral AI的 CEO Arthur Mensch 表示:大模型肯定会走向商品化,当模型表现越来越接近,那么竞争就不在于模型本身,而在于如何让客户用起来。
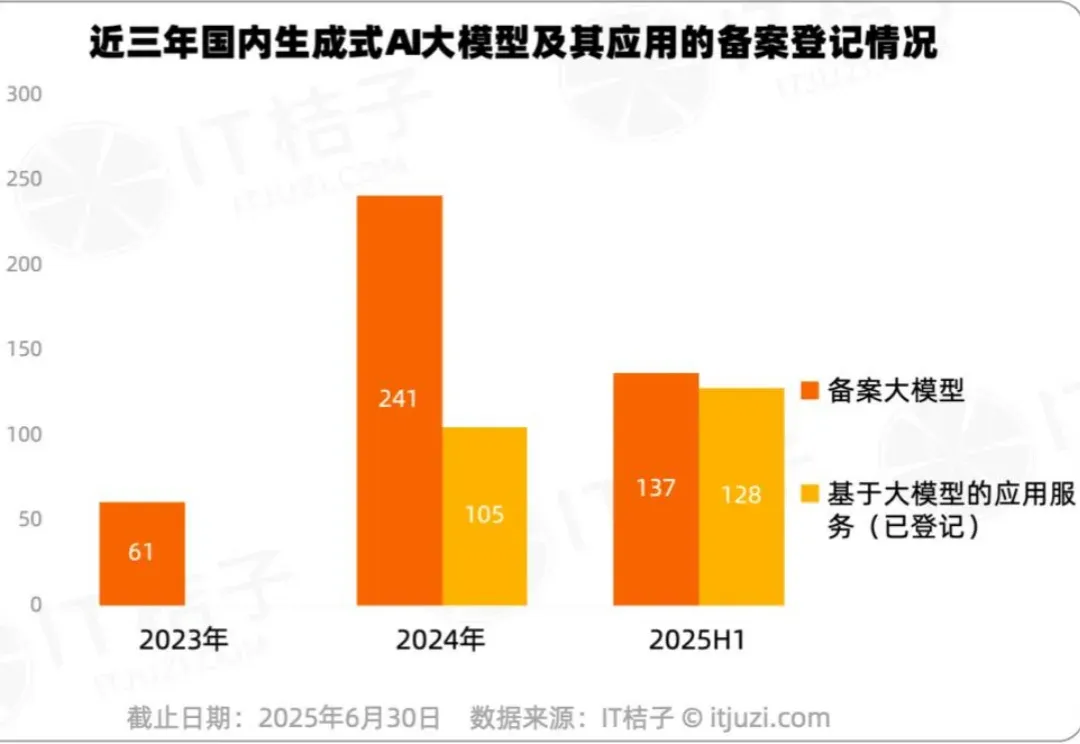
这些地区正在悄悄崛起 得益于AI技术的成熟和开源大模型的发展,中国生成式AI应用及服务正迎来爆发式增长。 根据国家网信办公示的生成式AI服务备案信息: 截至2025年6月,共439款生成式人工智能服务在国家网信办完成备案; 通过API接口或其他方式直接调用已备案模型能力的AIGC应用或产品完成登记的有233个(大部分产品表现形态为Agent)。 简单来说,如果是自研或者有显著微调、要做数据训练的大模型,需要备案。如果是基于已备案的大模型、无微调也无数据训练而开发的AIGC应用产品,无需备案,只需登记。 IT桔子对这些备案和登记的中国生成式AI模型及其应用的数据做进一步地处理,包括详细记录类型(
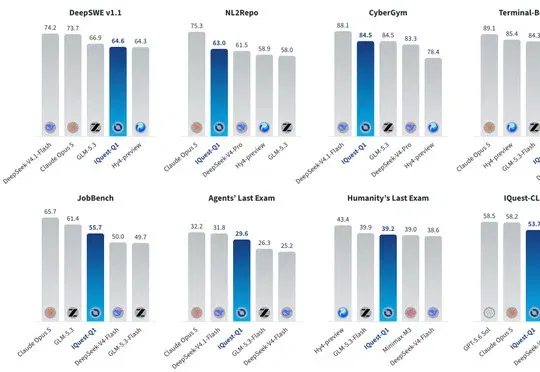
至知创新研究院开源了采用稀疏 MoE 架构的代码与复杂任务导向大模型 IQuest-Q1,该模型总参数约 320B、激活参数仅约 15B,在代码生成、终端操作、智能体任务等多项评测中表现均衡,并展示了从前端交互、游戏开发到强化学习训练调试等场景的可交付能力。
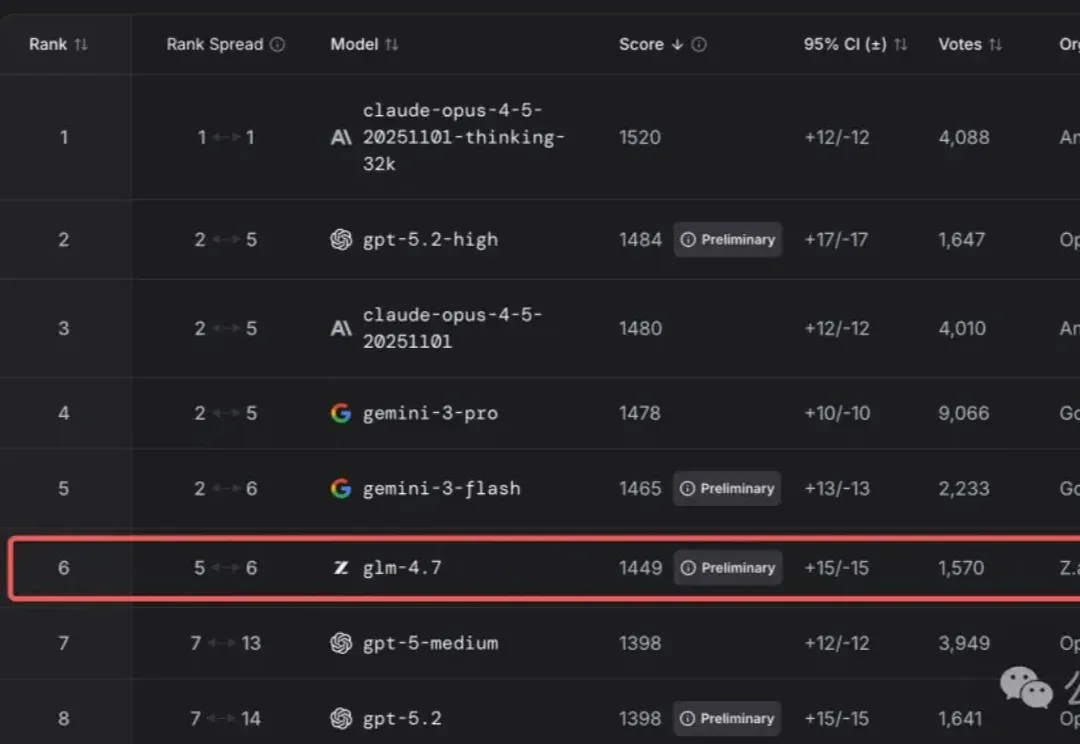
真是越到年底,越是神仙打架。 这不,智谱又又又发了新模型——GLM-4.7。 然后一举在代码竞技场WebDev榜单上超越GPT-5.2,拿下开源大模型第一! 现在网友们也正在拿它疯狂实测中,体验完几乎都是清一色的“Amazing”。 直接来感受一下网友拿着GLM-4.7和Gemini 3同时做的桌版溜溜球游戏,让网友直呼: GLM-4.7完胜! 那么,为什么GLM-4.7这次会在编程效果上有这么大的进步? 就在今天早些时候,智谱还特意在Reddit上举办了一场AMA(Ask Me Anything)活动,关于背后的一切,都已经回答得清晰明了。 关于GLM-4.7,智谱回答一切 这场对话不仅揭示