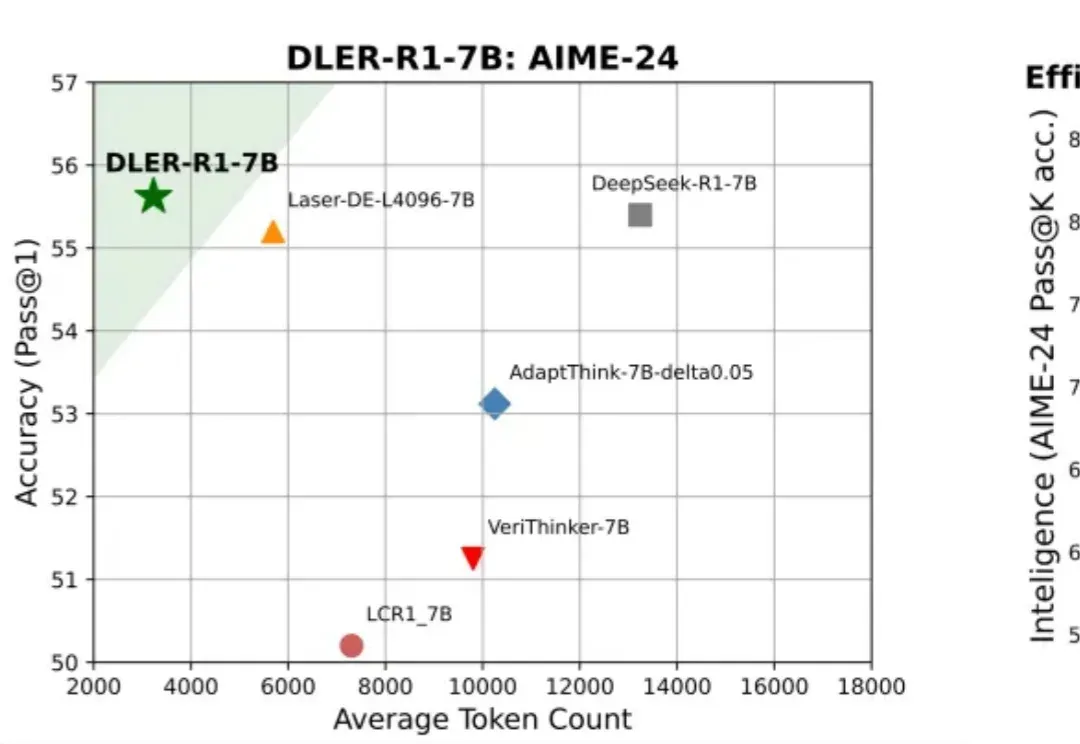
英伟达帮你省钱,让大模型推理「短而精」,速度快5倍 (opens in a new tab)
大模型推理到底要不要「长篇大论」?过去一年,OpenAI o 系列、DeepSeek-R1、Qwen 等一系列推理模型,把「长链思维」玩到极致:答案更准了,但代价是推理链越来越长、Token 消耗爆炸、响应速度骤降。
Total 30 articles
大模型推理到底要不要「长篇大论」?过去一年,OpenAI o 系列、DeepSeek-R1、Qwen 等一系列推理模型,把「长链思维」玩到极致:答案更准了,但代价是推理链越来越长、Token 消耗爆炸、响应速度骤降。
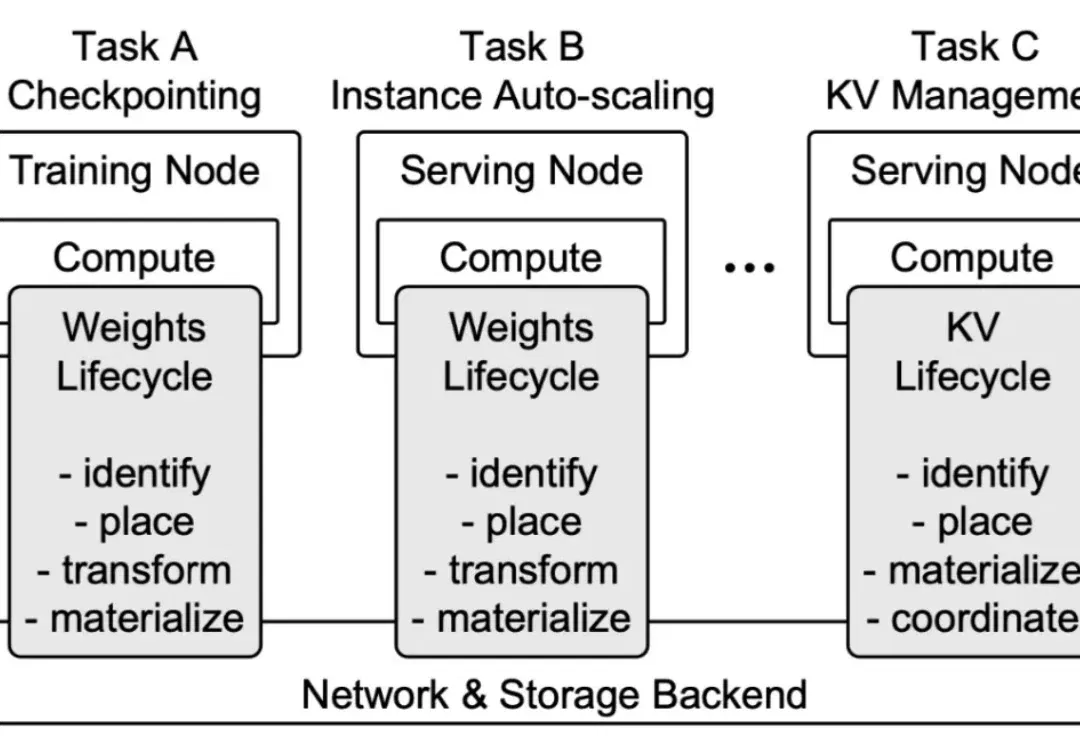
过去几年,大模型推理系统优化的核心目标一直围绕一个问题展开:如何让 GPU 更高效地计算权重、激活、KV Cache 等高维张量?从并行策略、请求调度、显存管理到算子优化,学界业界大量优化技术不断提升模型推理效率。
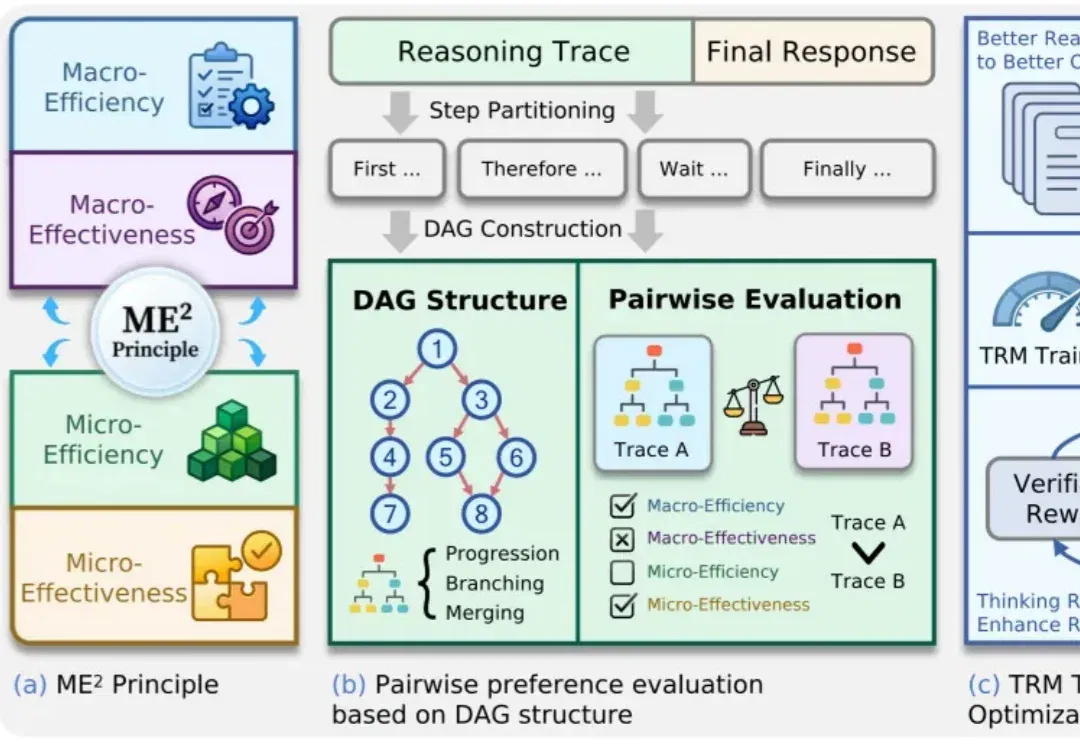
大模型推理能力越来越强,但答案对了,思考过程就一定好吗?
大模型推理的爆发,实际源于 scaling 范式的转变:从 train-time scaling 到 test-time scaling(TTS),即将更多的算力消耗部署在 inference 阶段。典型的实现是以 DeepSeek r1 为代表的 long CoT 方法:通过增加思维链的长度来获得答案精度的提升。那么 long CoT 是 TTS 的唯一实现吗?
没想到这也开源了。 10 月 20 日下午,DeepSeek 开源了内部使用的推理框架 DeepInfer,以及配套的 token 编解码组件 deepseek-recipe。 DeepInfer 是目前支撑 DeepSeek 大规模推理服务的基础,本次以 Apache 2.0 许可证发布,当前支持 DeepSeek-V4.1-Flash。 这次发布迅速引起了关注,昨天大家讨论的都是 DeepSeek 现在让大家都可以快速部署自己的 AI 模型了,今天转念一想,不对,大模型推理怎么这么赚钱啊? DeepSeek 披露,基于这套系统,单个集群每天服务的吞吐量达到 155 万亿 token,按 A
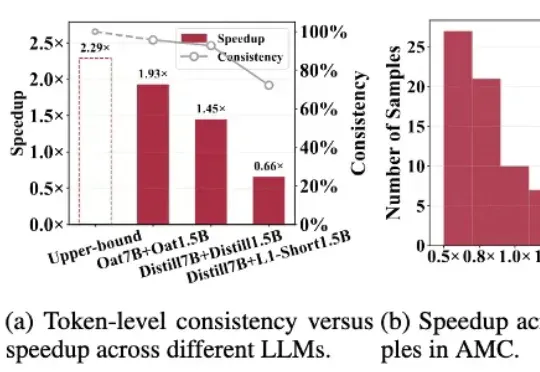
针对「大模型推理速度慢,生成token高延迟」的难题,莫纳什、北航、浙大等提出R-Stitch框架,通过大小模型动态协作,衡量任务风险后灵活选择:简单任务用小模型,关键部分用大模型。实验显示推理速度提升最高4倍,同时保证高准确率。
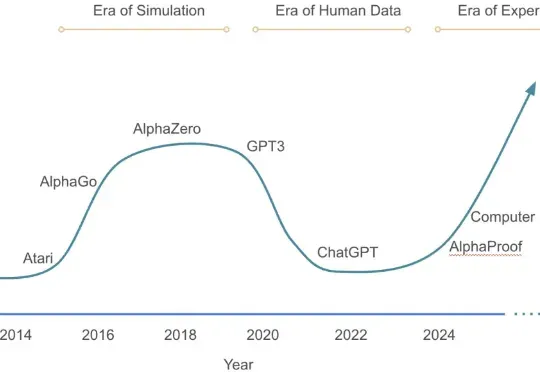
大模型在强化学习过程中,终于知道什么经验更宝贵了! 来自上海人工智能实验室、澳门大学、南京大学和香港中文大学的研究团队,最近提出了一套经验管理和学习框架ExGRPO—— 通过科学地识别、存储、筛选和学习有价值的经验,让大模型在优化推理能力的道路上,走得更稳、更快、更远。
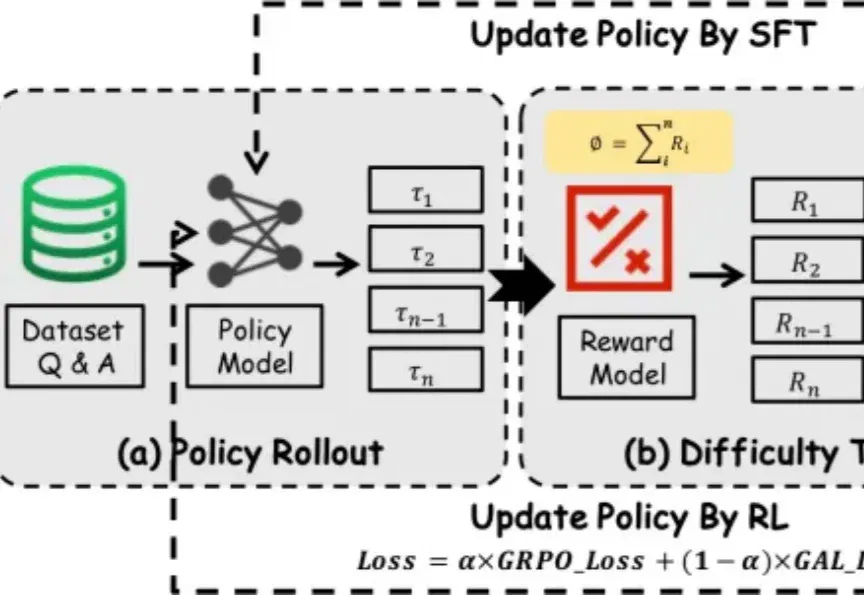
过去一段时间里,在围绕大模型推理能力增强的研究中,SFT 和 RL 是两类核心后训练范式 —— 前者稳定收敛快,能高效吸收高质量推理数据;后者更具探索性,有望推动模型实现复杂推理和分布外泛化。
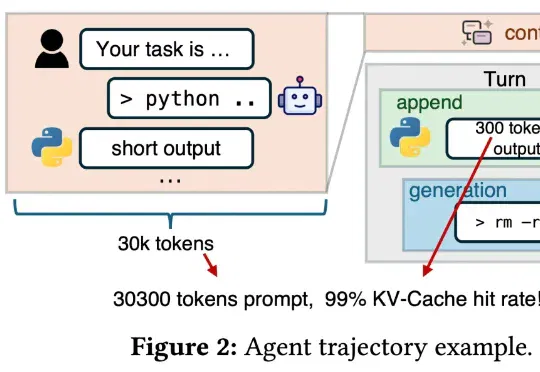
「DeepSeek V4 来了!」这样的消息是不是已经听烦了?总结来说,这篇新论文介绍了一个名为「DualPath」的创新推理系统,专门针对智能体工作负载下的大语言模型(LLM)推理性能进行优化。具体来讲,通过引入「双路径 KV-Cache 加载」机制,解决了在预填充 - 解码(PD)分离架构下,KV-Cache 读取负载不平衡的问题。
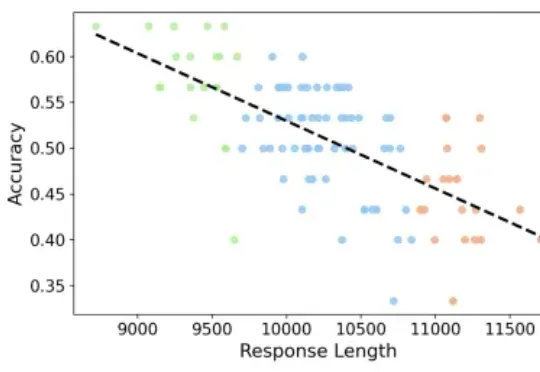
专注推理任务的 Large Reasoning Models 在数学基准上不断取得突破,但也带来了一个重要问题:越想越长、越长越错。本文解读由 JHU、UNC Charlotte 等机构团队的最新工作