阿里通义千问发布多模态智能体模型Qwen3.7-Plus,让AI从“读懂世界”,走向“动手完成任务”。 (opens in a new tab)
今天,阿里通义千问发布多模态智能体模型Qwen3.7-Plus。相比传统“看图说话”式多模态模型,Qwen3.7-Plus在识别图像的基础上,进一步打通界面感知、工具调用、代码生成和任务交付,让AI从“读懂世界”,走向“动手完成任务”。
Total 5 articles
今天,阿里通义千问发布多模态智能体模型Qwen3.7-Plus。相比传统“看图说话”式多模态模型,Qwen3.7-Plus在识别图像的基础上,进一步打通界面感知、工具调用、代码生成和任务交付,让AI从“读懂世界”,走向“动手完成任务”。
Z Potentials 独家获悉,新加坡国立大学博士,牛津大学博士后研究员林庆泓(Kevin)近期以首席研究员(Principal Researcher)身份加入世界模型公司 Video Rebirth,负责多模态智能体与世界模型相关研究。
商汤首席科学家林达华在专访中判断,未来一两年多模态将迎来能力涌现的"GPT时刻",并阐述商汤以原生理解生成统一模型U系列和多模态智能体模型SenseNova 6.8为核心的长期技术路线。
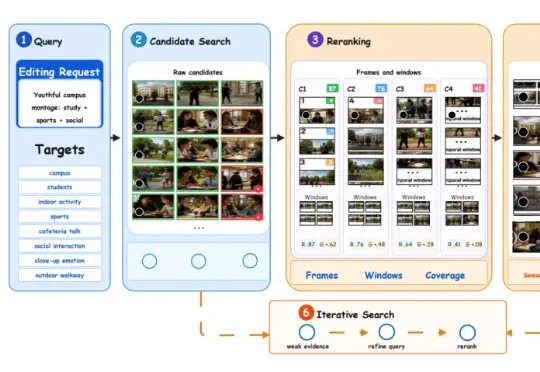
近年来,大语言模型(LLMs)在长篇视觉叙事中展现出卓越潜力,生产方式正迅速从单一模型生成转向面向生产的智能体系统。但长视频剪辑仍然是一个极难控制的长期任务。模型有时会在缺乏素材依据的情况下强行生成,甚至在面对明显断档的转场或人物不一致时依然“盲目拼接”。
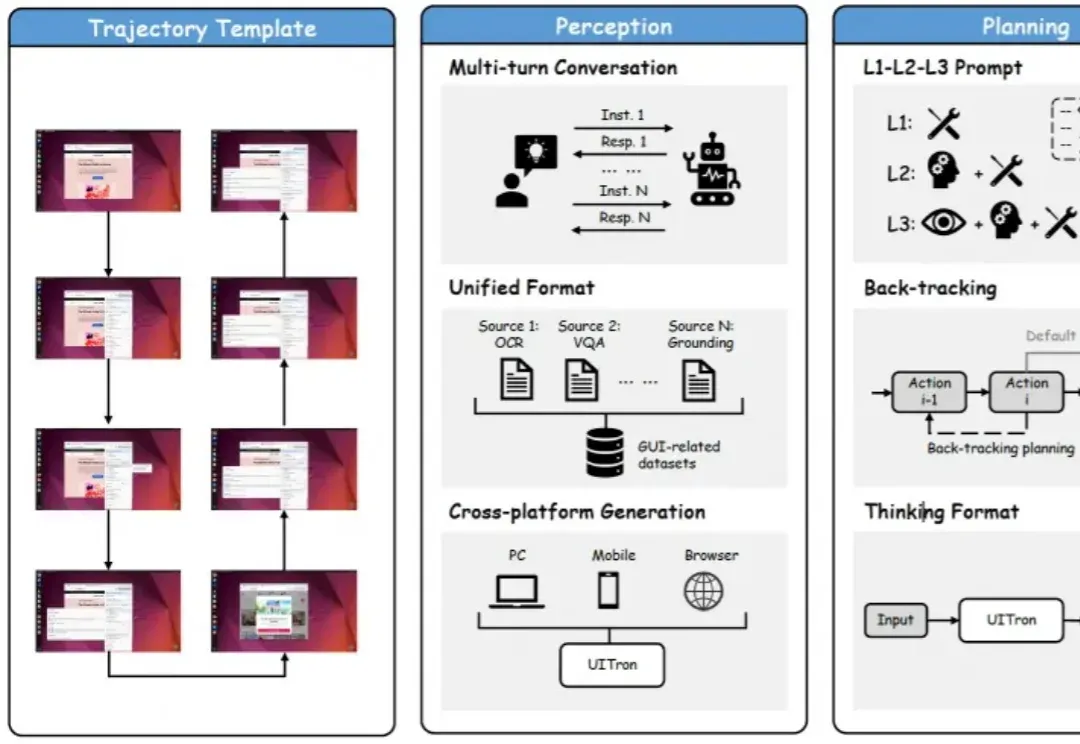
最新开源多模态智能体,能自动操作手机、电脑、浏览器的那种!开源评测榜单和中文场景交互成绩全面提升。