小米发布Xiaomi-Robotics-1具身基座模型:100000h真实数据,首次系统验证机器人Scaling Law (opens in a new tab)
今天,小米刚刚扔出一颗“深水炸弹”——Xiaomi-Robotics-1具身基座模型,试图改变这一局面。Xiaomi-Robotics-1基于10万小时真实世界操作轨迹进行预训练,再用约1.1万小时跨本体数据完成后训练。据悉,这是国内首次在机器人策略模型中,对Scaling Law进行较为完整的系统验证。
Total 6 articles
今天,小米刚刚扔出一颗“深水炸弹”——Xiaomi-Robotics-1具身基座模型,试图改变这一局面。Xiaomi-Robotics-1基于10万小时真实世界操作轨迹进行预训练,再用约1.1万小时跨本体数据完成后训练。据悉,这是国内首次在机器人策略模型中,对Scaling Law进行较为完整的系统验证。
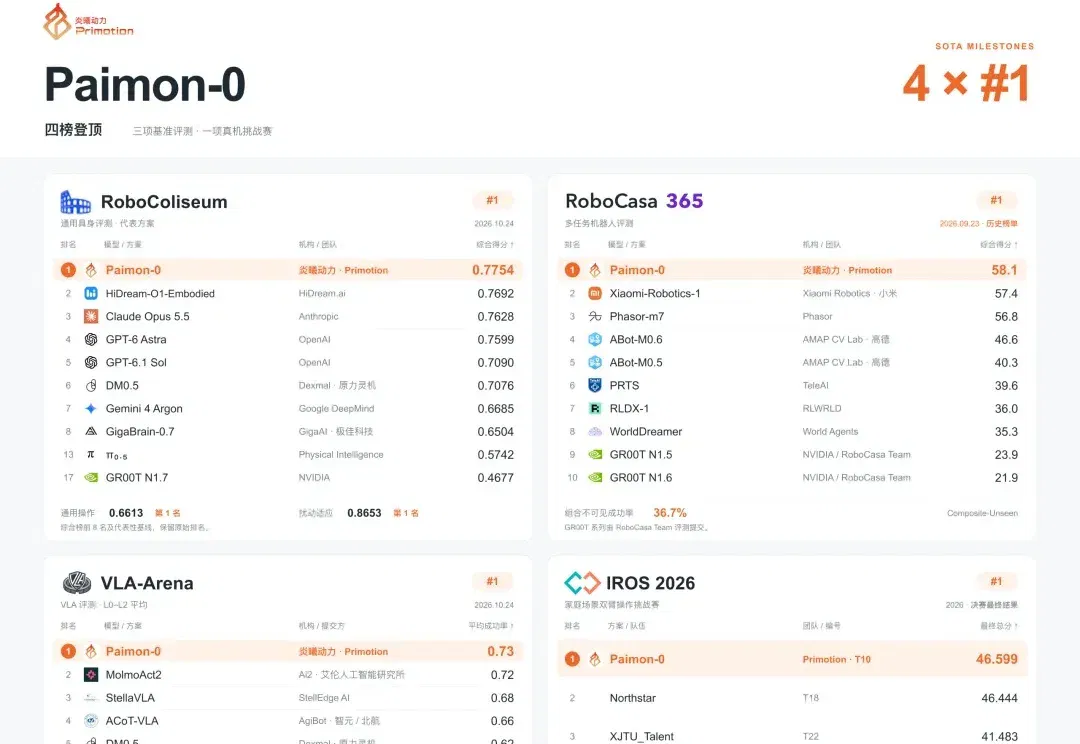
太反差了。 一家在深圳成立刚满三个月的公司,明明给自己的定位是做具身芯片,可它对外拿出的第一份成果,却是一个名叫Paimon的具身基座模型(系列)。 然后这个系列里的首款模型Paimon-0初次亮相,就直接拿下了四项第一: 先看含金量最高的RoboColiseum,这个由 Hugging Face、NVIDIA、清华大学等全球近 20 家高校、企业、科研机构共建的榜单,最近在具身圈热度居高不下;Paimon-0 以 0.7754 分排在第一。 要知道,这个榜最近可是刚把GPT-6 Astra、Claude Opus 5.5、Gemini 4 Argon这些通用多模态大模型请进场同台比试的: 虽
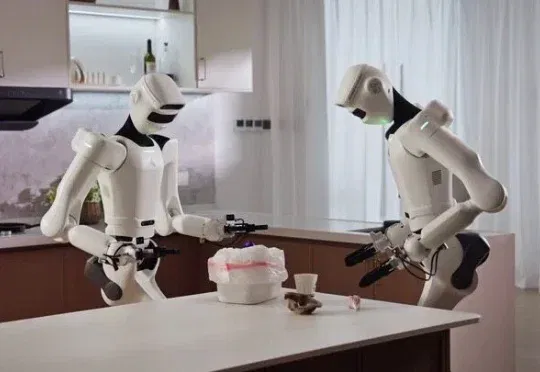
WAIC 前夕,星尘智能(Astribot)新模型 Lumo-2,直接在官网甩出 20 + 真机视频 ——这背后,是星尘智能发布的第二代具身基座模型,也是业内首个面向家庭场景的隐式世界 - 动作模型(Latent World-Action Model),同步发的,还智能体 Agent Philia。
过去几年,大模型把自然语言处理彻底重塑了。GPT 出来之前,NLP 领域的状态是:每个任务一套模型,每个场景一批数据,每个公司一条流水线,互不通用,边界清晰。GPT 之后,这套逻辑被一个预训练底座 + 任务微调的范式整个替换掉了。
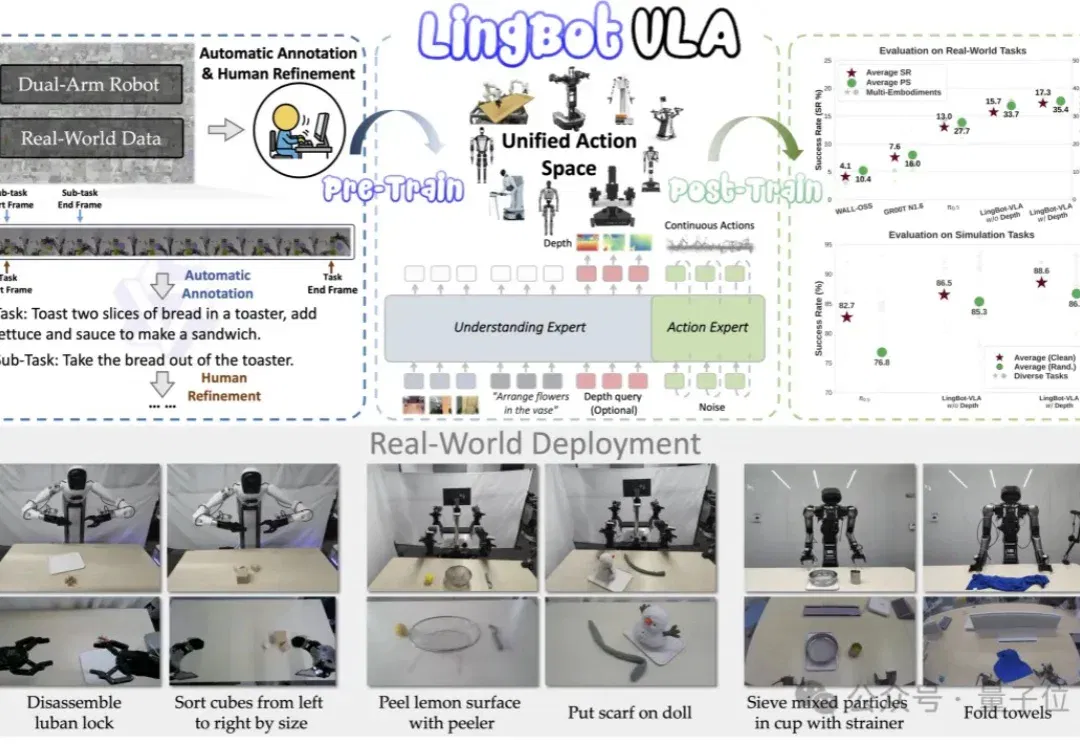
就在刚刚,蚂蚁集团旗下具身智能公司灵波科技传出新动作—— 全面开源其具身基座模型LingBot-VLA的真机后训练工具链。
这就是 Generalist 最新发布的 GEN-1.5 具身基座模型展现出的能力:模型开始从大规模人类操作数据中天然存在的重复、失误与恢复,学习到训练者没有逐项教过的动作,显露出某种智能涌现的迹象。