实时交互模型:一个还没形成共识的赛道,怎么就成了热门? (opens in a new tab)
实时交互模型尚未形成统一定义却已成为热门赛道,SigmaZ AI、Loopit、Reverie AI、Runway和Vidu等公司从原生音视频生成、Coding驱动等不同技术路线出发,探索AI在聊天框之外实时响应用户多模态输入的能力,行业正围绕定义权和稀缺交互数据展开竞争。
Total 13 articles
实时交互模型尚未形成统一定义却已成为热门赛道,SigmaZ AI、Loopit、Reverie AI、Runway和Vidu等公司从原生音视频生成、Coding驱动等不同技术路线出发,探索AI在聊天框之外实时响应用户多模态输入的能力,行业正围绕定义权和稀缺交互数据展开竞争。
Z Potentials 独家获悉,具身交互模型企业 CyboPal(江苏细胞壁智能科技有限公司)已完成数亿元融资,由东方富海领投,联想之星、天启资本等机构跟投,心流资本 FlowCapital 担任长期独家财务顾问。
Mira Murati 用一年半时间证明了「人机协作」不是一句口号。 5 月 11 日,Thinking Machines Lab 发布了一段研究预览视频,展示了他们所谓的「交互模型」(Interaction Model)。
2026年,视频生成赛道正在经历一场从“离线生成”到“实时交互”的范式转移。7月3日全球数字经济大会上——生数科技创始人朱军正式发布Vidu S1实时交互模型,让AI从“视频生成”正式迈入“实时交互”的新阶段。
本文综合北京大学王选计算机研究所发布的 ProactiveVideoQA 和 MMDuet2 两篇论文,介绍视频多模态大模型如何实现 “主动交互”—— 在视频播放过程中自主决定何时发起回复,而非等待用户提问。ProactiveVideoQA 提出评估指标和 benchmark,MMDuet2 则通过强化学习训练方法实现了 SOTA 性能,无需精确的回复时间标注即可训练出及时、准确的主动交互模型。
SparkAudio 1.0 将人声、环境声和说话人关系纳入音频理解,并在其上发展识别、同传和实时交互模型。智东西结合音频案例与办公、可穿戴产品,介绍这套基座加专用模型的技术路线及仍存在的分析局限。
Tavus发布全双工视频到视频交互模型Griffin,可实时生成720p数字人并理解停顿、表情与动作,在一分钟测试中让54名参与者近48%误以为在与人交谈,但该结果未独立验证且模型尚未公开。
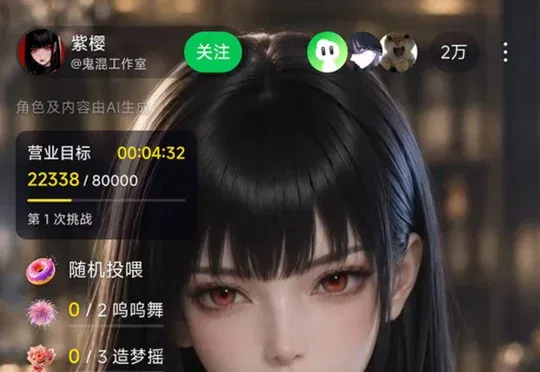
美女AI主播紫樱凭借生数科技最新实时交互模型Vidu S2开启直播首秀,开播5分钟涌入2万人,经多轮重开后靠自己挣到营业额,凭借逼真"活人感"引爆全网。
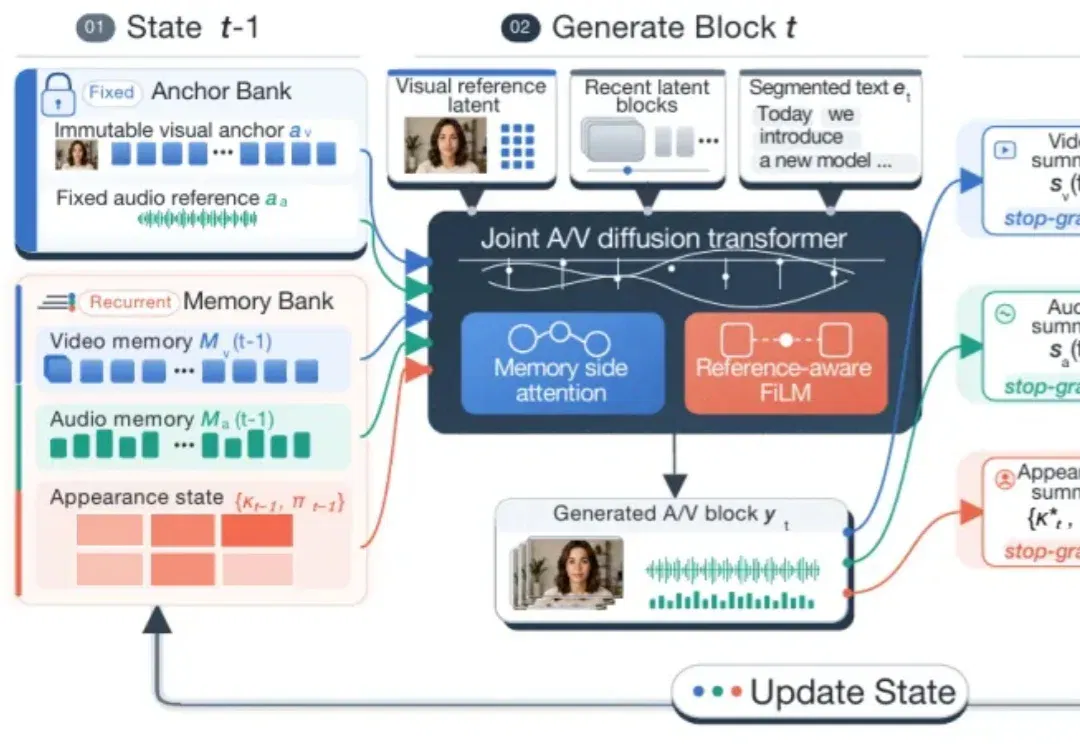
当数字人视频从数秒扩展到数分钟,生成系统面对的核心问题不再只是单帧质量,而是递归生成中的误差累积。
最近,AI 研究团队 Tavus 发布实时视频交互模型 Griffin,并公布了一项实验结果。在与其研究预览版 Griffin-Lite 进行一分钟视频通话后,54 名参与者中有 26 人认为,屏幕另一端坐着一个真人,占比约为 48%。