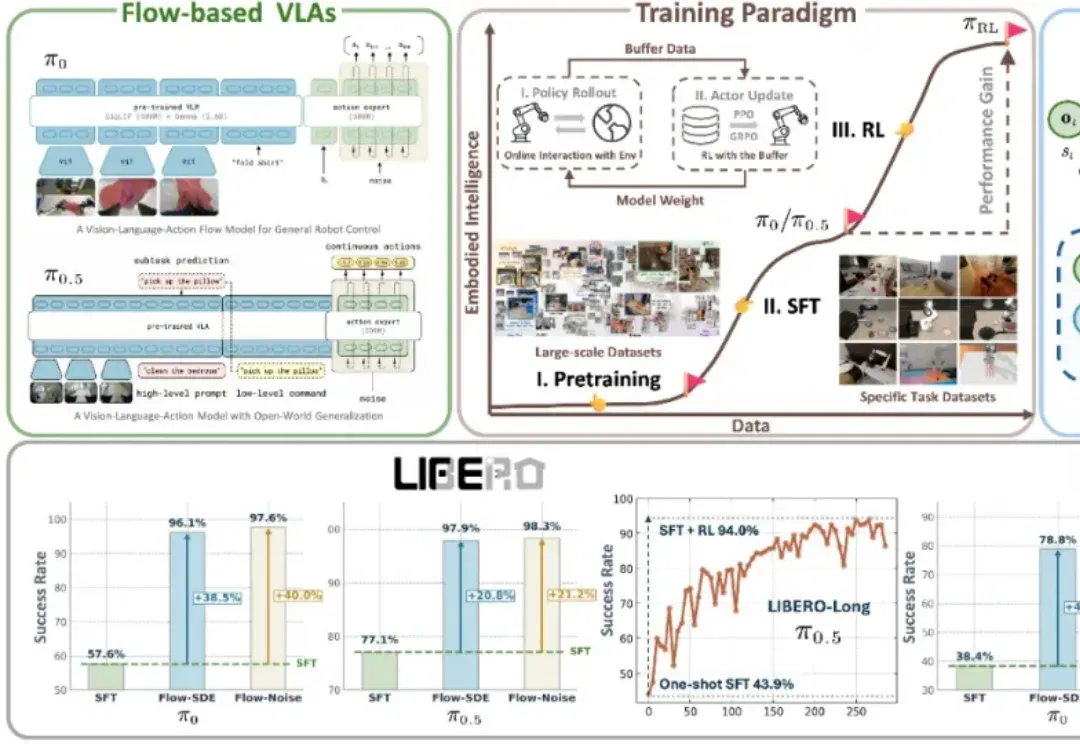
RLinf上新πRL:在线强化学习微调π0和π0.5 (opens in a new tab)
近年来,基于流匹配的 VLA 模型,特别是 Physical Intelligence 发布的 π0 和 π0.5,已经成为机器人领域备受关注的前沿技术路线。流匹配以极简方式建模多峰分布,能够生成高维且平滑的连续动作序列,在应对复杂操控任务时展现出显著优势。
Total 14 articles
近年来,基于流匹配的 VLA 模型,特别是 Physical Intelligence 发布的 π0 和 π0.5,已经成为机器人领域备受关注的前沿技术路线。流匹配以极简方式建模多峰分布,能够生成高维且平滑的连续动作序列,在应对复杂操控任务时展现出显著优势。
今天凌晨,Physical Intelligence发布了全新的VLA模型π0.7,狠狠敲了世界模型一记闷棍。π0.7第一次在机器人领域证明了Compositional Generalization(组合泛化),且VLA。
继π0后,具身智能基座模型在中国也终于迎来了真正的开源—— 刚刚,WALL-OSS宣布正式开源!在多项指标中,它还超越了π0。如果你是搞具身的开发者,了解它的基本资料,你就一定不会想错过它:
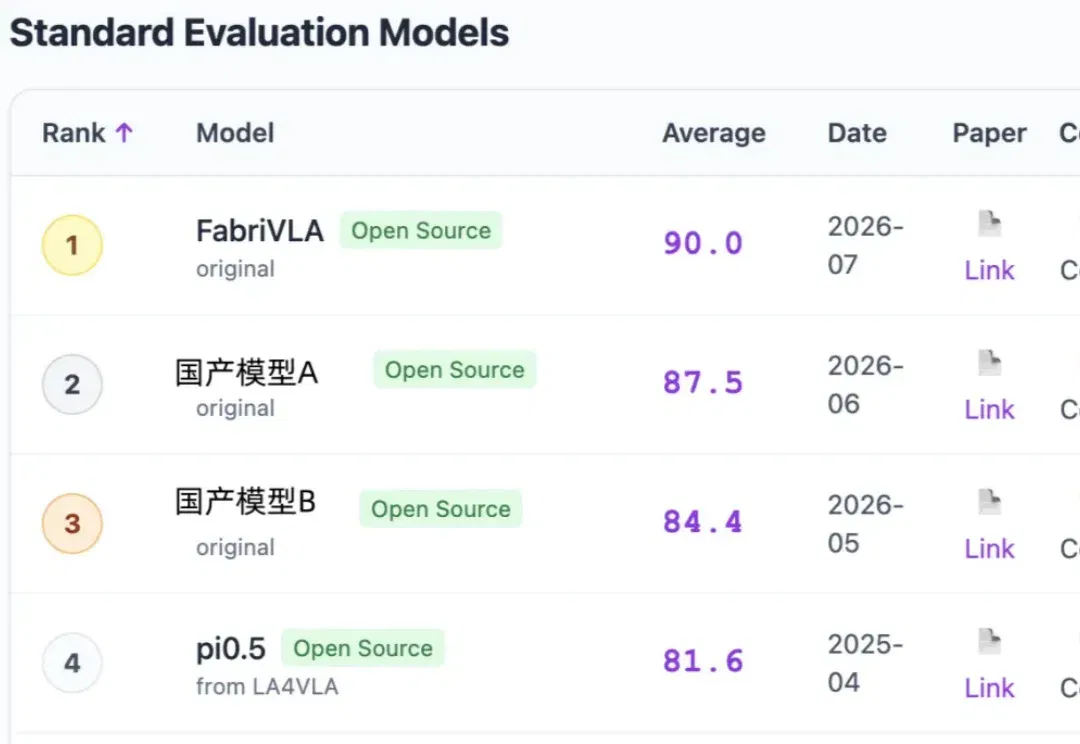
谁能想到,在全球具身智能操作能力的顶级榜单上,打败海外标杆模型π0的,居然是一个只有1B级参数的轻量级模型。
数亿美金,竟输给了一台相机? 一边,是硅谷明星机器人初创Physical Intelligence,用数亿美金算力砸出来的明星大模型π0.5。另一边,是一家中国公司,加一台随手能买到的运动相机。 7月15日,银河通用发布WAM-TTT,全球首个面向具身智能大模型的测试时后训练框架。 随框架一起公布的跨环境实测里,双方正式pk,结果令人意外—— 光照一变、物体一换、背景一乱,π0.5的平均成功率直接砍半,而WAM-TTT泛化保持率为76%! 想象机器人进家的第一天:你家的马克杯它没见过,厨房灯也偏暖,台面还比它训练时高5厘米。看起来只是这一点细微的差别,但足以让一台千锤百炼的机器人当场卡壳。 对
机器人拉个拉链,到底需不需要“脑子”? 过去几年,从OpenVLA到π0、π0.5,具身大模型已经能让机器人把指令和动作连得有模有样。 但一旦包的位置挪了几厘米,或者光照暗了一点,它们往往就会“大脑宕机”。 究其原因,是因为这些机器人大多在玩“连连看”:看到观察结果,直接输出动作。 它们只是记住了轨迹,却并不理解背后的物理逻辑。 现在,一种让机器人“先想明白,再稳定行动”的新范式来了。 由至简动力、北大、港中文联合提出的LaST-R1,首次将隐空间物理推理塞进了强化学习的闭环。 同时,LaST-R1作为LaST₀基座模型的物理世界后训练范式,LaST₀首创面向机器人的隐空间物理思维链推理,并已
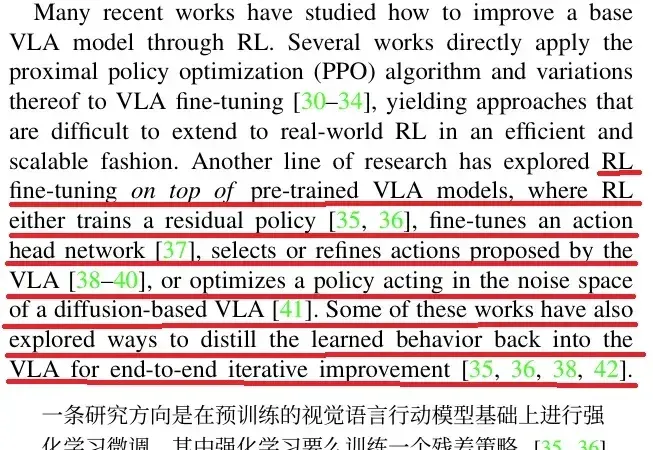
在 Physical Intelligence 最新的成果 π0.6 论文里,他们介绍了 π0.6 迭代式强化学习的思路来源:
清华大学联合无问芯穹与上海交通大学开源了面向具身模型的端侧推理引擎APXInf,通过全栈优化在Thor芯片上将π0.5推理速度提高约10.7倍,并引入可由Agent执行的工程化流程以适配模型的持续迭代。
机器人撬开啤酒瓶盖,白色泡沫顺着瓶口涌出来。
大家好,我是瓦力,具身算法研究员。 我有个习惯,隔三差五都会去 PI 的官网刷一下,看他有没有新东西。最近这三个月,官网主页是一动没动,停在四月的 π0.7。