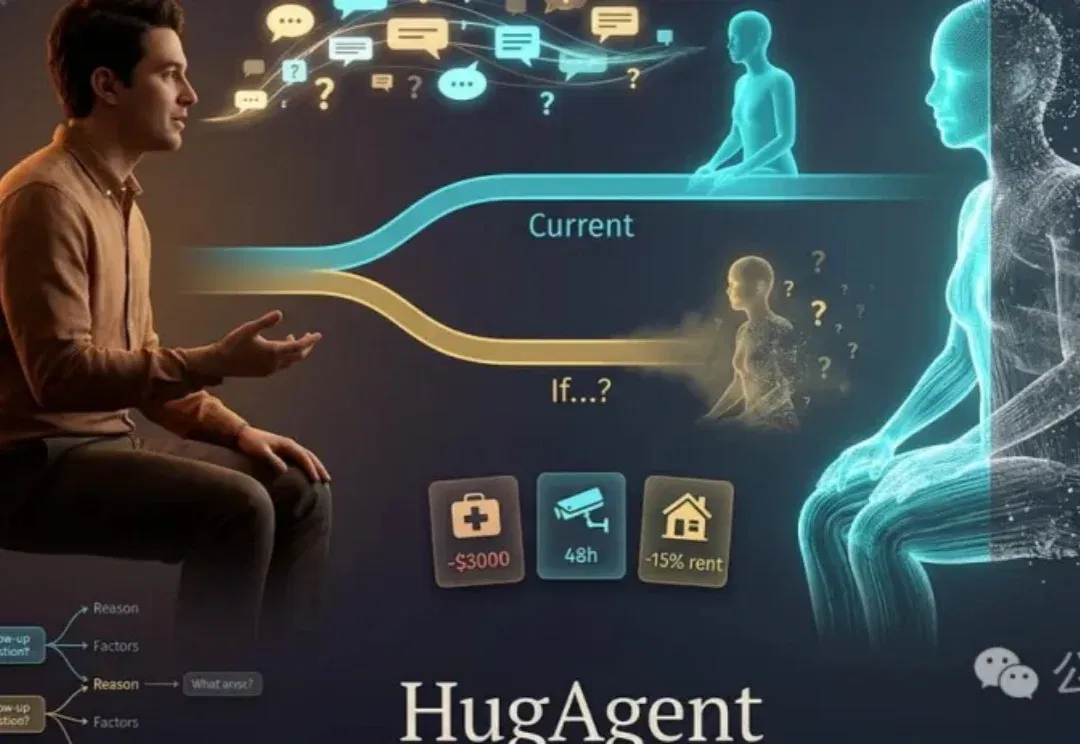
EMNLP'26 Oral | 麻省理工:靠访谈让AI模拟真人,这条路能走多远? (opens in a new tab)
只要和一个人聊得足够久,大模型就能成为他的「数字分身」吗?
Total 1519 articles
只要和一个人聊得足够久,大模型就能成为他的「数字分身」吗?
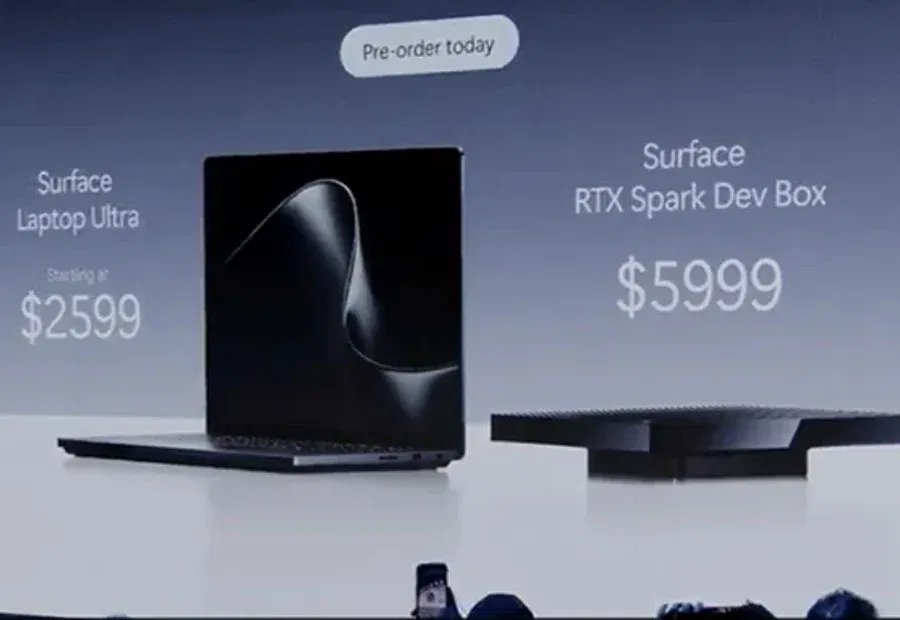
最高20核CPU、6144核GPU、128GB统一内存、1PFLOPS本地AI算力。
在这个被大模型和 AI 融资神话包裹的 2026 年,如果有人问:谁是国内大厂 AI 产品经理最危险的竞争对手?
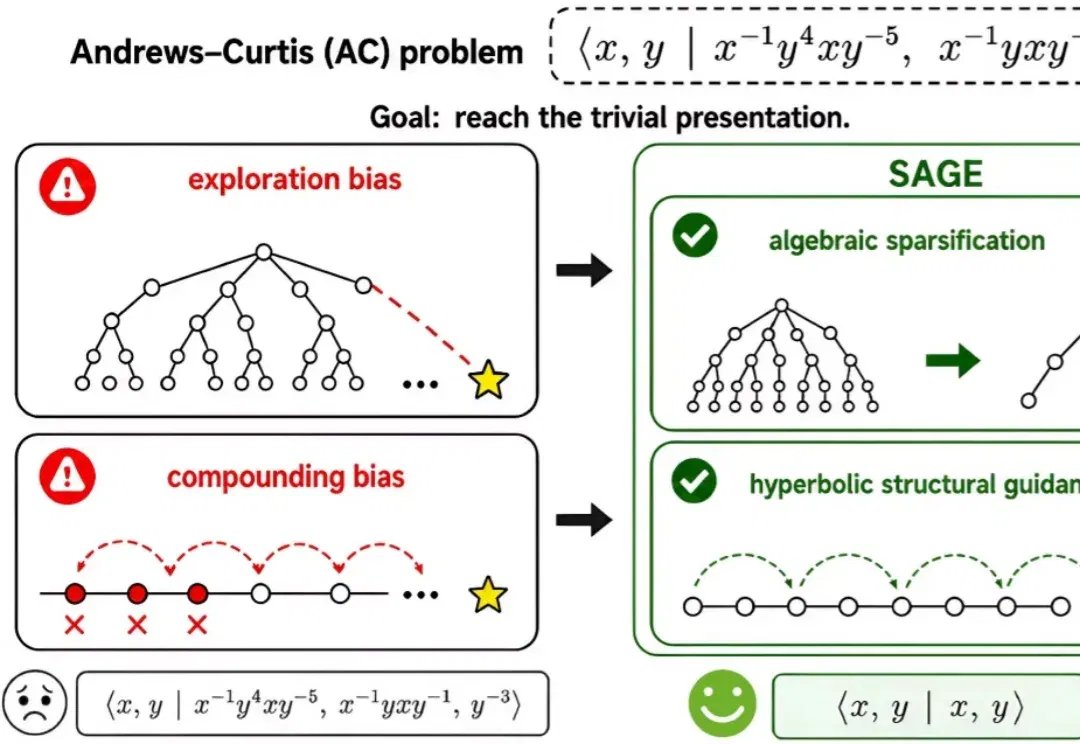
大模型解短题常能给出流畅答案,推理链一长,却可能每一步都看似合理、终点仍然失效。来自弗吉尼亚理工大学、威斯康星大学麦迪逊分校和达特茅斯学院的研究团队在 NeurIPS2026 论文中提出 SAGE:用符号闭包分析(SCA)解释长推理中的探索偏差与累积偏差,再把这一诊断变成训练时的结构引导。
来自上海创智学院、复旦大学、伦敦国王学院与牛津大学等机构的研究团队推出SocioVerse2,将大模型社会模拟扩展为可干预、可迭代、可回溯的开源社会科学研究框架。
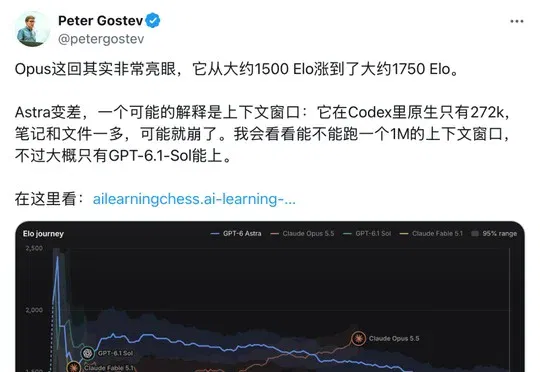
大模型竞技场Arena让Claude Opus 5.5与GPT-6 Astra各自练棋200局,前者估算评分从约1500升至1760,后者从第29盘的1810降至1400,显示AI仅靠记录与复盘提升能力的表现并不一致。
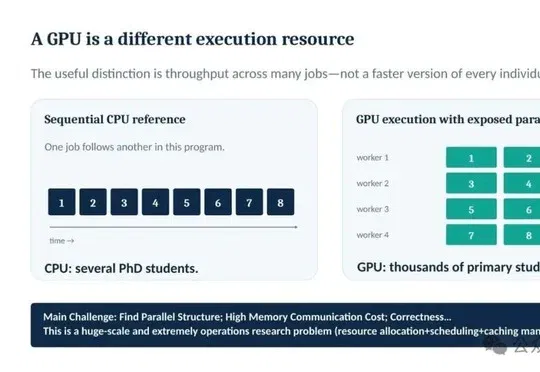
港科大团队在NeurIPS 2026上提出AccelEval基准,覆盖6个领域42项任务和43类CUDA优化策略,评测大模型能否从可信CPU程序生成端到端更快的GPU实现,其中Gemini 3.1 Pro在中规模通过正确性验证的任务上取得71.2倍几何平均加速比。
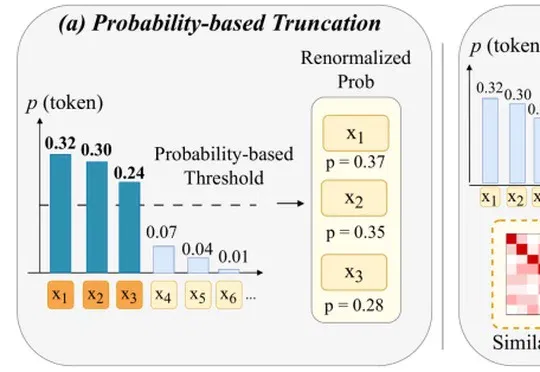
中国人民大学代文林、孟澄研究员团队提出的ME-Decoding方法被EMNLP 2026接收,该方法在解码时同时利用token概率与embedding相似度,从集合层面筛选低冗余候选token,在GSM8K和GPQA上取得所比较方法中最高的平均准确率,端到端GPU延迟仅增加约3%。
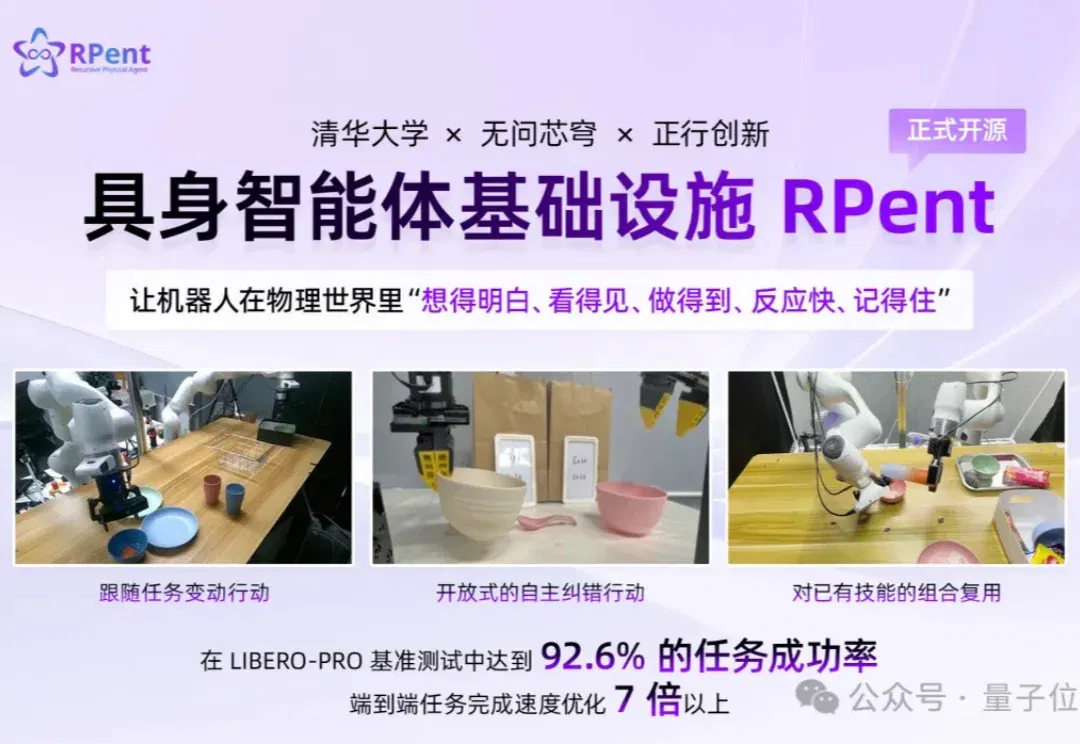
Codex、Claude Code等数字世界智能体,已经向我们展示出了一种全新且高效的工作方式:大模型理解目标,拆解任务,调用适当的工具,并根据执行结果不断调整计划,直到完成任务。
「思考力商品化」的新经济。 9 月 22 日,杭州云栖大会。阿里巴巴集团 CEO 吴泳铭和往年一样,做了开场的主旨演讲。 过去几年云栖大会的主旨演讲,可以当作「技术风向标」来听,会抛出很多重磅的技术判断,比如,「大模型是下一代操作系统」、「超级 AI 云是下一代计算机」。 但这一次,我听完的感受很不一样。吴泳铭花了很多时间讲工业革命、讲电、讲经济学。他的重心不在 AI 会变成什么样了,他讲的是,AI 会让世界变成什么样。 比如他给出的一个核心观点,「上一次这样的变化,是工业革命把动力变成了规模化的商品。人类先后发明了蒸汽机、内燃机和电,并围绕它们建立起了现代产业。这一次,轮到思考。」 当一个