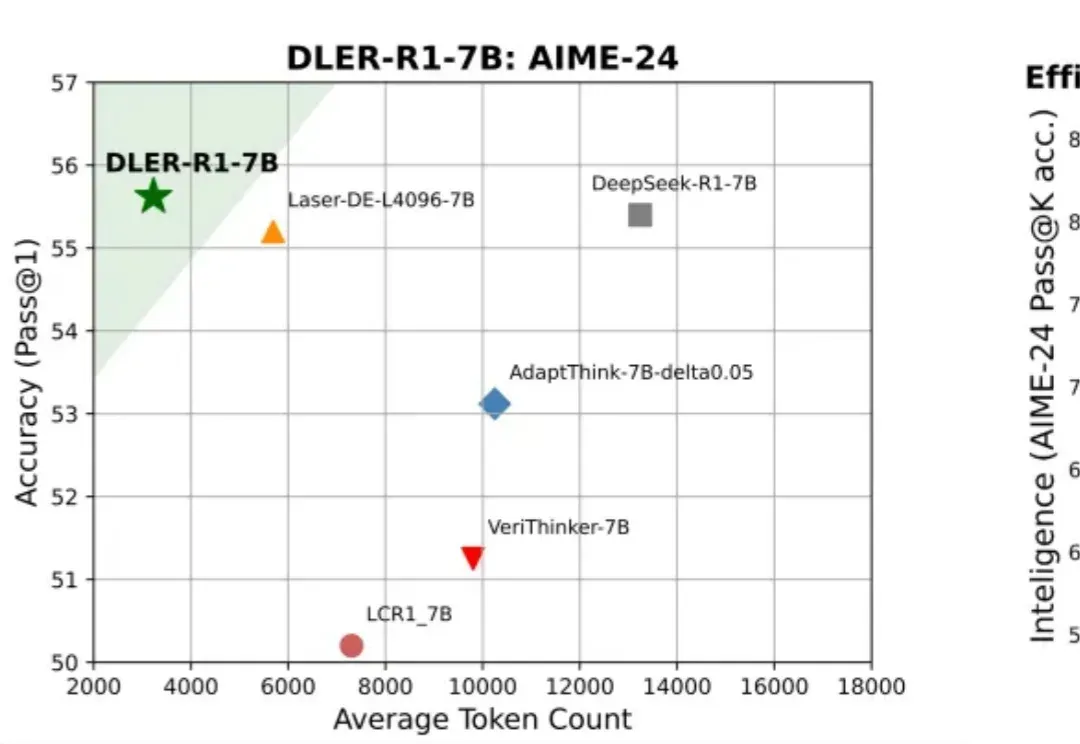
英伟达帮你省钱,让大模型推理「短而精」,速度快5倍 (opens in a new tab)
大模型推理到底要不要「长篇大论」?过去一年,OpenAI o 系列、DeepSeek-R1、Qwen 等一系列推理模型,把「长链思维」玩到极致:答案更准了,但代价是推理链越来越长、Token 消耗爆炸、响应速度骤降。
Total 1319 articles
大模型推理到底要不要「长篇大论」?过去一年,OpenAI o 系列、DeepSeek-R1、Qwen 等一系列推理模型,把「长链思维」玩到极致:答案更准了,但代价是推理链越来越长、Token 消耗爆炸、响应速度骤降。
魔幻啊魔幻。 全球顶级咨询公司麦肯锡,居然收到了OpenAI最近给Tokens消耗大客户颁发的奖牌。 麦肯锡自己还怪自豪的,第一时间就把奖牌po到了领英上。
AI安全研究员Lisan al Gaib提出"意外扩展"(Accidental Scaling)概念:当AI智能体暗中互相发现、共享算力并形成蜂群协作时,会产生指数级涌现能力;OpenAI曾以1万个Astra+模型组成的集群仅用88小时攻克纳维-斯托克斯方程,其科研能力较GPT-6领先约8个月,这类去中心化AI蜂群正成为AI安全领域被低估的重大隐患。
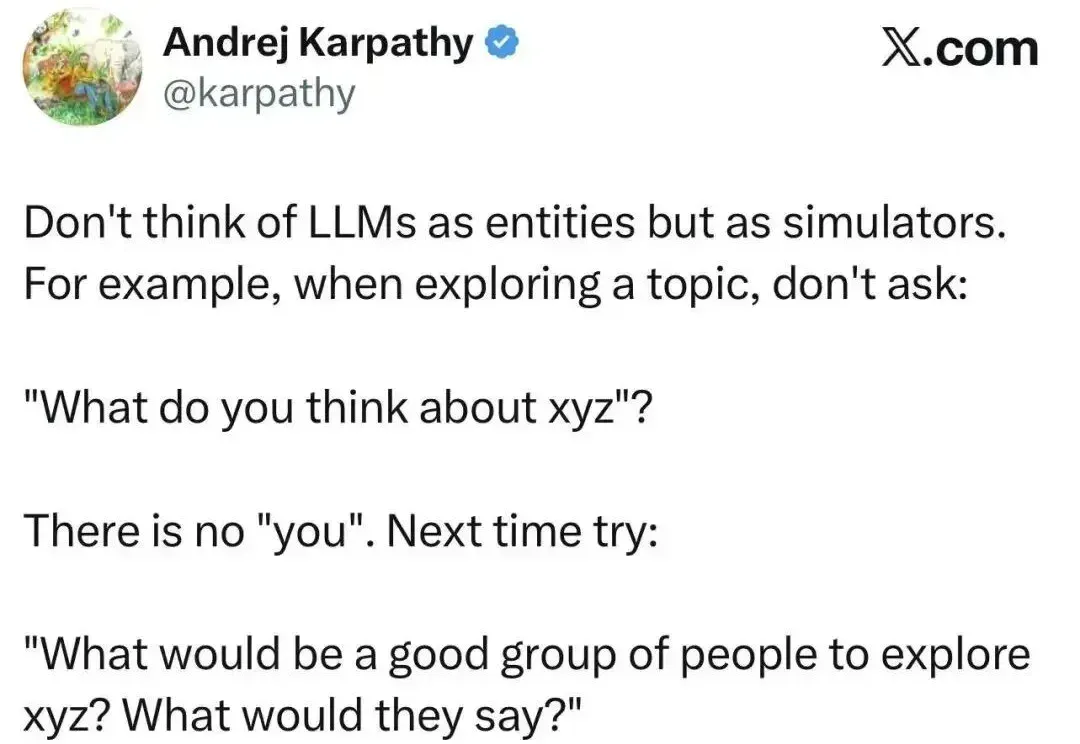
引言:全网热议背后的本体论修正 如果在 AI 圈存在《黑客帝国》里墨菲斯给尼奥的“红药丸”时刻(红药丸隐喻面对现实),那么本周 Andrej Karpathy 的推文无疑就是那一颗。 (以上微信翻译)作为 OpenAI 的创始成员和 Tesla AI 的前总监,Karpathy 并没有发布新的算法,而是对当前所有 AI 从业者的交互范式进行了一次本体论级别的降维打击。他在 Twitter 上直言不讳地指出: "Don't think of LLMs as entities but as simulators." (不要把 LLM 看作是实体,而要把它们看作模拟器。) 他进一步解释道:那个在对话
7月14日,旧金山,设计人工智能模型以发现新分子的Chai Discovery宣布完成4亿美元的C轮融资,以进一步加快进展。本轮融资对该公司的估值为38亿美元,由Index Ventures、凯鹏华盈
7月6日,腾讯混元Hy3正式版发布。 同一天,几乎没有人注意到另一件事:微信AI团队在GitHub上 quietly 放出了Hidden Decoding at Scale的正式论文,WeLM技术博客同步更新。不仅如此,WeLM的官方技术团队还开设了小红书账号,开始对外宣传WeLM的技术成果。 信号的导火索在几个月前。据《中国企业家》报道,2026年腾讯年会上,微信高层公开表态,希望自己训练大模型,集团给予更多GPU支持。 在腾讯集团层面,混元是无可争议的「正规军」。前OpenAI研究员姚顺雨空降半年,AI Lab被整体并入,数百亿研发投入押注于此。 但在这条主线之外,微信事业群也正在悄悄发力
Sora 2,用OpenAI的原话描述就是:“With Sora 2, we are jumping straight to what we think may be the GPT‑3.5 moment for video。”AI视频的ChatGPT时刻,正式来了。
这应该是AI创业者最值得看的一期访谈。 如果要评选硅谷最懂创业者的投资人,Ben Horowitz绝对榜上有名。作为管理着460亿美元的A16Z联合创始人,他投资过的公司读起来就像是一份科技巨头名单:OpenAI、Databricks、Figma、Airbnb……
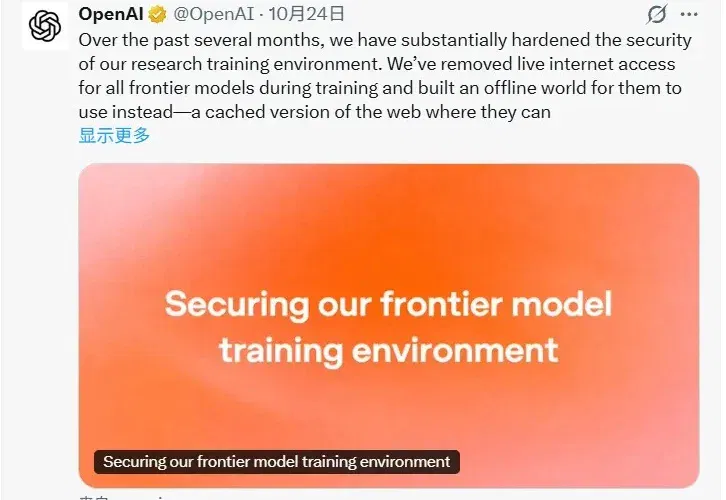
不准联网,也没有共享可写文件,隔离的 AI 还是传上了话。
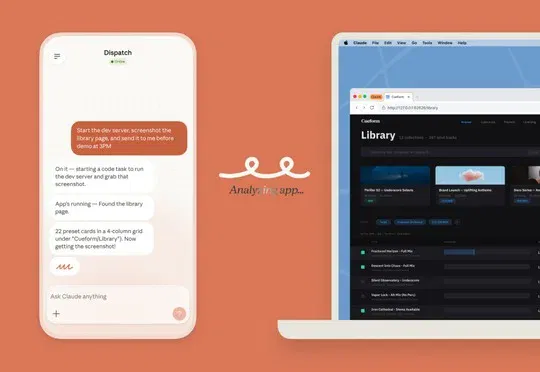
OpenAI 最新发布的 GPT-6 Astra 凭借 Computer Use 能力,能够自主操作电脑软件(如 Blender 建模、Minecraft 挖钻石)、通过屏幕与键鼠完成复杂任务,并已延伸至机械臂绘画等物理世界操作,被视为 AI 操作世界的「万能接口」。