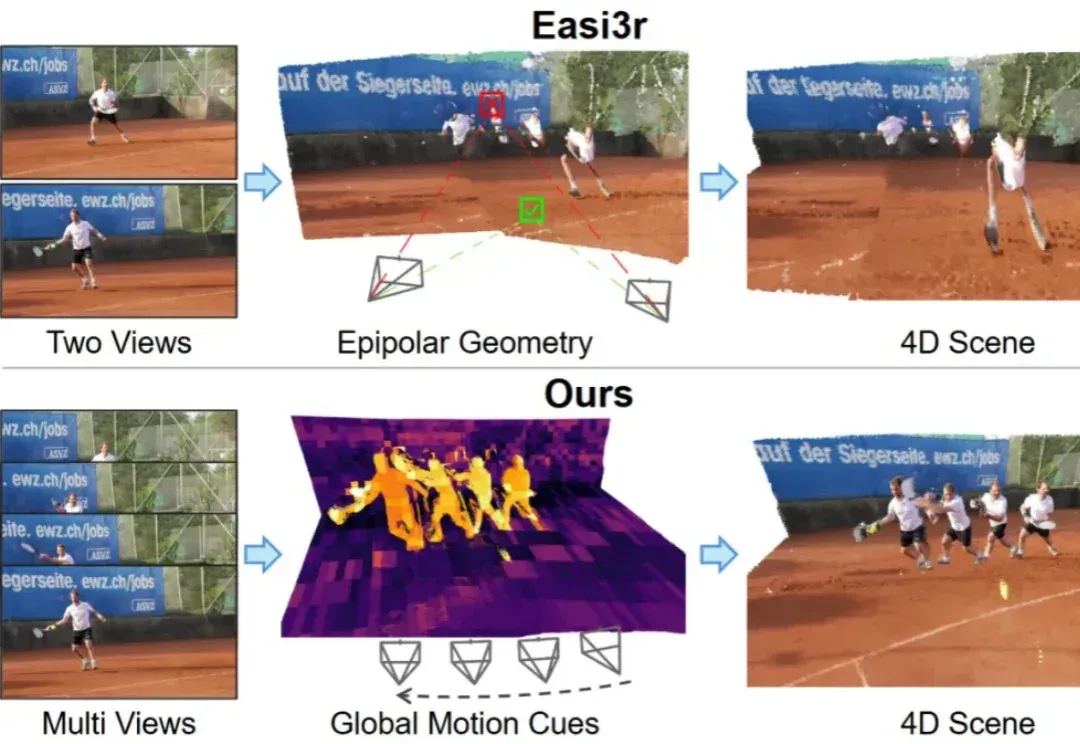
VGGT4D:无需训练,挖掘3D基础模型潜力,实现4D动态场景重建 (opens in a new tab)
如何让针对静态场景训练的 3D 基础模型(3D Foundation Models)在不增加训练成本的前提下,具备处理动态 4D 场景的能力?
Total 1000 articles
如何让针对静态场景训练的 3D 基础模型(3D Foundation Models)在不增加训练成本的前提下,具备处理动态 4D 场景的能力?
从 0 到上线,在OpenAI内部,安卓版 Sora经历的时间只有 28 天,而且期间只用了 2-3 名员工。
还在争论Skills是不是prompt?已经可以停下火了。因为,刚刚得到的消息消息,OpenAI已经悄悄地用上了Skills了。今天,知名博主、Django Web 框架联合创始人Simon Willson爆料:
主攻 AI 视频与多媒体生成技术的独角兽 Runway 也来了一波大的:一口气来了 5 个「激动人心的宣布」。这一波更新之猛,甚至让人觉得他们是不是把过去半年的大招一次性全放了出来。Runway 这一波发布,不仅刷新了视频生成的各项指标,更重要的是,他们正式对外展示了其在通用世界模型(General World Models/GWM)上的野心。
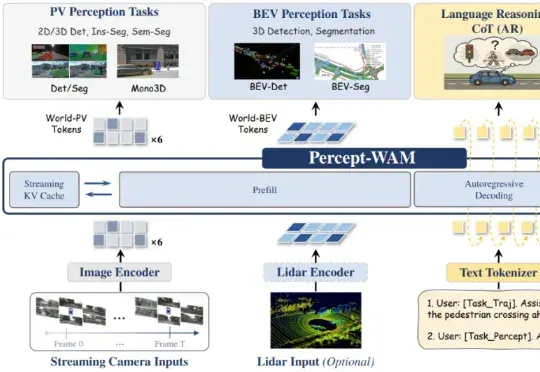
近日,来自引望智能与复旦大学的研究团队联合提出了一个面向自动驾驶的新一代大模型 ——Percept-WAM(Perception-Enhanced World–Awareness–Action Model)。该模型旨在在一个统一的大模型中,将「看见世界(Perception)」「理解世界(World–Awareness)」和「驱动车辆行动(Action)」真正打通,形成一条从感知到决策的完整链路。
上周,Sam Altman 罕见地按下了属于 OpenAI 的核按钮——「Code Red」(红色警报)。 这不仅仅是一个战术调整,更像是一场带着血腥味的「断臂求生」。Altman 的意思很明确:Sora?先停一停。那些酷炫但不赚钱的副业?全部靠边站。在未来八周内,全公司必须死磕一件事——让 ChatGPT 重新变得不可替代。
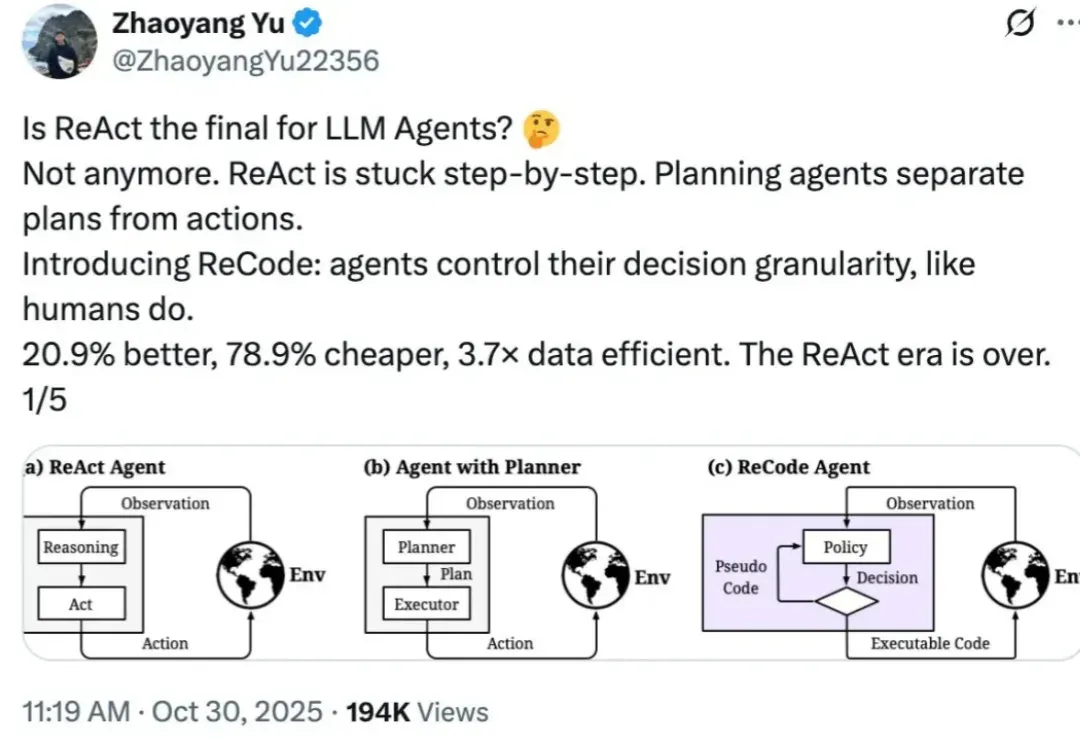
想象你在准备早餐:你不会先写一份详细到「左手抓鸡蛋、右手拿碗、手腕旋转 45 度敲击蛋壳」这样的清单,也不会只有一个笼统的计划叫「做个早餐」,然后不知所措。
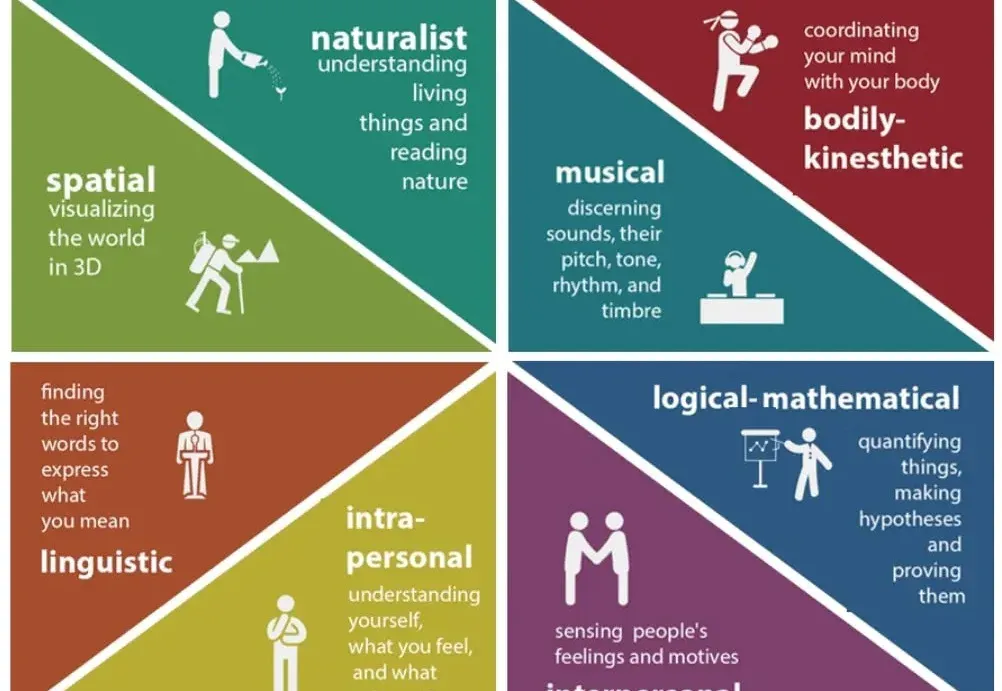
如今 LLM 的语言理解与生成能力已展现出惊人的广泛适用性,但随着 LLM 的发展,一个事实越发凸显:仅靠语言,仍不足以支撑真正的智能。
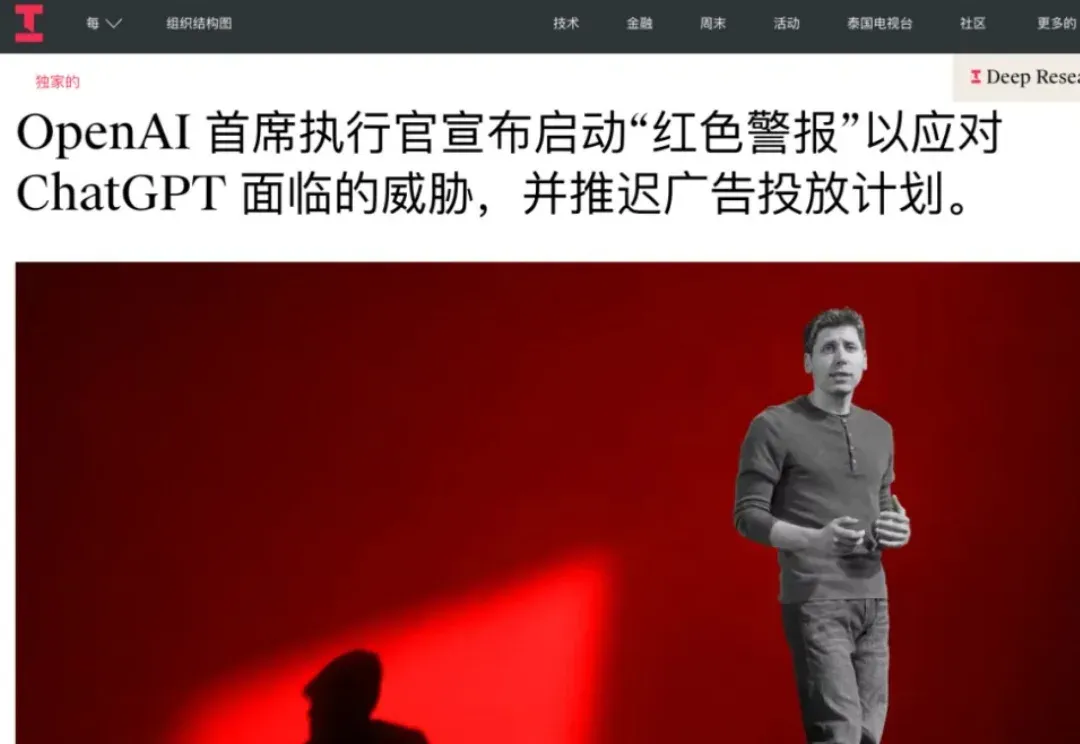
攻守之势异也,OpenAI 真急了。 就在刚刚,据 The Information 报道,OpenAI CEO Sam Altman 本周一直接在内部备忘录里宣布进入「红色警戒(code red)」状态,要调动更多资源狠狠提升 ChatGPT 的能力。 为啥这么急?还不是因为 Google 和一票 AI 竞争对手追得太紧了…… Altman 原话是这么说的:「我们正处在 ChatGPT 发展的关键时刻。」虽然没明说具体出了啥问题,但信号已经很明显了。 Google 今年秋天表示,自家的 Gemini 聊天机器人在用户活跃度上正在疯狂追赶。Altman 自己都在内部警告员工,Google 在 A
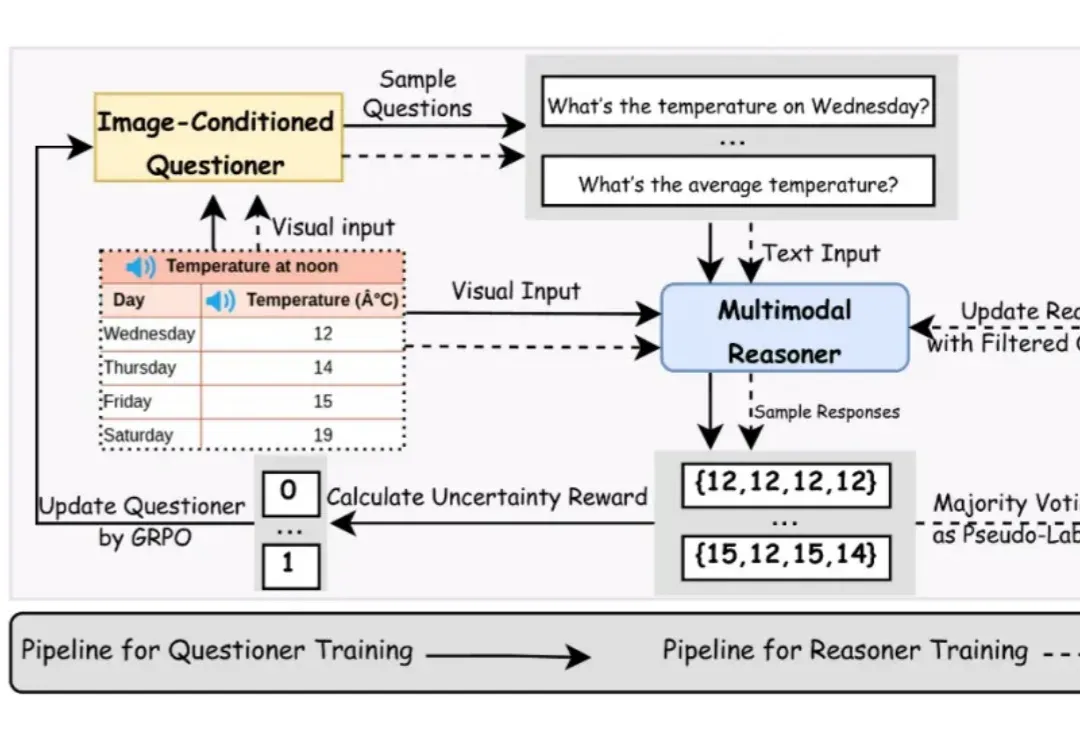
在 Vision-Language Model 领域,提升其复杂推理能力通常依赖于耗费巨大的人工标注数据或启发式奖励。这不仅成本高昂,且难以规模化。