阿里深夜开源80B编程模型!专攻智能体,周靖人、林俊旸最新成果发布 (opens in a new tab)
个人电脑也能跑出顶级编程智能体?今日凌晨,阿里开源了一款小型混合专家模型Qwen3-Coder-Next,专为编程智能体(Agent)和本地开发打造。该模型总参数80B,激活参数仅3B,在权威基准SWE-Bench Verified上实现了超70%的问题解决率,性能媲美激活参数规模大10-20倍的稠密模型。
Total 1000 articles
个人电脑也能跑出顶级编程智能体?今日凌晨,阿里开源了一款小型混合专家模型Qwen3-Coder-Next,专为编程智能体(Agent)和本地开发打造。该模型总参数80B,激活参数仅3B,在权威基准SWE-Bench Verified上实现了超70%的问题解决率,性能媲美激活参数规模大10-20倍的稠密模型。
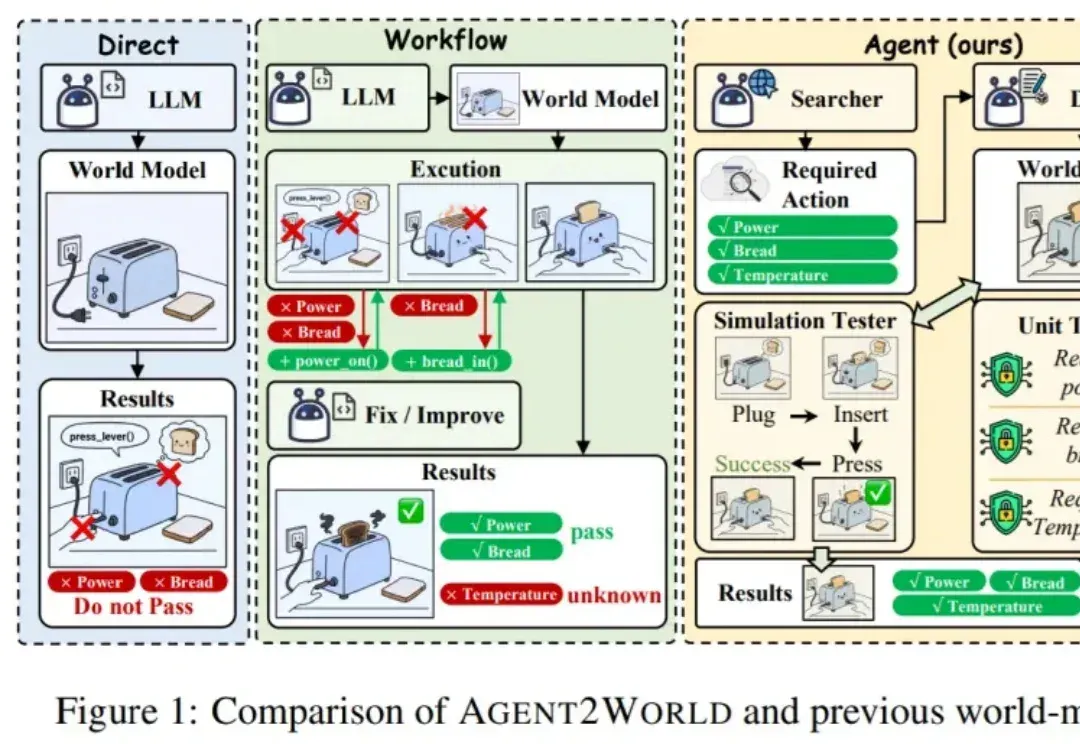
让模型真正 “能行动”,往往需要一个可执行、可验证的符号世界模型(Symbolic World Model):它不是抽象的文字描述,而是能被规划器或执行器直接调用的形式化定义 —— 例如 PDDL 领域 / 问题,或可运行的环境代码 / 模拟器。
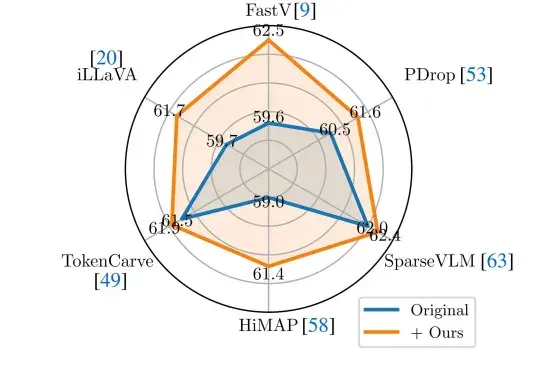
近年来,Vision-Language Models(视觉—语言模型)在多模态理解任务中取得了显著进展,并逐渐成为通用人工智能的重要技术路线。
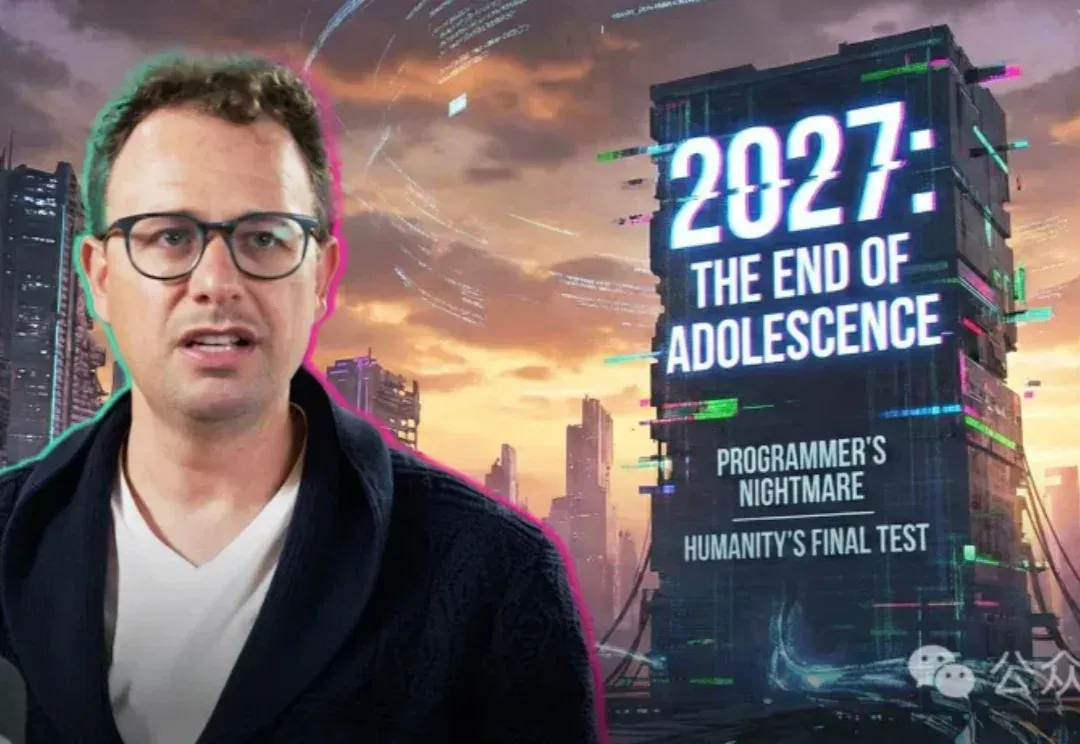
Anthropic 掌门人 Dario Amodei 发布核弹级预警:2027 年,人类将迎来「技术成年礼」。两万字长文冷静剖析AI失控、生物恐怖、极权统治及经济颠覆五大危机,拒绝末世论;提出以「宪法AI」、管制与民主协作构建防线,呼吁人类以勇气通过这场文明的「成年礼」。
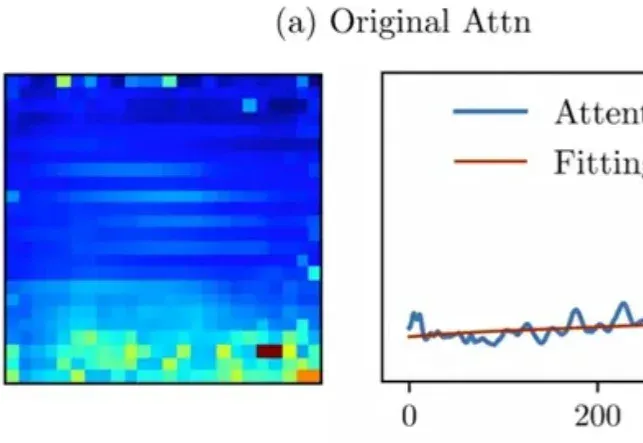
Attention真的可靠吗? 近年来,Vision-Language Models(VLMs)在多模态理解任务中取得了显著进展,尤其是在视觉问答、图像理解和视频理解等场景中,模型通常通过language-to-vision attention来衡量视觉token与文本之间的相关性,并据此进行visual token pruning,以降低推理成本、提升运行效率。 然而,一个长期被忽视的问题是:attention本身是否真的能够作为“语义重要性”的可靠指标? 在最新研究中,上海大学曾丹团队系统分析了主流VLM中attention的行为模式,发现一个关键却容易被忽略的现象——attention并
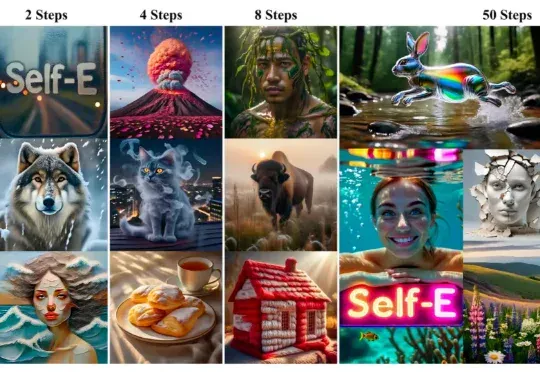
香港大学(The University of Hong Kong)与 Adobe Research 联合发布 Self-E(Self-Evaluating Model):一种无需预训练教师蒸馏、从零开始训练的任意步数文生图框架。其目标非常直接:让同一个模型在极少步数也能生成语义清晰、结构稳定的图像,同时在 50 步等常规设置下保持顶级质量,并且随着步数增加呈现单调提升。
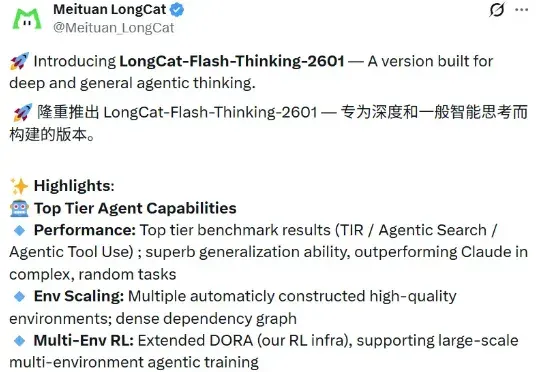
美团也重磅更新自家模型 ——LongCat-Flash-Thinking-2601。这是一款强大高效的大规模推理模型,拥有 5600 亿个参数,基于创新的 MoE 架构构建。该模型引入了强大的重思考模式(Heavy Thinking Mode),能够同时启动 8 路思考并最终总结出一个更全面、更可靠的结论。目前重思考模式已在 LongCat AI 平台正式上线,人人均可体验。
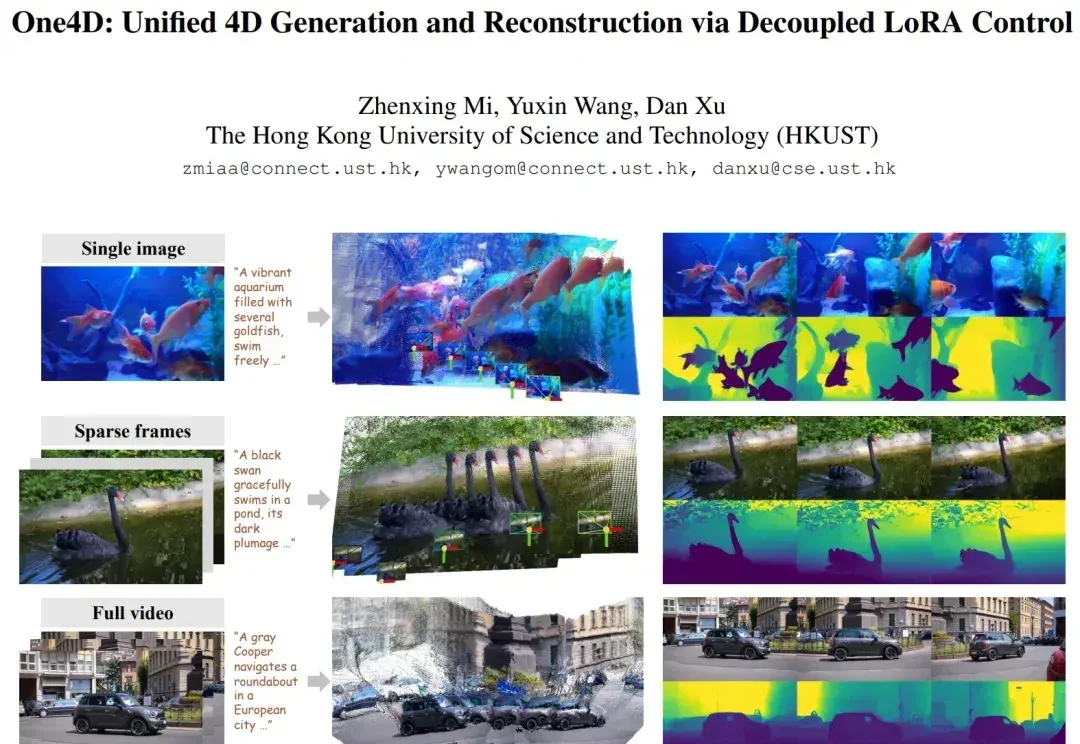
近年来,视频扩散模型在 “真实感、动态性、可控性” 上进展飞快,但它们大多仍停留在纯 RGB 空间。模型能生成好看的视频,却缺少对三维几何的显式建模。这让许多世界模型(world model)导向的应用(空间推理、具身智能、机器人、自动驾驶仿真等)难以落地,因为这些任务不仅需要像素,还需要完整地模拟 4D 世界。
CaveAgent的核心思想很简单:与其让LLM费力地去“读”数据的文本快照,不如给它一个如果不手动重启、变量就永远“活着”的 Jupyter Kernel。这项由香港科技大学(HKUST)领衔的研究,为我们展示了一种“Code as Action, State as Memory”的全新可能性。它解决了所有开发过复杂Agent的工程师最头疼的多轮对话中的“失忆”与“漂移”问题。
新年第一弹,OpenAI研发副总裁Jerry Tworek官宣离职,这位七年老兵给出的理由让人细思恐极:想做在OpenAI做不了的研究。从Dario Amodei出走创立Anthropic,到Ilya政变后离开,再到安全团队负责人摔门而出——OpenAI的核心大脑们正在以惊人的速度流失。