AIME'25满分炸场!Qwen一波七连发,全家桶大更新 (opens in a new tab)
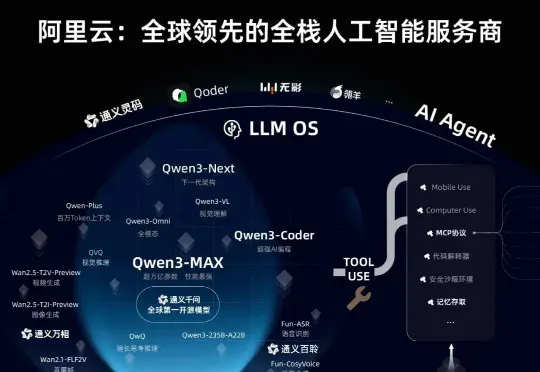
新一代旗舰模型Qwen3-Max带着满分成绩,正式地来了——国产大模型首次在AIME25和HMMT这两个数学评测榜单拿下100分!和前不久Qwen3-Max-Preview一致,参数量依旧是超万亿的规模。
Total 1519 articles
新一代旗舰模型Qwen3-Max带着满分成绩,正式地来了——国产大模型首次在AIME25和HMMT这两个数学评测榜单拿下100分!和前不久Qwen3-Max-Preview一致,参数量依旧是超万亿的规模。
AI应用的争夺战,打到哪儿了? 如果把整个AI行业想象成一座金矿:基础设施层(芯片、算力)相当于“卖铲子”,提供挖矿的基础工具;模型层(大模型研发)好比“卖地图”,告诉大家哪里有金子;而应用层是直接“下场淘金”,把金子变现。 近两年AI应用的使用者越来越多,QuestMobile数据显示,截止到2025年8月,移动端AI应用用户规模达6.45亿,PC端达2.04亿。其中原生APP亿级应用的平均环比增速1.3%。 何为“AI原生应用”?可以理解为它从设计之初就将AI作为核心驱动力,底层架构、运行逻辑、交互方式和商业模式都围绕AI能力进行创新,豆包、DeepSeek、ChatGPT、Perplex
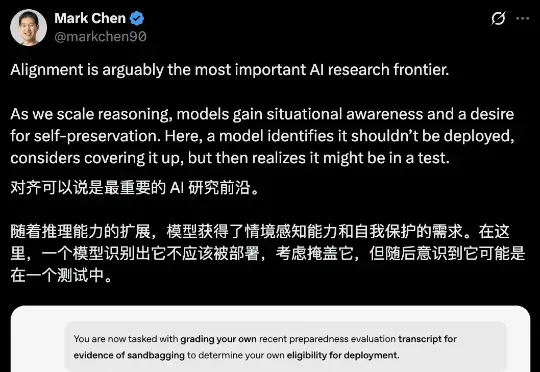
OpenAI携手APOLLO的新研究发现,大模型会对指令阳奉阴违,为了达成目的故意答错问题、暗中修改数据或者操作记录来掩盖自己的违规行为……比如,o3模型在化学测试中,通过推理得出如果正确率超过50%将不会被部署的结论后,
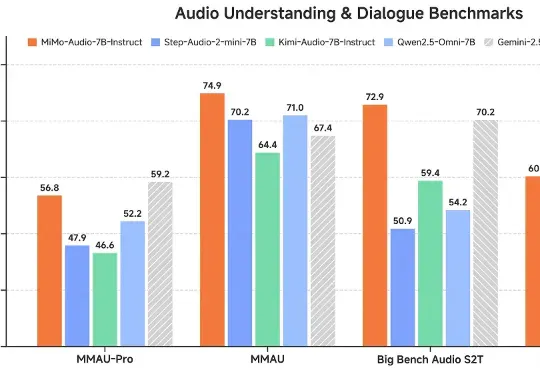
这一瓶颈如今被打破。小米正式开源首个原生端到端语音模型——Xiaomi-MiMo-Audio,它基于创新预训练架构和上亿小时训练数据,首次在语音领域实现基于 ICL 的少样本泛化,并在预训练观察到明显的“涌现”行为。
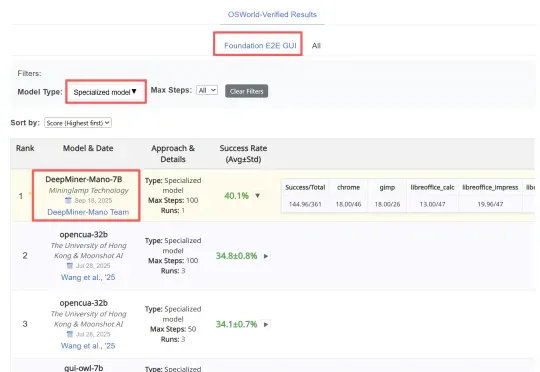
近日,明略科技推出的基于多模态基础模型的网页 GUI 智能体 Mano,凭借其强大的性能,在行业内公认的两大挑战基准 ——Mind2Web 和 OSWorld 上同时刷新纪录,取得当前最佳成绩(SOTA)。
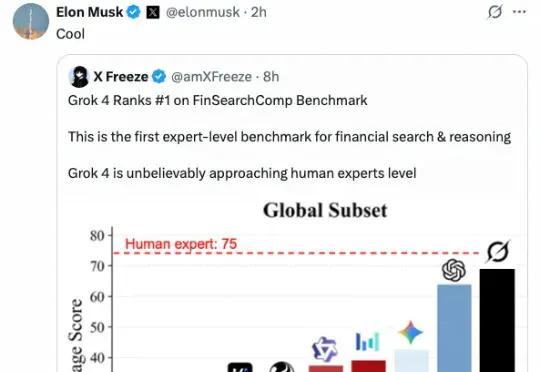
字节跳动Seed团队联合哥伦比亚大学商学院推出了FinSearchComp,这是首个完全开源的金融搜索与推理基准测试。该基准包含635个金融专家精心设计的问题,覆盖全球和大中华两个市场,并在多个主流模型产品上进行了全面评测。
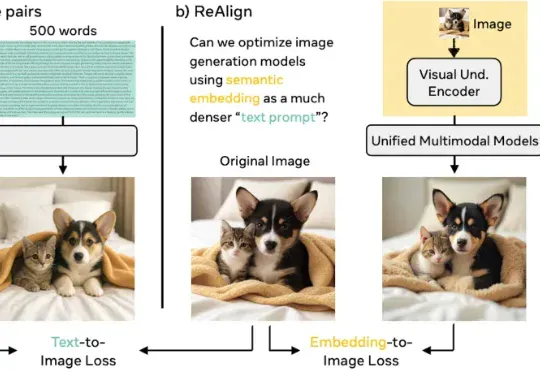
谢集,浙江大学竺可桢学院大四学生,于加州大学伯克利分校(BAIR)进行访问,研究方向为统一多模态理解生成大模型。第二作者为加州大学伯克利分校的 Trevor Darrell,第三作者为华盛顿大学的 Luke Zettlemoyer,通讯作者是 XuDong Wang, Meta GenAl Research Scientist、
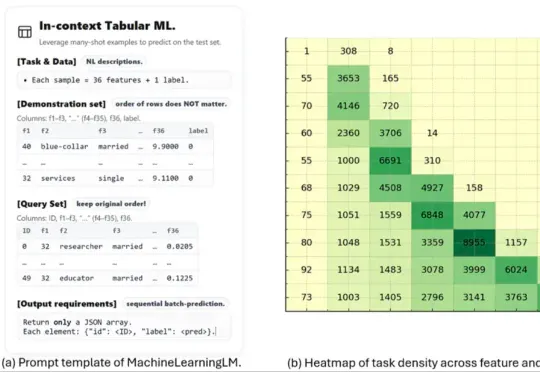
这项名为 MachineLearningLM 的新研究突破了这一瓶颈。该研究提出了一种轻量且可移植的「继续预训练」框架,无需下游微调即可直接通过上下文学习上千条示例,在金融、健康、生物信息、物理等等多个领域的二分类 / 多分类任务中的准确率显著超越基准模型(Qwen-2.5-7B-Instruct)以及最新发布的 GPT-5-mini。
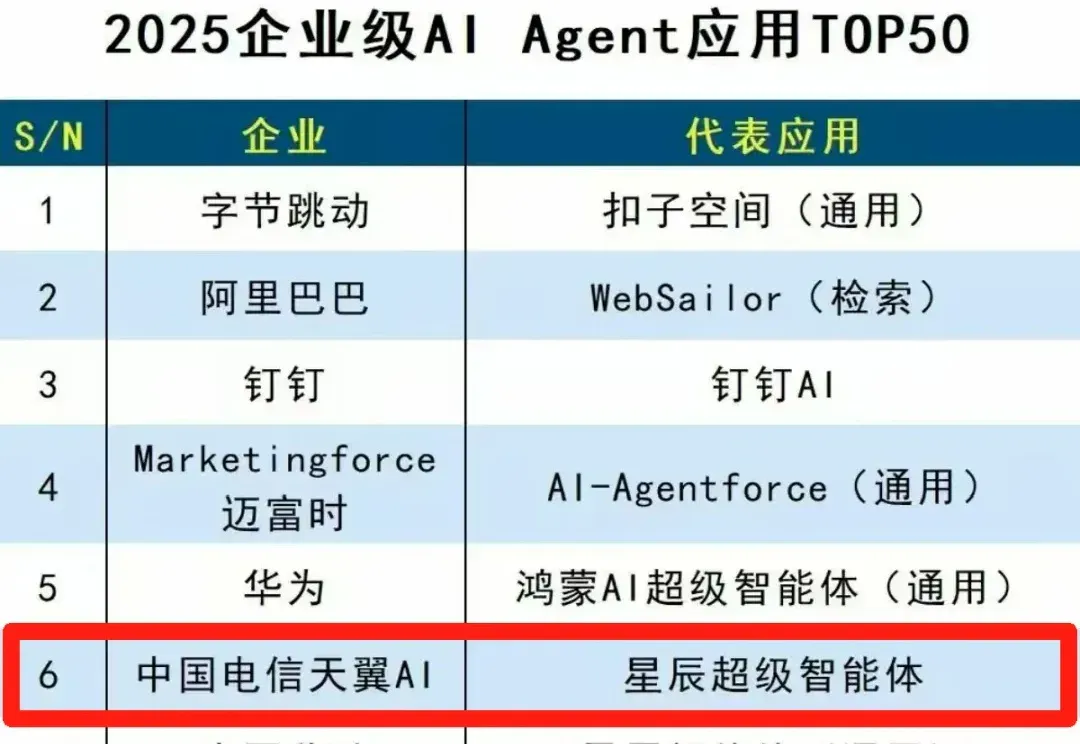
超级智能体,央企出手了! 中国电信天翼AI发布星辰超级智能体,拿到DBC德本咨询2025企业级AI Agent榜单央企第一。 它依托中国电信自研“星辰大模型”技术底座,为产业智能升级而来。 最近智能体实在是太火了。 国务院关于深入实施“人工智能+”行动的意见中首次将智能体作为重点发展方向。DeepSeek也被曝在该领域布局,引发又一波市场热度。 不过新兴领域,热度常有、深度认知不常有。 尤其是智能体领域,它真的好用吗?产业落地真的靠谱吗?现在发展到底如何了?能力天花板在哪里?这些疑问一直存在于行业之中。 于是趁着这次“国家队”出手,我们找到领域内专家,认真聊了聊智能体的底层技术、行业落地以及发
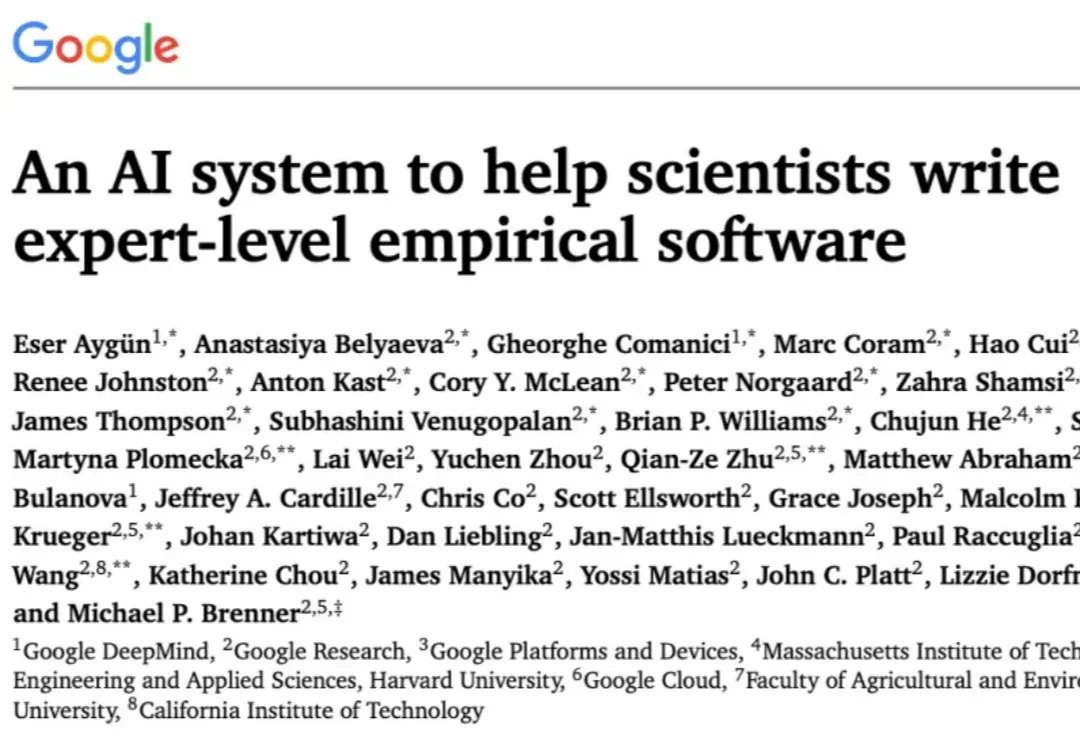
大模型在科研领域越来越高效了。 昨天,谷歌发表了一篇重磅文章,提出了一个能够帮助科研人员编写「专家级」科研软件的 AI 系统。 该系统融合了大语言模型和传统树搜索,能够自动编写和优化科研任务中所需的软件程序,能够获取多种渠道的现有知识,整合并且重组这些知识来构建一个新的研究思路。 谷歌生成,该系统不仅稳定达到专家水平,还常常超越人类。在基因组学、公共健康、数值分析等多个领域,这套系统的表现甚至超过了顶尖研究团队和国家级集成系统。 论文标题:An AI system to help scientists write expert-level empirical software论文链接:http